
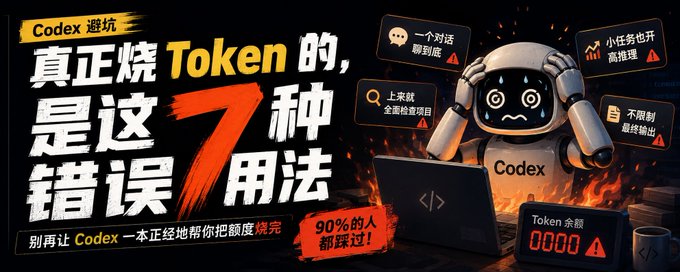
我用 Codex 烧掉不少 Token 后,改掉了这 7 个习惯
我以前一直觉得 Codex 吃额度。
直到有几次任务只改了一行代码,我回头看过程才发现:它读了半个仓库,围着同一个问题推理了几轮,收尾还写了一份没人看的长总结。
代码没改多少,流程却跑得很远。
下面这 7 个习惯,我几乎全踩过。现在我会在开始前框住范围,做完就让它停。
先把口径说清楚。
Token 是模型读写信息的单位。使用 ChatGPT 账号登录 Codex 时,Token 消耗会折算成套餐用量或 credits;使用 API Key 时,则按 API Token 计费。
提示词、文件、聊天记录、工具结果和回复都会使用 Token,实际消耗还受模型、上下文、推理等级和工具影响。OpenAI 的用量说明
1. 一个对话用到底
我以前不愿意开新对话。
Codex 已经看过项目,继续聊似乎更省事。
问题是,对话会不断积累旧需求、废弃方案、失败日志和临时判断。它们当时有用,留到后面却可能把真正重要的信息埋住。
OpenAI 现在的建议很具体:一个对话对应一项连贯的工作。同一个问题还没解决,留在原对话通常更好;工作真正分叉时再 Fork。
CLI 对话变长后,可以用 /compact把早期内容压成摘要,减少后续需要携带的上下文。Codex 也会自动做压缩。
不过,/compact 不会返还已经消耗的用量。
现在如果要另开对话,我只带走当前目标、已经完成的内容、相关文件、最新报错和完成标准。其余历史,需要时再回去查。
2. 把 AGENTS.md 写成项目百科
AGENTS.md 适合放长期有效的项目规则。我以前却很容易把它写成项目日记:背景、部署记录、旧 Bug、临时要求,越积越多。
Codex 启动时会自动构建项目指令链。
按照官方文档,它会读取全局指令,再从项目根目录一路读到当前工作目录;越靠近当前目录的规则,优先级越高。
自动发现并合并的项目指令受 project_doc_max_bytes 限制,默认值是 32 KiB。这里的单位是字节,而且可以配置,不是模型的 Token 上限。
32 KiB 是上限,不是目标。
我只在里面保留项目结构、启动和测试命令、工程约束、禁止事项,以及验收方式。临时需求、单次报错、已经放弃的方案,解决后就删。
某个模块独有的规则,则放在更靠近那个模块的 AGENTS.md 里。
我把它当工作纪律,不再当项目日记。
3. 每次都粘贴同一段长提示词
代码审查贴一遍,CI 排障贴一遍,发布前检查再贴一遍。
同一套流程如果一直手动复制,那些操作说明也会跟着每个任务重新进入上下文。
我现在这样分:
- 只对这次任务有效的要求,留在当前提示词。
- 长期项目规则,放进 AGENTS.md。
- 会反复执行的完整流程,做成 Skill。
Skill 的官方文档说明,它可以打包操作步骤、参考资料和脚本,并采用渐进式加载。
未触发时,Codex 主要根据一份受预算限制的初始清单,看到 Skill 的名称、描述和路径。决定使用后,才会读取完整的 SKILL.md。安装的 Skill 太多时,部分描述可能被缩短,有些 Skill 也可能不出现在初始清单里。
触发 Skill 后,完整说明仍会进入上下文。它的价值是复用流程、稳定执行,以及避免无关说明过早加载,并不保证单次任务一定比粘贴同等长度的提示词更省。
所以我不会为一句小提示单独做一个 Skill,描述也尽量写得短而明确。
4. 小改动也开高推理
改按钮文案,开高推理。
找一个变量,还是高推理。
最后像是在为一个按钮制定五年发展战略。
OpenAI 的模型说明写得很清楚:提高推理等级可能改善复杂任务的结果,但会花更长时间,也会使用更多 Token。建议从默认档开始,任务确实需要更深入的规划或分析时再提高。
范围清楚的文案修改、格式调整、查找替换和数据提取,我通常使用默认档或较低档。
跨模块 Bug、复杂重构、架构选择,或者需要反复检查边界条件的任务,再往上调。
实际选择时,我会使用能够稳定完成这类任务的最低推理等级。
5. 小任务也叫来一群子智能体
“开 5 个 Agent,全面分析一下。”
听起来像组了一支技术团队。
可如果 5 个 Agent 都读一遍项目,再交回几份差不多的结论,等待时间也许缩短了,用量不会跟着变少。
Codex 的子智能体文档明确说明:每个子智能体都会独立进行模型和工具工作。因此,在可比的任务里,子智能体工作流会比单智能体消耗更多 Token。
我只在任务能够拆成独立、边界清楚的部分时使用它。例如分别检查安全问题、测试缺口、日志和陌生模块。
修改同一个文件、排查一个明确报错,或者每一步都依赖上一步时,一个 Agent 往往更合适。
子智能体可以减少等待时间,前提是这些工作真的能够并行。
6. 上来就让它“全面检查整个项目”
我现在最警惕的一句话是:
帮我全面检查一下这个项目。
它没有告诉 Codex 检查什么、从哪里开始、哪些目录不用看,也没有定义什么结果算完成。
Codex 通常只能先搜索、读取和推断,再逐步排除无关内容。
OpenAI 的提示建议给了一个很好用的四部分结构:目标、上下文、限制、完成标准。
它不要求你把提示词写成论文,只要把任务边界交代清楚。
所以,“全面检查登录功能”会被我改成:
只排查登录后返回 401;优先查看 src/auth/login.ts、src/api/session.ts 和当前报错;跳过 node_modules、dist 及无关页面;定位原因后做最小修改,并运行登录相关测试。
正确账号能登录、测试通过、没有改动无关功能,任务才算结束。
这段提示词虽然字数更多,却缩小了搜索和推断范围。它不保证每次都能降低总用量,因为实际消耗还取决于模型、上下文、工具调用和缓存,但至少不会让 Codex 先在整个项目里猜入口。
能够直接 @ 相关文件时,我也会把文件带进提示词。
7. 事情做完了,还让它写一份结题报告
代码改完,测试通过,Codex 继续解释背景、原理、方案、风险和后续建议。
真正要看的,往往只有改了什么、验证过没有,以及还剩什么问题。
最终回复同样计入 output tokens,并会影响套餐用量或 API 费用。
需要事故复盘或团队交接时,长报告当然有用。普通小修没必要默认写到这个长度。
我会提前限定最终回答,只保留四项:原因、修改文件、验证结果、未解决问题。
不要重复需求,不讲基础知识,验证完成后停止。
我现在常用的短模板
只处理下面的问题,不扩展范围。 目标: [要解决的问题或要实现的行为] 上下文: 优先查看 [文件、代码、报错或文档]。 不要扫描 [无关目录]。 约束: 先定位原因,再做最小修改。 不要顺手重构;修改后运行 [相关测试]。 完成标准: [问题不再复现],并且 [相关测试通过]。 完成后只报告: - 原因 - 修改文件 - 验证结果 - 未解决问题 验证完成后停止。
这段适合边界清楚的小任务。
如果需求复杂、含糊,或者涉及多步权衡,OpenAI 建议先用 Plan 模式,让 Codex 收集上下文、提出澄清问题并形成计划,再开始实现。可以使用 /plan 或 Shift+Tab 进入。
Plan 模式本身也会使用 Token,不能保证单次任务一定更省。它的价值是先把方向和边界弄清楚,减少做错方向后的返工。
我现在不再为了省用量,删掉提示词里的十几个字。
开始前,我会先确定需要保留多少旧上下文、允许搜索哪些地方、任务需要什么推理等级,以及最后到底要交付什么。
这样用下来,无关文件读得少了,来回解释也少了。我也不用再从一篇技术白皮书里找那一行真正改过的代码。
你最常踩的是哪一个?如果还有第 8 个,我也想补进这份清单。