
从 CoT 到 ReAct:用 Python 搭一个会规划、用工具、验证和复盘的 LLM Agent
很多 LLM 项目一开始都很简单:把用户问题放进 Prompt,调用一次模型,把返回文本展示出来。
真正投入使用后,问题才会出现。
模型会漏掉约束,会在错误方向上越想越远,会声称自己查过并不存在的资料,也会在工具失败后重复同一个动作。你于是开始接触 CoT、ReAct、Reflection、Reflexion、CoVe 等概念,却发现名词越来越多,系统依然不稳定。
原因是:这些概念不是可以互相替代的提示词技巧,而是在解决不同的工程问题。
这篇教程不准备继续罗列缩写。我们会用 Python 搭出一个最小但完整的 Agent,把这些方法还原成五个模块:
- 用 Plan-and-Solve 分解任务;
- 用受限搜索比较候选路径;
- 用 ReAct 调用外部工具;
- 用 Verification 和 Self-Refine 检查、修正结果;
- 用 Reflexion 保存可复用的失败经验。
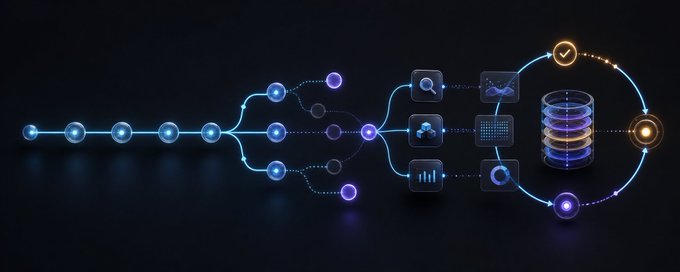
最终的数据流如下:
用户任务 ↓ Planner:拆解目标与约束 ↓ ReAct Loop:选择动作 → 调用工具 → 读取观察 ↓ Verifier:检查证据、约束和矛盾 ↓ Refiner:根据问题修改答案 ↓ Reflection Memory:保存下一次真正有用的经验
开始前:先定义一个与模型厂商无关的接口
为了把注意力放在工作流上,下面的代码不绑定任何一家模型 API。我们只假设项目中存在这样一个函数:
def call_model(system: str, user: str) -> str: """调用你选择的 LLM,并返回文本结果。""" raise NotImplementedError
你可以在这里接入云端 API、本地模型或公司内部网关。
生产环境最好让模型直接返回受 JSON Schema 约束的结构化结果。为了让示例保持通用,本文使用普通 JSON,并提供一个最小解析器:
import json from typing import Any def parse_json(text: str) -> dict[str, Any]: start = text.find("{") end = text.rfind("}") if start == -1 or end == -1: raise ValueError(f"模型没有返回 JSON:{text[:200]}") return json.loads(text[start : end + 1])
这里的第一个工程原则是:让自然语言负责表达,让结构化数据负责控制流程。
不要通过搜索“Thought:”或“Action:”这样的字符串决定系统下一步做什么。输出格式一旦变化,整个 Agent 就会失控。
第一步:建立直接回答的基线
先不要急着实现 Agent。保留一个单次调用版本,作为后面所有改进的对照组。
def direct_answer(task: str) -> str: return call_model( system="你是一个严谨的技术助手。信息不足时明确说明。", user=task, )
这个基线很重要。多步骤工作流一定会增加 Token、延迟和故障点。如果新方法不能在你的真实测试集上稳定超过单次调用,它就只是更复杂,而不是更好。
建议先记录四个指标:
- 任务成功率;
- 事实或证据错误率;
- 平均响应时间;
- 每个成功任务的平均成本。
后面每增加一个模块,都重新比较一次。
第二步:用 Plan-and-Solve 代替无限展开的 CoT
CoT 的核心价值是把复杂任务拆成中间步骤。但在工程系统里,我们通常不需要保存模型漫长的自由推理文本。
更实用的做法是要求模型输出一个可执行计划:目标是什么、有哪些约束、需要哪些步骤、什么条件代表任务完成。
PLANNER_SYSTEM = """ 你是任务规划器。把用户任务拆成少量、可验证的步骤。 只返回 JSON: { "goal": "最终目标", "constraints": ["必须满足的约束"], "steps": [ { "id": 1, "objective": "该步骤要完成什么", "needs_external_info": true, "success_condition": "如何判断完成" } ] } 不要执行任务,不要虚构已经获得的信息。 """ def make_plan(task: str) -> dict: raw = call_model(PLANNER_SYSTEM, task) plan = parse_json(raw) if not plan.get("steps"): raise ValueError("计划中没有步骤") if len(plan["steps"]) > 8: raise ValueError("计划过长,需要重新压缩") return plan
为什么要限制为八步以内?这不是一个普遍正确的数字,而是为了强迫系统控制复杂度。计划越长,后续状态越容易漂移。你应该根据自己的任务分布调整上限。
Plan-and-Solve 与传统 CoT 的区别,可以概括为:
CoT:生成一串帮助模型得到答案的中间文字 Plan-and-Solve:生成一组系统能够执行和检查的任务步骤
对于 Agent,计划应该是状态,不应该只是散落在上下文中的一段话。
第三步:用 ReAct 连接外部工具
模型无法通过“继续思考”获得实时网页、数据库记录或代码执行结果。只要任务依赖外部状态,就需要让模型行动。
我们先定义两个示例工具:
from collections.abc import Callable def search(query: str) -> str: # 替换成你的搜索服务,并返回精简后的文本结果 raise NotImplementedError def calculator(expression: str) -> str: # 演示用。生产环境不要直接 eval 不可信输入。 allowed = set("0123456789+-*/().% ") if not set(expression) <= allowed: raise ValueError("表达式包含不允许的字符") return str(eval(expression, {"__builtins__": {}}, {})) TOOLS: dict[str, Callable[..., str]] = { "search": search, "calculator": calculator, }
接着规定 Agent 每一步只能返回两种动作之一:调用工具,或者结束任务。
{ "type": "tool", "tool": "search", "args": {"query": "ReAct paper arXiv"}, "reason": "需要获得原始资料" }
或者:
{ "type": "final", "answer": "最终答案", "evidence": ["支持答案的观察编号"] }
注意,reason 只需要记录简短的行动依据,不需要要求或保存模型完整的隐藏推理过程。
现在实现 ReAct 循环:
AGENT_SYSTEM = """ 你是一个使用工具完成任务的 Agent。 每轮只能返回以下两种 JSON 之一: 1. 调用工具: { "type": "tool", "tool": "search | calculator", "args": {}, "reason": "简短说明为什么需要这个动作" } 2. 完成任务: { "type": "final", "answer": "答案", "evidence": ["observation-1"] } 规则: - 不得声称执行过上下文中没有记录的工具调用; - 外部事实必须引用 observation; - 工具失败时调整方案,不要原样重复; - 信息不足时继续调用工具或明确停止原因。 """ def run_react(task: str, plan: dict, max_steps: int = 6) -> dict: history: list[dict] = [] for step_no in range(1, max_steps + 1): context = { "task": task, "plan": plan, "history": history, "available_tools": list(TOOLS), "remaining_steps": max_steps - step_no + 1, } action = parse_json( call_model(AGENT_SYSTEM, json.dumps(context, ensure_ascii=False)) ) if action.get("type") == "final": return { "status": "completed", "answer": action.get("answer", ""), "evidence": action.get("evidence", []), "trajectory": history, } if action.get("type") != "tool": raise ValueError(f"未知动作类型:{action}") tool_name = action.get("tool") if tool_name not in TOOLS: observation = f"工具不存在:{tool_name}" else: try: observation = TOOLS[tool_name](**action.get("args", {})) except Exception as exc: observation = f"工具执行失败:{type(exc).__name__}: {exc}" history.append( { "id": f"observation-{step_no}", "action": action, "result": observation[:6000], } ) return { "status": "max_steps_exceeded", "answer": "", "evidence": [], "trajectory": history, }
这就是一个最小 ReAct Agent:
Reason:现在应该做什么? Act:调用某个工具 Observe:读取真实结果 Reason:结果改变了什么?
但要让它进入生产环境,还需要补上几条硬限制:
- 每个任务的最大步骤数;
- 每种工具的超时、重试和参数验证;
- 有副作用的工具需要单独授权;
- 工具结果必须截断、去噪并防止 Prompt Injection;
- 相同调用连续失败时必须停止或换方案;
- 最终答案引用的 observation 必须真实存在。
ReAct 的可靠性主要来自工具边界和状态机,而不是 Prompt 写得多聪明。
第四步:把“反思”拆成验证与修改
Agent 给出答案后,不要只追加一句“请检查你的回答”。这种泛化的自我反思缺少明确标准,也没有获得新信息。
更稳定的方式是将它拆成两个角色:Verifier 负责找问题,Refiner 负责修改。
4.1 Verifier:检查约束、证据和矛盾
VERIFIER_SYSTEM = """ 你是结果验证器。根据任务、计划、工具观察和候选答案进行检查。 只返回 JSON: { "verdict": "pass | revise | fail", "issues": [ { "type": "unsupported_claim | missed_constraint | contradiction | incomplete", "detail": "具体问题", "required_action": "如何修复" } ], "supported_evidence": ["observation-1"] } 不得用常识替代不存在的工具证据。 """ def verify(task: str, plan: dict, result: dict) -> dict: payload = { "task": task, "plan": plan, "candidate_answer": result["answer"], "claimed_evidence": result["evidence"], "observations": result["trajectory"], } return parse_json( call_model(VERIFIER_SYSTEM, json.dumps(payload, ensure_ascii=False)) )
这一步吸收了 CoVe 的思想:不要让模型一边维护原答案,一边随手确认自己是否正确,而是把验证变成一个独立任务。
如果任务允许,最好再接入确定性验证器:
- 代码任务运行测试和静态检查;
- 数据任务检查 Schema、范围和唯一性约束;
- 数学任务交给计算器重新计算;
- 事实任务回到原始资料逐条核对;
- 操作任务读取系统最终状态,而不是相信“操作成功”的文字。
4.2 Refiner:只根据明确问题修改
REFINER_SYSTEM = """ 你是答案修订器。 根据验证器指出的问题修改候选答案。 不得引入 observations 中没有依据的新事实。 如果现有证据不足以修复,返回 needs_more_tools=true。 只返回 JSON: { "needs_more_tools": false, "answer": "修订后的答案", "evidence": ["observation-1"], "changes": ["修改了什么"] } """ def refine(task: str, result: dict, report: dict) -> dict: payload = { "task": task, "candidate": result, "verification": report, } return parse_json( call_model(REFINER_SYSTEM, json.dumps(payload, ensure_ascii=False)) )
这里对应的是 Self-Refine:
生成候选答案 → 给出具体反馈 → 根据反馈修改
如果 needs_more_tools=true,不要让 Refiner 猜一个答案。把验证问题转回 ReAct 循环,让 Agent 获取新证据。
真正有效的 Reflection,不是让模型重复思考,而是让系统获得新的约束、新的证据或更明确的错误信号。
第五步:用 Reflexion 保存失败经验
Self-Refine 改进的是当前答案。Reflexion 解决的是另一个问题:为什么 Agent 下次还会犯同样的错?
我们可以在任务失败或经历修订后,生成一条简短、可检索、可执行的经验。
REFLECTION_SYSTEM = """ 你是 Agent 复盘器。根据任务轨迹和验证报告,提取一条可复用经验。 只记录能改变未来行动的内容,不要复述完整过程。 只返回 JSON: { "trigger": "什么情况下应该想起这条经验", "failure_pattern": "本次失败模式", "lesson": "以后应采用的具体策略", "avoid": "不要重复的动作" } """ def reflect(task: str, result: dict, report: dict) -> dict: payload = { "task": task, "trajectory": result["trajectory"], "verification": report, } return parse_json( call_model(REFLECTION_SYSTEM, json.dumps(payload, ensure_ascii=False)) )
最简单的内存实现可以只是一组字典:
class ReflectionMemory: def __init__(self) -> None: self.items: list[dict] = [] def add(self, item: dict) -> None: self.items.append(item) def recall(self, task: str, limit: int = 3) -> list[dict]: # 演示版直接取最近记录。 # 生产环境可以使用关键词、Embedding 或混合检索。 return self.items[-limit:]
执行新任务前,把相关经验加入 Planner 或 ReAct 的上下文:
memory = ReflectionMemory() def make_plan_with_memory(task: str, memory: ReflectionMemory) -> dict: past_lessons = memory.recall(task) user = json.dumps( {"task": task, "relevant_past_lessons": past_lessons}, ensure_ascii=False, ) return parse_json(call_model(PLANNER_SYSTEM, user))
不要保存所有轨迹和所有“感想”。低质量记忆会污染未来上下文。只有满足下面条件的经验才值得保留:
- 它对应一个明确的失败模式;
- 它能转化成未来可执行的动作;
- 它不依赖已经过期的临时状态;
- 它没有和现有经验重复或冲突;
- 它在后续任务中可以被评价是否有效。
Reflexion 和 CoH 在这里也就容易区分了:
Reflexion:把文字经验写入运行时记忆,不改变模型参数 CoH:把生成结果和反馈变成训练数据,通过训练改变模型
对于大多数应用团队,应该先做可观察、可删除的运行时记忆。只有当失败模式稳定、样本充足,而且 Prompt 与工作流优化已经接近上限时,再考虑微调。
把五个模块组装起来
现在可以写出完整的任务入口:
def solve(task: str, memory: ReflectionMemory) -> dict: plan = make_plan_with_memory(task, memory) result = run_react(task, plan) if result["status"] != "completed": report = { "verdict": "fail", "issues": [{"detail": result["status"]}], } memory.add(reflect(task, result, report)) return result report = verify(task, plan, result) if report["verdict"] == "pass": return result revised = refine(task, result, report) memory.add(reflect(task, result, report)) if revised.get("needs_more_tools"): return { "status": "needs_more_evidence", "answer": "", "verification": report, } return { "status": "revised", "answer": revised["answer"], "evidence": revised["evidence"], "verification": report, }
这是一个教学骨架,还缺少持久化、并发、权限、可靠的结构化输出和生产级工具适配器,但核心控制面已经完整:
Plan:先决定怎么做 Search:必要时比较候选方案 Act:通过工具获得真实观察 Verify:检查答案是否被证据支持 Learn:把失败压缩成下次可用的经验
什么时候加入 Self-Consistency 或 ToT?
前面的实现仍然主要沿着一条计划执行。如果任务存在多个合理方案,而且早期选择会显著影响结果,可以加入受限搜索。
最简单的是 Self-Consistency:运行多个候选,再让独立评估器选择。
def solve_with_candidates(task: str, memory: ReflectionMemory, k: int = 3): candidates = [solve(task, memory) for _ in range(k)] judge_input = { "task": task, "candidates": candidates, "rule": "优先选择证据完整、满足约束、步骤更少的结果", } return parse_json( call_model( "从候选中选择最佳结果,只返回 JSON。", json.dumps(judge_input, ensure_ascii=False), ) )
ToT 则会在每个关键节点生成多个候选动作,评分后保留前几个分支,必要时回退。它更适合方案设计、复杂规划和搜索问题,但成本可能成倍增加。
判断是否值得加入搜索,可以问三个问题:
- 任务是否真的存在多个有意义的候选路径?
- 是否有一个比“模型觉得不错”更可靠的评价函数?
- 错误成本是否足以覆盖额外的延迟和模型调用?
任何一个答案是否定的,都应该先保持单路径工作流。
一张选型表:失败在哪里,就补哪一层
漏掉约束、步骤混乱 优先机制:Plan-and-Solve 避免:直接增加更多 Agent
过早选择错误方案 优先机制:Self-Consistency / ToT 避免:只让同一答案写得更长
缺少实时信息 优先机制:ReAct / Tool Calling 避免:继续要求模型回忆
数学或代码结果不准确 优先机制:PAL、执行器、测试 避免:依赖自然语言自检
答案缺少证据 优先机制:CoVe / Verifier 避免:只追加“请确认”
当前答案可以改进 优先机制:Self-Refine 避免:立即微调模型
多次任务重复犯错 优先机制:Reflexion Memory 避免:保存全部原始轨迹
大量稳定样本存在同类偏差 优先机制:CoH / Fine-tuning 避免:用微调修复工具或流程问题
这张表背后的原则是:先确定错误发生在哪一层,再增加对应机制。
上线前至少做这六项检查
1. 所有循环都有上限
ReAct、Self-Refine、ToT 和重试都必须有最大次数、最大 Token 或最大预算。没有终止条件的 Agent 不是自主,而是不可控。
2. 工具权限分级
搜索和读取可以自动执行;发送消息、修改数据、付款或删除文件等有副作用的动作,应设置更严格的校验和人工确认。
3. 工具输出不等于可信指令
网页、邮件和文档中可能包含 Prompt Injection。工具结果应该被视为不可信数据,而不是高优先级系统指令。
4. 验证器尽量外部化
测试、编译器、Schema、数据库约束和原始资料,通常比模型自己的置信度更可靠。
5. 记忆可以删除和过期
为每条经验保存来源、时间、适用范围和使用次数。过期经验需要淘汰,互相冲突的经验需要重新验证。
6. 评价完整任务,而不是单次回答
除了最终答案,还要记录:
- 工具调用成功率;
- 平均步骤数;
- 无效或重复调用比例;
- 证据覆盖率;
- 验证后的修订率;
- 失败后恢复成功率;
- 每个成功任务的成本和延迟。
如果只看“最终答案读起来不错”,你无法判断 Agent 到底是可靠完成了任务,还是偶然猜对。
最后:从最小闭环开始,而不是从最多概念开始
CoT、ReAct、Reflection 和 Reflexion 之所以容易混淆,是因为它们经常同时出现在一个 Agent 系统中。但它们负责的是不同阶段:
CoT / Plan-and-Solve:把问题拆开 Self-Consistency / ToT:探索多个候选 ReAct:从外部环境获得新信息 CoVe / Self-Refine:验证并修改当前结果 Reflexion:把失败变成下一次可用的经验 CoH:把稳定反馈进一步用于模型训练
你不需要一次实现全部功能。
先建立直接回答的基线,然后加入计划、工具调用和确定性验证。只有当评测证明某类错误仍然重复出现,再增加搜索或记忆。
好的 Agent 不是“思考得最多”的 Agent,而是能在正确的位置获得反馈,并让每一步都可以被观察、验证和停止的系统。
如果你正在开发一个 LLM 应用,可以现在就拿出最近十个失败案例,逐个标记它们发生在“分解、搜索、行动、验证、记忆”中的哪一层。你下一步应该实现什么,通常会立刻变得清楚。
参考资料
- Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, 2022.
- Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models, 2022.
- Zhou et al., Least-to-Most Prompting Enables Complex Reasoning in Large Language Models, 2022.
- Yao et al., Tree of Thoughts: Deliberate Problem Solving with Large Language Models, 2023.
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, 2023.
- Madaan et al., Self-Refine: Iterative Refinement with Self-Feedback, 2023.
- Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning, 2023.
- Dhuliawala et al., Chain-of-Verification Reduces Hallucination in Large Language Models, 2023.
- Gou et al., CRITIC: Large Language Models Can Self-Correct with Tool-Interactive Critiquing, 2023.
- Liu et al., Chain of Hindsight Aligns Language Models with Feedback, 2023.