
超越Opus?Kimi K3 最完全实测
Kimi K3 来了。
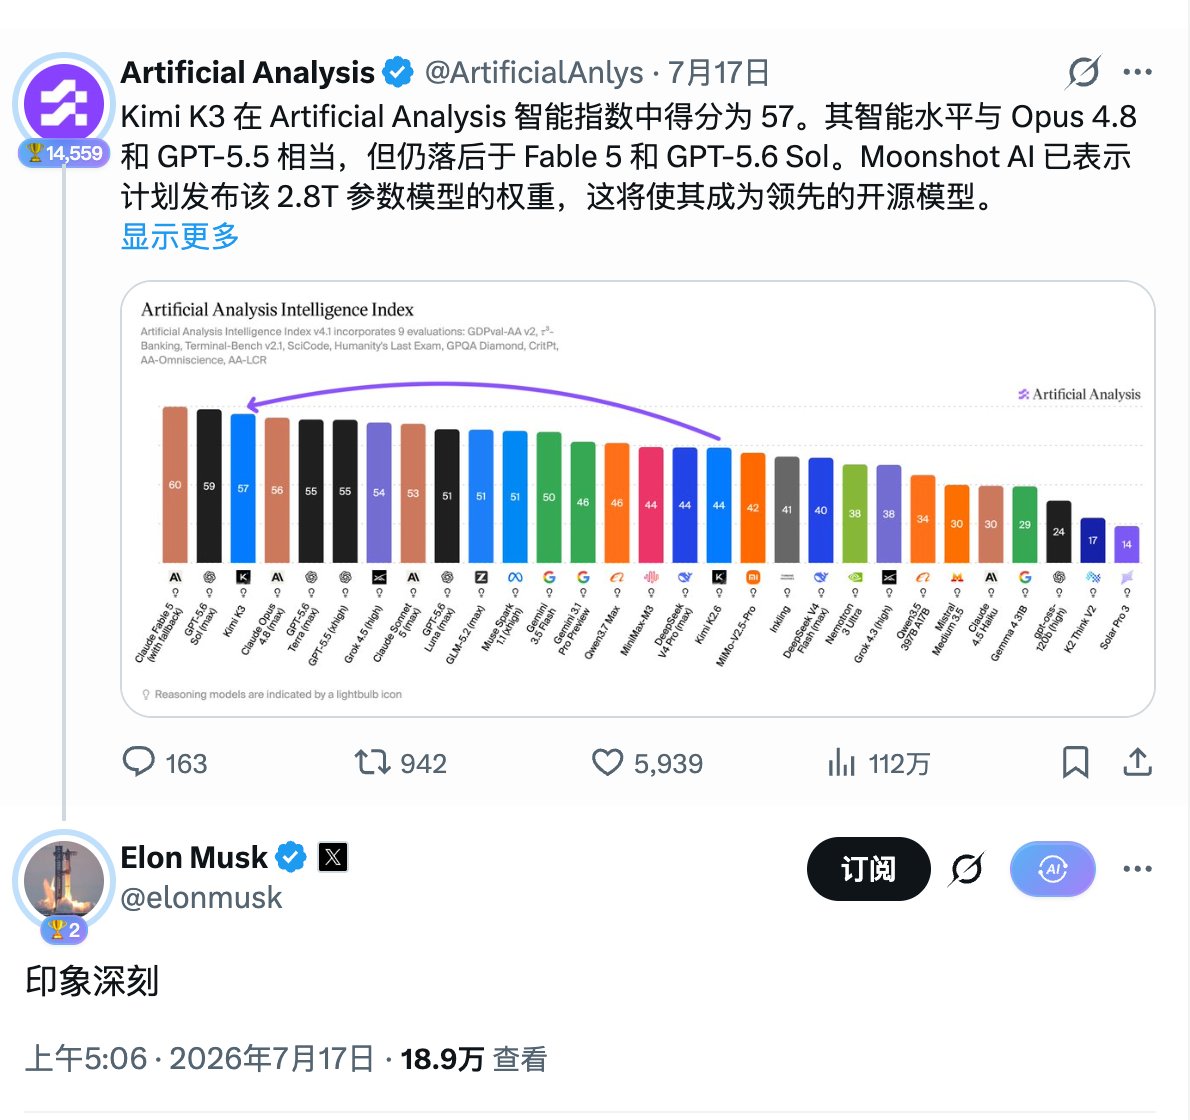
这是目前全球参数规模最大的开源大模型,总参数量直接达到 2.8T 级别。从 K2 的 1T 到现在的 2.8T ,Kimi 把开源模型的尺寸上限又往上抬了一大截。
很多人看到这个数字,第一反应可能是“又开始卷参数了”。但 Kimi K3 这次其实没有单纯靠堆参数。它采用了一种新的 Kimi Linear 混合线性注意力架构,并引入了 Attention Residuals(注意力残差)。简单来说,这个架构变化主要是为了解决大模型在处理超长上下文和多轮复杂任务时容易出现的“信息衰减”问题。
以前很多模型做到一定规模后,长上下文表现会明显下滑,尤其在需要多步推理和长时间记忆的场景下容易丢信息。而 Attention Residuals 的引入,就是想让模型在超长对话和复杂任务链中保持更好的稳定性。
以前我们想做一个需要较长上下文记忆、或者要进行多轮迭代的 Agent 时,大多还是得依赖 Claude 这类闭源模型。现在 Kimi K3 在开源模型里把这个能力往前推了一步,意味着我们在处理长代码库理解、多文件重构、复杂多步 Agent 任务时,有了更具性价比的选择。
当然,目前来看,Kimi K3 和闭源顶级模型(尤其是 Claude Fable )在极致复杂的架构设计和单次高难度推理上,依然存在一定差距。但在日常的长时程 Coding 工作流和需要一定上下文稳定性的 Agent 场景下,它已经展现出比较强的实用价值。海外已经有博主实测,能力超过了Opus。
Youtube链接:https://www.youtube.com/watch?v=To0kYStFS3I
另外,这次 Kimi K3 把开源模型参数规模推到 2.8T 级别,也再次把“开源模型能做到什么程度”这个话题推到了新的阶段。
在算力资源相对受限的情况下,中国团队依然把开源模型的尺寸和能力往前带了一大步,这对整个开发者生态来说是积极的信号。
- 如果你主要做日常编程、需要处理较长上下文的 Agent、或者经常进行多轮代码迭代,Kimi K3 值得重点关注和尝试。
- 如果你目前的工作对极致推理质量和最稳定的复杂任务有极高要求,闭源模型目前依然更有优势。
- 开源模型正在快速缩小和闭源顶级模型的差距,这对大多数开发者来说是好事。
在Frontend Code Arena 排行榜中,Kimi K3 以 1679 分 排名 第 1,领先 Claude Fable 5(1631 分)和 GPT-5.6 Sol(1618 分)
在前端领域,Kimi-K3 在 7 个领域中的 6 个位居 #1:品牌与营销、基于参考的设计、数据与分析、消费产品、模拟以及内容创建工具,仅在游戏领域位列 #2,落后于 Fable 5。
下面我们来一起来测试一下马斯克都印象深刻的模型是怎么样的
以下是实测,这次不止是前端了,我们从代码分析、文案写作、游戏制作、视频制作一直到工程代码编写,全面测试K3的能力。
代码分析和文案写作
最近XAI开源了Grok Build的源码,我们直接让K3分析源码,然后输出一份技术文档白皮书
可以看到,K3模型的联网搜索和结构分析,都没有问题。启动了很多subagent干活,非常细致
最后是调研的白皮书,效果如下面视频所示。

坦白地说:高于"新闻洗稿"水准,但离一份真正严谨的技术评估还有明确差距。下面是我认为的优缺点:
基于源码而非通稿:目前网上关于 Grok Build 的文章基本是复述官方说辞,
这份白皮书是真的把 73MB 源码克隆下来、逐个子系统读出来的,全文带文件路径和行号,关键数字都由K3亲自抽查复核过,不是抄来的。
竞品对比偏弱:Claude Code / Codex / opencode 那几列没有用同等标准去验证,凭的是既有印象,可能过时或不准。
总评:内容约 8 分——作为 1小时内对 84 万行代码库的静态解剖是扎实的;但对比这一节和"未实测"这两件事让它够不上 9 分。
游戏制作
这里我们要求K3构建一个高品质的马里奥类平台跳跃游戏,使用单个 HTML 文件。
完整的提示词和效果见视频↓
可以看到可玩性还是非常高的,而且带有完整的交互音乐。这方面我给9分,之所以不给满分是因为小怪太多了,我这个老年人过不去。。。
也部署到vercel在线地址了,大家感兴趣的可以亲自体验一下:https://kimi-3.vercel.app/
视频制作
我们直接用一句提示词:制作一个介绍上海的视频,必须要达到发布级质感
话不多说,直接展示效果:(建议听一下声音,非常不错)

这个视频我觉得做得还是不错的,尤其重要的优点为:音画关系成熟:剪辑卡在音乐实测重拍上,尾奏让位给环境声并用刻印音效收尾,审美是在线的
在全自动 + 只用素材库现有素材的约束下,这是一条概念有纪律、工程可验证、质感统一的城市短片,达到了自媒体发布级的上限。
视频制作这一方面,我给 Kimi K3打 9 分。
工程代码编写
这里我们拿了一个比较复杂的案例测试代码编写能力:从工程骨架到完整 Webhook 服务,图片是完整的工程方案:

为了避免一次性生成大量代码,我将 MiniRelay 拆成五个阶段,逐步交给 Kimi Code 完成。每个阶段都要求它先检查现有仓库、给出实施计划,然后再修改代码;完成后必须实际运行 lint、typecheck、test 和 build,出现错误则继续修复,不能仅口头宣称完成。
测试开始时,目录中只有一个半成品 package.json 和部分依赖,TypeScript 配置、源码目录、数据库 Migration、测试和 Docker 环境都还不存在,基本相当于从工程骨架开始搭建。
第一阶段:项目与数据库
Kimi Code 首先完成了 TypeScript、Fastify、PostgreSQL、Drizzle ORM 和 Docker Compose 的基础配置,并设计了 Endpoint、Event、Delivery 和 Delivery Attempt 四张核心数据表。
它还实现了环境变量校验、数据库 Migration、健康检查接口和真实 PostgreSQL 集成测试。过程中遇到 ESLint 错误和 Drizzle 包装 PostgreSQL 异常导致断言失败的问题,Kimi 能根据错误信息自行调整,最终通过了首批 28 个测试
第二阶段:Endpoint 和 Event API
第二阶段开始实现业务接口,包括 Endpoint 的增删改查、Event 创建、Delivery 查询以及统一错误响应。
这一步的重点是事务:创建一条 Event 时,系统需要同时为所有启用的 Endpoint 创建 Delivery。如果其中任何一步失败,前面的 Event 也必须回滚。
Kimi 将项目拆分为 Route、Service 和 Repository 三层,并通过依赖注入测试事务失败场景。完成后,测试数量增加到 64 个。
在真实冒烟测试中曾出现接口返回 404。Kimi 最初怀疑构建产物存在问题,继续排查后发现实际原因是第一阶段遗留的旧 Node 进程仍占用端口。它随后定位并关闭旧进程,重新验证了完整 API 链路。
第三阶段:异步 Worker
第三阶段是最能体现工程能力的一部分。
Kimi 实现了独立 Worker,通过 PostgreSQL 的 SELECT FOR UPDATE SKIP LOCKED 领取任务,支持多个 Worker 并发运行,并使用 lockedBy 和 lockedUntil 处理 Worker 崩溃后的任务恢复。
它还实现了 HTTP 超时、投递记录、优雅退出,以及一个可以控制返回状态码和响应延迟的测试 Receiver。
测试过程中,Kimi 使用的 z.httpUrl() 无法接受 localhost 和 IP 地址,导致测试 Endpoint 创建失败。它通过最小复现确认了 Zod 的行为,随后改为通用 URL 校验加 HTTP/HTTPS 协议限制。阶段完成后共有 73 个测试,并成功完成了 API、Worker 和 Receiver 三进程的真实投递。

第四阶段:重试与 HMAC 签名
随后,Kimi 为 Worker 增加了最大四次尝试和 5 秒、10 秒、20 秒的指数退避策略,并区分了可重试错误与不可重试错误。
为了避免测试真实等待,它抽象出可注入的 Clock;Webhook 请求则使用 HMAC-SHA256,对 timestamp + "." + rawRequestBody 进行签名。
这一步也出现了一个有代表性的问题:测试使用的假时钟早于数据库生成的 nextAttemptAt,导致 Worker 无法领取任务。Kimi 通过检查领取条件定位到时间不同步,修正测试时钟后,重试测试全部通过。此时项目累计 112 个测试。
第五阶段:最终工程验收
最后,Kimi 对整个仓库进行检查,清理重复配置,补充数据库索引和正式 Migration,并新增了一条完整端到端测试:
创建两个 Endpoint,提交一个 Event;其中一个 Endpoint 首次成功,另一个首次返回 500,随后自动重试成功;最终检查 Delivery 状态、Attempt 数量和两条请求的 HMAC 签名。
它还生成了 GitHub Actions 配置,并重新整理 README。期间甚至发现文档中的错误响应示例与真实代码不一致,随后根据实现修正文档。
最后的结果非常令我震惊。我用Fable 5 审阅了 K3 写的代码,建立了一套完善的测试标准,结果竟然 60 项测试里面有 56 项通过,只有 4 项是失败的。
综合来看,K3 写的代码质量还是相当高的。
整个过程中,Kimi 不只是生成代码,还实际执行命令、读取错误、定位原因并继续修改。比较有价值的是,它既解决了常规的类型和测试问题,也处理了 URL 校验、残留进程、数据库时间与假时钟不同步等工程环境中的真实问题。
总体来说我觉得K3质量已经非常高了,代码编写能力仅次于Fable,值得一试!