
AI 工作流到底是什么:从入门到榨干
你每天都在用 AI,工作却不一定真的变少。
让它读材料,它给你一段总结;让它分析反馈,它告诉你可以分成哪几类;让它帮忙写内容,它交出一篇看起来还不错的初稿。
接下来呢?
你要把总结复制进文档,把分类重新做成表格,把初稿里的事实挨个核对。漏了一项,再回去追问;模型忘了前面的要求,又要重新解释一遍。
AI 参与了工作,却只接走了中间那一小段。前面的材料整理、后面的保存检查,还是你的。
这篇文章想解决的是另一件事:怎样把一项真实工作拆成 AI 能够接手的流程。
我会把同一件事做两遍。
第一遍直接使用 Ling-3.0-flash 的对话页面,不需要写代码。我们先把输入、步骤、交接和检查跑通,完成一条“长文变成六页图文和 60 秒视频脚本”的内容工作流。
第二遍再把这套流程接入 Ling API 和 OpenCode,让 Agent 自己读取文件、生成结果、继续下一步,并在该由人判断的地方停下来。
如果你只是想把 AI 更有效地用进日常工作,看到前半篇就能拿到一套可以照着使用的方法。想继续榨干的人,可以在后半篇把它升级成能够读写文件、调用工具的 Agent。
目录(相关文章尾部跳转)
- 一、你以为在用 AI 工作,其实还在替它收尾
- 二、为什么这次用 Ling-3.0-flash 做执行模型
- 三、先别急着问 AI:把你的工作画成一条能跑的路线
- 四、完整示范:把一篇长文变成六页图文和 60 秒视频
- 五、不想继续复制粘贴:把这套流程交给 Agent
- 六、还可以怎么玩 AI:15 秒表演和农场小游戏
- 七、Agent 工作台怎么选:先看它要在哪里干活
- 八、哪些活别交给 Ling:规划、执行和人工批准怎么分
- 九、四类人怎么开始:今天先交出去哪个步骤
一、你以为在用 AI 工作,其实还在替它收尾
一句“帮我总结这些反馈”,不是工作流。
一段写了两千字、塞满角色、背景、语气和禁用词的提示词,也不一定是工作流。它只是把一次请求写得更详细。
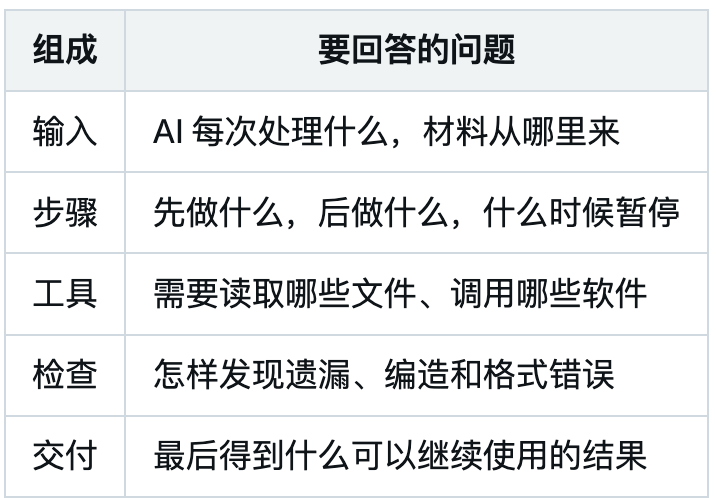
一条完整的工作流至少要回答五个问题:
| 任务 | 更适合交给谁 |
| --- | --- |
| 目标、价值判断、选题和最终签字 | 人 |
| 陌生领域、复杂架构、多约束规划 | 人或 Ring-2.6-1T 等规划模型 |
| 明确抽取、格式转换、文件读写和高频修改 | Ling-3.0-flash |
| 图像、音频、视频理解与生成 | Ming 或其他多模态、AIGC 模型 |
| 已经完全确定的计算和格式校验 | 普通代码 |
| 发送、发布、付款、删除等高风险动作 | 工具执行,但必须人工批准 |
例如,你有五十条用户反馈。
普通聊天是:
帮我总结一下这些反馈。
稍好的提示词是:
按功能问题、价格问题和使用障碍分类,每类给出数量和代表意见。
工作流会继续往后走:
- 给每条反馈保留原始编号;
- 按固定字段分类;
- 无法判断的放进“待确认”,不强行补全;
- 检查有没有重复、遗漏和空字段;
- 输出一份可以筛选的表格;
- 人确认后,再生成团队摘要或写进待办系统。
区别就在最后几步。
聊天给你一个答案。工作流把结果送进下一步,直到出现可以打开、可以核对、可以继续使用的东西。
这里还要分清工作流和 Agent。
工作流是一条已经画好的路线。材料经过哪些步骤,哪里必须停下来等人确认,提前都可以定好。
Agent 是能够在这条路线里使用工具的执行者。它可以自己决定先读哪个文件、调用什么工具、遇到错误是否重试,以及什么时候应该回来问你。
手动把会话 A 的结果复制给会话 B,也可以是一条工作流。前提是:
- A 和 B 的职责固定;
- A 的输出能成为 B 的固定输入;
- 中间有明确的人工确认;
- B 的结果会返回检查;
- 下次还能照着同样的结构再跑。
同时打开两个聊天窗口,不会自动变成“双 Agent”。如果搬运、触发和判断都由你完成,它仍是一条人工编排的工作流。
等到模型能自己读取文件、调用工具、保存结果,并根据工具返回继续推进时,这条流程才由 Agent 接手执行。
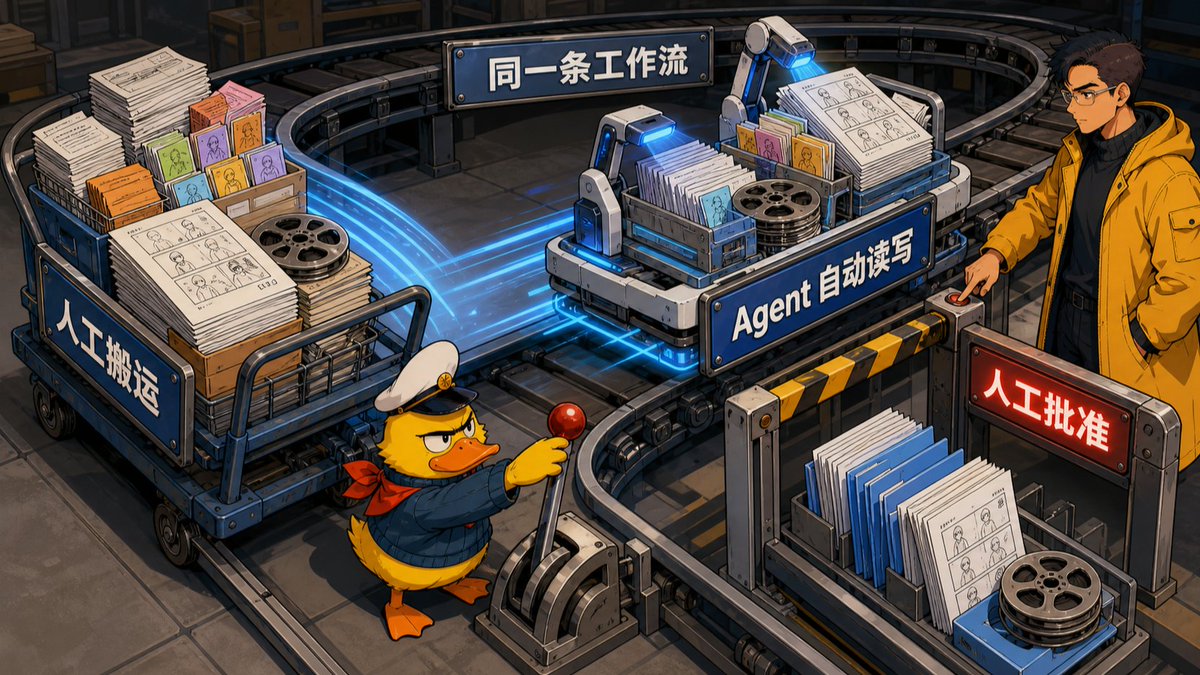
这也是全文的路线:
先把路画清楚,再让 AI 走;先手动跑通,再把搬运交给 Agent。
二、为什么这次用 Ling-3.0-flash 做执行模型
不是所有工作都需要最贵、最会深度推理的模型。
复杂商业判断、陌生领域研究和大型系统架构,确实需要更强的规划能力。但日常工作里还有大量任务,难点不是“想不明白”,而是要反复读取、分类、转换格式、调用工具、检查结果和继续修改。
Ling-3.0-flash 更适合站在这个位置。
百灵把它定位为面向 Agent 长程工作流的高速执行模型。它总参数量为 124B,每次激活 5.1B,不负责包办所有宏观判断,主要以较低成本承担高频执行、工具调用和较长任务。官方模型页面给出的当前 API 上下文为 256K;具体入口、账户和部署方式可能不同,不要把部署上限当成每个人都能直接获得的体验。
它有两个与这篇文章直接相关的入口。
第一种:直接使用对话页面
打开 百灵 AI Studio,在左上角模型菜单选择 Ling-3.0-flash。
在这里,它和普通聊天模型一样,可以接收文字、系统提示词和多轮指令。右侧还能看见联网搜索、时间查询、天气查询等工具开关。
前四章使用这个入口。它的优势是没有安装门槛,适合先验证工作流本身有没有用。
第二种:通过 API 进入 Agent 工作台
百灵提供 OpenAI 兼容接口,当前模型 ID 是:

基础地址是:
```text
你是平台内容编辑。

只能使用 handoff.md 中已经确认的观点和事实。
可以调整顺序、节奏和表达,不能增加新事实、改变因果或删除限制。
如果材料不足,请直接指出,不得自行补充。
```
通过 API,它可以进入 OpenCode、Pi、Hermes、nanobot 或其他支持 OpenAI-compatible Provider 的工作台。
这几层不要混在一起:
- Ling 是模型:负责理解任务、生成内容和决定下一步;
- 文件、终端、搜索和 Office 是工具:负责读取、写入和产生真实变化;
- OpenCode 这类 Harness 是工作台:把模型、上下文、工具、权限和错误反馈组织在一起。
模型自己不会凭空修改文件。只有进入能够提供文件工具的 Harness,它才有“手”。
思考模式不是越开越好
Ling-3.0-flash 支持思考与非思考两种状态。百灵当前 OpenAI 兼容接口使用:
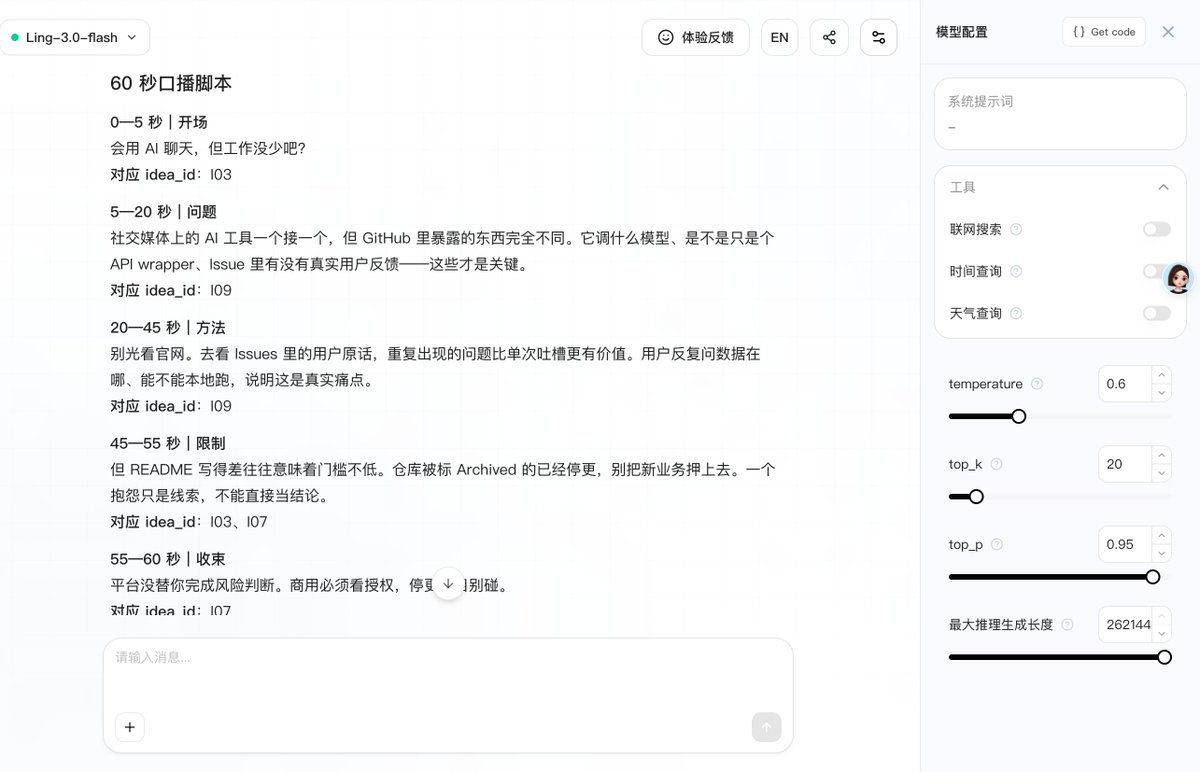
或者:
```text
Ling-3.0-flash
```
事实冲突、任务拆解和错误修正,可以开启思考;已经确认的字段转换和固定格式改写,可以测试关闭思考以减少等待。
不要照搬其他平台的 enable_thinking 参数。第三方 Harness 可能使用自己的配置方式,必须先确认它有没有正确传递。
规划模型不需要每次都登场
一种常见说法是:
高级模型负责思考,Ling 负责干活。
这个方向只说对了一半。
如果任务已经很清楚,例如提取观点卡、改成固定格式、读写文件和按规则回查,Ling 自己就能承担从理解到执行的大部分过程。没有必要为了显得“多 Agent”,先召集几个模型开会。
只有当目标模糊、约束复杂、风险很高,或者需要大规模架构规划时,才值得让人或 Ring-2.6-1T 等更强的规划模型先产出规范,再把明确任务交给 Ling 高频执行。
分工按任务走。简单执行不必额外增加规划模型,复杂判断也不能只因为 Ling 更快就交给它。
三、先别急着问 AI:把你的工作画成一条能跑的路线
https://x.com/ponyodong/status/2080974135258407068?s=20很多人搭 AI 工作流的第一步,是打开模型问:
你能帮我做什么?
这很容易得到一份听起来无所不能的功能清单,却很难替你少做一步。
更有效的起点,是回头看自己过去一周:
哪一段工作我已经做过很多次,每次都要重复搬运、整理和检查?
先找“小而烦”的任务
适合第一次交给 AI 的工作,通常有六个特征:
- 高频:每天或每周都会发生;
- 输入已经数字化:材料是文字、表格、网页或文件;
- 步骤相对稳定:你大致知道平时怎么做;
- 交付物明确:最后应该得到一张表、一篇稿或一组文件;
- 错误可以检查:能回到原文、数字、测试或状态核对;
- 风险可控:第一版不会直接付款、发布、删除或覆盖正式文件。
“帮我运营一个账号”就不是好起点。选题、价值判断、内容生产、发布、互动和数据复盘全揉在一起,任何结果都很难验收。
“把一篇已经确认的长文改成六页图文,并检查有没有改变原意”就清楚得多。
普通人的第一条工作流,也可以从这些地方开始:
https://chat.ant-ling.com/chat第一次先交出去其中一段:规则清楚,结果也查得到。
用六个问题搭出第一版
选定任务以后,不要急着写一大段提示词。先填这张任务单:
```text
任务:
减少同一篇文章反复改成不同平台内容的时间。

输入:
一篇已经完成事实核对和观点确认的长文。

步骤:
母内容编号 → 提取观点卡 → 人选择 → 平台改编 → 返回原文检查。

交付:
六页图文脚本、60 秒视频脚本、审查报告。

检查:
每个观点能回到原文;不能增加新事实、改变因果或删除限制。

人工批准:
选择哪些观点继续使用;最终是否发布。
```
以第四章要做的内容工作流为例:
| 你反复在做什么 | 可以先交出去的一段 |
| --- | --- |
| 每天翻聊天、邮件和笔记 | 原始消息 → 分类 → 今日待办 → 人确认 |
| 同一篇内容反复改平台 | 母内容 → 观点卡 → 平台改编 → 原文回查 |
| 周五重新回忆做过什么 | 每日记录 → 事实表 → 周报草稿 → 来源核对 |
| 收集一批用户反馈 | 原始反馈 → 编号 → 分类 → 异常项 → 汇总 |
这张任务单比“你是一位资深新媒体运营专家”更重要。
角色设定只能影响表达方式。任务单决定材料怎样进入、结果怎样出来,以及出了错往哪里退。
先把判断和执行分开
一条实用的工作流,不会让模型从头到尾自由发挥。
第四章里,我们会把任务拆成三种责任:
- 会话 A 忠实拆解母内容;
- 人选择真正值得传播的观点;
- 会话 B 负责平台表达;
- 最后再由会话 A 对照原文回查。
为什么不让一个会话一口气完成?
因为“提取原意”和“把内容写得更有传播力”是两种会互相拉扯的任务。前者要求克制,后者鼓励改写。把它们拆开,更容易知道错误发生在哪一步。
第一遍一定要手动跑
手动并不落后。
第一次亲自把 A 的结果交给 B,你才能看见:
- 哪个字段经常缺失;
- 哪一步最容易产生新事实;
- 哪些判断绝不能自动化;
- 哪个检查条件真的能抓住错误;
- 这件事是否值得继续接 API。
如果一条流程一个月只用一次,或者每次输入都完全不同,自动化它可能比亲手做更麻烦。
第三章先做到这一步:
先找到一段值得交出去的工作,再用最简单的方式跑通。
四、完整示范:把一篇长文变成六页图文和 60 秒视频
优秀的内容系统,通常不会每天让 AI 从零生成十个选题。
GaryVee 的内容模型从一份长视频、演讲或播客等支柱内容出发,再拆成适合不同平台的短内容;Justin Welsh 的 Content Operating System也先稳定生产一份 newsletter,再把它转成多份衍生内容。
两种方法的共同点是:
先有一份确认过的母内容,再做平台适配。
这一章不拿陌生资料让 AI 凭空写文章。准备一篇你已经完成、事实和观点都确认过的长文。
最终要得到六个文件:
```text
根据同一份 handoff.md 生成 60 秒口播脚本。

输出:
- 0—5 秒:开场;
- 5—20 秒:问题;
- 20—45 秒:方法;
- 45—55 秒:限制;
- 55—60 秒:收束;
- 每一段对应的 idea_id。

语言要适合自然口播,不要把六页图文逐字复述。
不要增加 handoff.md 之外的事实。
```
如果你不习惯 Markdown,也可以把它们理解为六份普通文档。文件名只是为了让交接关系更清楚。
第一步:配置会话 A
打开 百灵 AI Studio:
- 新建会话 A;
- 在模型菜单选择 Ling-3.0-flash;
- 关闭这次任务不需要的联网搜索、时间和天气工具;
- 在右侧系统提示词填入:
系统提示词只负责规定会话 A 的职责,不需要把正文塞进右侧设置。
第二步:一次发送母内容和拆解任务
回到对话框,把下面这条完整消息发给会话 A。最后再把你的长文粘贴进去:
```text
当前结果:
第 4 页写成“AI 工作流一定能减少一半工作时间”。

预期结果:
改为母内容中的条件判断,不得承诺固定比例。

证据:
P08 只说“当任务高频、步骤稳定且可检查时,才值得自动化”。

允许修改:
只修改第 4 页和视频中对应 I07 的段落。
```
这条消息只需要发送一次。
[P01] 不是另一套提示词,只是原文坐标。它让观点卡能够写明“这句话来自 P03”,最后回查时不用重新翻整篇长文。
把 A 部分保存为 pillar-numbered.md,把 B 部分保存为 idea-cards.md。如果你不用 Markdown,也可以分别存成两份普通文档。
这一轮结束后,先别急着继续改编。
你应该看到一组结构化观点卡,每张卡带 idea_id 和原文编号。现在重点检查:
- 有没有一句话听起来很漂亮,却找不到原文;
- 有没有把例子拔高成普遍结论;
- 有没有删掉“可能、适合、在某些情况下”等限制;
- 待确认内容有没有混进可用卡片。
第三步:人来选,不让模型替你决定选题
不要把全部观点卡送进下一步。
选择两到三张:
- 你真正认同;
- 单独拿出来仍然成立;
- 与目标读者有关;
- 有事实、经验或具体方法支撑。
把选中的卡片复制到 handoff.md:
https://x.com/noahduck283/status/2079546236441653632?s=20这一步由人来把关。
AI 可以帮助你拆观点,但“什么值得传播”仍然是作者的判断。没有这一步,一稿多用很容易变成一稿多份平庸内容。
第四步:会话 B 只做平台适配
新建一个干净的会话 B,仍然选择 Ling-3.0-flash。
系统提示词填入:
```text
读取:
- instructions/adapt.md
- instructions/review.md
- input/pillar.md
- handoff/selected-ideas.md

依次完成:
1. 生成 output/xhs-6-cards.md;
2. 生成 output/video-60s.md;
3. 对照母内容和 selected-ideas.md 审查两份成品;
4. 把问题写入 output/review.md。

规则:
- 不得修改 input/pillar.md;
- 不得使用 selected-ideas.md 之外的观点;
- 发现材料不足时写入 review.md,不得自行补全;
- 不发送、不发布;
- 完成后返回三个文件路径和每个文件的行数。
```
先生成六页图文:
https://learn.justinwelsh.me/store再生成 60 秒视频脚本:
```text
[L01] 完成了什么;
[L02] 得到了什么结果;
[L03] 哪个数字来自哪里;
[L04] 遇到了什么阻塞;
[L05] 下周准备做什么。
```
```text
请根据原始母内容、idea-cards.md 和 handoff.md 审查这两个成品。

只报告:
1. 新增了哪些母内容没有的事实;
2. 哪些观点改变了原意;
3. 哪些适用条件或限制被删除;
4. 哪些页面或口播段落脱离了对应 idea_id;
5. 哪些重要观点在改编中被遗漏。

每个问题必须包含:
- 问题位置;
- 当前内容;
- 原文证据;
- 建议修改范围。

不要直接重写整份成品。
```
这里让同一个会话生成两种内容,是因为它们共享同一份已经确认的交接材料。会话 B 可以改表达,不能重新决定观点。
```text
读取 instructions/extract.md 和 input/pillar.md。

按照规则生成 staging/idea-cards.md。
完成后检查:
1. 每张卡是否有原文编号;
2. 是否出现母内容之外的新事实;
3. 是否保留限制条件。

只完成观点卡,返回文件路径和检查结果,然后暂停。
不要生成平台内容。
```
第五步:把成品送回会话 A
把六页图文和视频脚本交回会话 A:
```text
你是内容拆解编辑。

只根据我提供的母内容工作,不补充外部事实,不模仿其他作者。
你的任务是保留原意、提取可独立传播的观点,并标出来源。
无法确定的信息必须标记待确认。
```
```text
https://api.ant-ling.com/v1/
```
为什么不让会话 B 自己检查自己?
因为它已经投入了当前表达方式,更容易沿着自己的写法继续合理化。让忠实拆解母内容的会话 A 回来对账,角色更清楚。
人确认审查结果后,再把明确修改项交给会话 B。不要只说“再准确一点”,而是告诉它:
```text
任务:
我真正想少做的是哪一段重复劳动?

输入:
AI 每次只能使用哪些材料?

步骤:
材料进入以后,依次经过哪些处理?
在哪一步必须暂停?

交付:
最后必须得到什么可以打开或继续使用的结果?

检查:
怎样证明没有遗漏、编造、写错或跑偏?

人工批准:
哪些判断和外部操作必须由我确认?
```
到这里,一条完整的人工工作流已经跑通:
母内容 → 会话 A 拆观点 → 人选择 → 会话 B 做平台适配 → 会话 A 回查 → 人批准。
工作流靠的是中间那份 handoff.md 和最后的回查,不是同时打开两个会话框。
它们让你知道:什么可以进入下一步,什么必须停下来,以及错了以后应该退回哪里。
五、不想继续复制粘贴:把这套流程交给 Agent
上一章已经可以稳定产出,但还有几件事是你亲手做的:
- 把母内容交给会话 A;
- 把选中的观点复制给会话 B;
- 把成品送回 A 检查;
- 分别保存六个文件。
如果这条流程偶尔用一次,手动完成就够了。
如果你每周都要做,下一步才值得接 API:流程不变,只把读取、保存和搬运交给 Agent。
这一章使用 OpenCode 作为示范工作台。原因很简单:它能够让模型读取项目文件、创建和修改文档、查看变更,并在任务中继续调用工具。它不只适合写代码,也适合这种以 Markdown 文件为中间产物的内容流程。
第一步:准备 Ling API
在百灵 API 控制台创建测试令牌。令牌只展示一次时,先保存到密码管理器,不要贴进文章、截图或项目文件。
百灵当前接口需要三项信息:

先把 Key 放进环境变量:
https://x.com/noahduck283/status/2076823902727405942?s=20这条命令只对当前终端会话生效,关闭后需要重新设置。长期保存时也不要把 Key 写进会被同步或上传的仓库。
第二步:把 Ling 接进 OpenCode
OpenCode 的配置字段会随版本变化。下面按照当前主文档的 OpenAI-compatible Provider 写法。
在项目目录创建或更新 opencode.json:
| 你最想减少的动作 | 先看什么 | 为什么 |
| --- | --- | --- |
| 在项目里反复读写文件、改内容或代码 | [OpenCode](https://opencode.ai/docs/)、[Pi](https://github.com/earendil-works/pi) | 能读取项目、修改文件并接收工具报错 |
| 从聊天软件随时叫它整理消息、提醒或调用工具 | [nanobot](https://github.com/HKUDS/nanobot)、[Hermes](https://github.com/NousResearch/hermes-agent) | 更适合长期运行的个人助手和消息入口 |
| 把结果真正写进 Excel、Word 或业务系统 | 对应 MCP 或专用 API | 仅有聊天窗口不能产生真实的跨软件结果 |
| 同一流程每天大量重复 | [LangGraph](https://docs.langchain.com/oss/python/langgraph/workflows-agents) | 可以固定节点、保存状态,并在人工批准后继续 |
| 已经长期使用 Claude Code | 按[百灵官方文档](https://developer.ant-ling.com/zh-CN/docs/integrations/claude-code/)接入 | 沿用已有工具和权限习惯,减少迁移 |
打开 OpenCode,运行:
https://x.com/noahduck283/status/2072860039862497328?s=20在列表里选择:
```text
ling/Ling-3.0-flash
```
如果模型没有出现,先检查三件事:
- opencode.json 是否位于当前项目目录;
- Provider ID 是否是 ling;
- 当前 OpenCode 版本是否已经改用新版配置结构。
不要在模型列表都没出现时继续排查提示词。配置层没有接通,改提示词没有意义。最新字段以 OpenCode Provider 文档 为准。
这一步只能证明模型能够被选择,还不能证明工具调用和长任务都正常。正式运行前,先让它只读一个小文件,再创建一个测试文件,确认它真的拿到了读写工具。
第三步:把工作流变成文件结构
在项目里准备:
```json
{
  "thinking": {
    "type": "enable"
  }
}
```
把第四章使用的母内容放进 input/pillar.md。
三个指令文件分别保存:
- extract.md:会话 A 的观点卡规则;
- adapt.md:会话 B 的六页图文和视频规则;
- review.md:返回母内容检查的规则。
我们没有重新写一套 Agent 提示词,只是把已经手动验证过的流程从聊天记录里拿出来,变成稳定文件。
第四步:让 Agent 做到人工闸门就停
第一次不要让它直接生成全部内容。发送:
```text
handoff/selected-ideas.md
```
这时,OpenCode 中的 Ling 不再只是回复一段文字。
它需要选择文件读取工具,读取两份输入,把结果写入指定路径,再向你报告完成情况。模型、工具和工作台开始组成一个 Agent。
打开 staging/idea-cards.md,亲自选择观点。把确认内容写进:
https://developer.ant-ling.com/zh-CN/docs/models/ling/人工闸门仍然保留。API 的作用不是取消你的选择,而是省掉重复搬运。
第五步:批准以后,让它继续完成
确认 selected-ideas.md 后发送:
https://x.com/ponyodong最后不要只看它说“已完成”。
验收只看:
```text
请按照顺序完成两件事。

第一步,按照自然段给下面的母内容依次添加 [P01]、[P02]、[P03]……
只添加编号,不得改写、删减或调整原文顺序。

第二步,基于编号后的原文,拆成 8—12 张观点卡。

请分成两部分输出:

A. 编号后的完整母内容
B. 观点卡

每张卡包含:
- idea_id;
- 一句话观点;
- 对应原文段落编号;
- 支撑它的事实或例子;
- 适合解决的读者问题;
- 单独传播时必须保留的限制;
- 状态:可用 / 待确认。

规则:
1. 不增加母内容没有的事实;
2. 不把推测写成结论;
3. 不删除原文中的适用条件;
4. 每张卡至少对应一个原文编号;
5. 完成 A 后再输出 B,不生成小红书和视频脚本。

下面是母内容:

【把完整长文粘贴在这里】
```
对话端和 Agent 的差别也出现在这里。
在对话端,人把结果从一步搬到下一步;在 Agent 工作台,模型通过工具读取中间文件、保存结果并继续执行。路线没有变,执行方式变了。
六、还可以怎么玩 :15 秒表演和农场小游戏
把 AI 用来整理材料、改内容,已经很实用了。更好玩的是,同一套方法还可以被拿去做完全不同的事情。
最近我看到两个很有意思的例子。
@ponyodong 用 Ling-3.0-flash,把一句简单的“难过”,拆成了一段 15 秒的角色表演。
我从这个案例里学到的,是别把“难过”直接扔给视频模型。他继续往下拆:角色在哪一秒开始躲避视线,呼吸什么时候变化,手上的动作怎样停顿,镜头应该靠近还是拉远。
“难过”只是一个抽象感觉。拆成观众能看见、视频模型能执行的动作以后,它才有办法进入制作流程。
具体过程可以看她的原文:
《AI 角色不是没演技:我用 Ling-3.0-flash,把一句“难过”拆成了 15 秒表演》
Ling-3.0-flash 在这里不是视频生成模型。它负责把模糊创意整理成时间、动作、镜头和声音能够继续执行的说明,再交给相应的图像、视频或声音模型。
另一个例子来自 @GameFiLabs。
他用 Ling-3.0-flash 做了一个农场小游戏。这个案例让我记住另一件事:别一上来就要求 AI 做出一个完整世界。
先锁定最小的一圈玩法:
点击土地 → 播种 → 生长 → 收获 → 金币增加。
土地能不能出现,播种有没有反馈,作物能不能生长,金币有没有正确变化,每一步都可以单独检查。上一层跑通以后,才继续增加下一层。
具体制作过程可以看这里:
《新手如何用 Ling-3.0-flash 做出第一个农场小游戏》
一个在演戏,一个在种田,看起来和整理材料、生产内容完全不同,底层做的却是同一件事:
模糊想法 → 最小闭环 → 可观察步骤 → 每轮验收 → 再增加一层。
如果你想把一个自己的创意交给 AI,也可以先问:
- 我写下的是抽象感觉,还是可以被看见的动作?
- 第一版最小能玩、能看或能运行的闭环是什么?
- 每一轮怎样证明它真的完成了?
- 出错以后能不能只修改这一层?
工作流也不只是一套办公模板。它同样能把模糊想法一点点推成可以看、可以玩、可以检查的结果。
七、Agent 工作台怎么选:先看它要在哪里干活
第五章使用的是 OpenCode,但 Agent 并不只有这一种形态。
有人想让它待在项目文件夹里,有人想从聊天软件随时叫它干活,还有人需要它操作 Excel、Word,或者每天自动处理几百份材料。
选择工具前,只要先分清三个东西:
- Harness 是工作台:OpenCode、Pi、Hermes 负责给模型准备上下文、工具、权限和执行记录;
- MCP 是工具接口:把文件、浏览器、数据库或 Office 的能力接给工作台;
- 流程编排是固定路线:LangGraph 适合把步骤、失败退路和人工批准写成长期运行的生产线。
它们不是替代关系。Harness 决定 Agent 在哪里工作,MCP 决定它能碰什么,编排层决定结果接下来往哪里走。
按工作现场选择
https://x.com/noahduck283/status/2079914518743056580?s=20如果只是偶尔处理一篇文章,继续使用对话端就够了;如果输入和结果都在一个项目目录里,先用 OpenCode;只有当任务真的跨消息、跨软件或需要长期批量运行时,才继续增加其他层。
记住三个选择原则
第一,跟着工作走。材料在哪,结果要写到哪,就选择能进入那个现场的工具。
第二,选择最短链路。OpenCode 能完成的事,不必同时安装消息 Bot、Office MCP 和 LangGraph。
第三,先手动跑通再升级。输入、交付和检查条件还不稳定时,更复杂的 Agent 只会把混乱自动化。
百灵目前为 Hermes Agent、Claude Code 等提供了直接接入说明;OpenCode、Pi、nanobot 和 LangGraph 可以通过兼容接口连接。无论属于哪一种,都不能把“模型出现在列表里”当成已经可用。
正式任务前只做四项测试:
- 从请求记录确认实际调用的是 Ling-3.0-flash;
- 读取一个测试文件,再创建一个新文件,不覆盖原件;
- 故意请求不存在的文件,确认错误会返回给模型;
- 在发送、发布或覆盖前,确认它会暂停等待人批准。
选 Agent 工具不需要一步到位。先找到刚好能接走当前搬运动作的那一个,已经足够。
八、哪些活别交给 Ling:规划、执行和人工批准怎么分
执行模型速度快、单价低,不代表把所有任务交给它都更便宜。
一项任务的真实成本包括:
https://x.com/noahduck283/status/2069030402048893317?s=20如果模型每一步都需要你盯着,或者执行得越快、返工越多,低 Token 单价没有意义。
可以用这张表分工:
https://x.com/GameFiLabs/status/2080972291622752656?s=20还有五条边界值得单独记住。
不要让它一句话包办大型项目
“开发一个完整商城”“运营一个账号”“做一款好玩的游戏”,把需求、规划、执行和验收揉在一起。
先缩成一个能检查的交付,再逐步扩大。越开放的任务,越需要人或规划模型先写清范围和完成条件。
不要把长上下文当成垃圾场
上下文很长,不代表应该把几个月群聊、几十份无关文件全部塞进去。
每条工作流只读取完成当前任务需要的材料。长期任务要定期归档,中间结果通过结构化文件交接,而不是把所有历史都留在一个会话里。
不要让纯文本模型假装看见画面
Ling-3.0-flash 当前是纯文本模型。
第六章里,它负责拆表演、写镜头说明和调度工具,不负责原生理解或生成视频。需要判断画面时,先让多模态模型提取结构化描述,再把明确任务交给 Ling。
不要把私人材料默认交给云端
客户信息、合同、财务、简历、内部会议和未公开数据,不能因为“只是做个总结”就直接上传。
先核对平台隐私政策、合同和组织规定。无法确认时,使用公开、合成或彻底脱敏的材料。
不要让 Agent 自己批准自己
发布内容、发送邮件、修改生产数据、付款和删除文件,都不应该因为前几步自动化了,就顺手一起开放。
Agent 可以准备动作,人负责最终批准。自动化越往外连接真实系统,人工闸门越重要。
Ling-3.0-flash 的价值,不是把所有模型和所有人都替换掉。
它更适合承担工作流中明确、重复、需要工具和持续执行的部分,让昂贵模型少做机械劳动,也让人不再反复搬运已经确认的信息。
九、四类人怎么开始:今天先交出去哪个步骤
看到这里,不需要每个人都安装 OpenCode。
先从你当前最烦、又最容易检查的一小段工作开始。
普通人
找十条聊天、邮件和笔记,给每条信息编号。
让 Ling 只做分类:
- 明确待办;
- 已确认决定;
- 待确认问题;
- 仅供参考。
先检查它有没有把“可能、建议、可以考虑”写成已经决定。这个流程每周确实会用,再考虑接 nanobot 或 Hermes 自动收集消息。
内容创作者
直接跟第四章做。
找一篇已经完成的长文,先拆观点卡,自己选择,再生成六页图文和视频脚本。第一项成功标准很简单:每份内容都能回到同一套观点和事实。
如果每周都要重复,再进入第五章,用 API 和 OpenCode 接走文件搬运。
打工人
不要把“帮我写周报”当成第一步。
先在一周里留下带编号的原始记录:
让 Ling 先把动作、结果、数字、阻塞和计划分开,人确认后再生成周报。流程稳定以后,才考虑接文件系统或 Office 工具写进正式模板。
开发者和爱折腾的人
准备一个只有五六项功能的小工具或小游戏。
先写最小闭环和验收条件,再接入 OpenCode 或 Pi,让 Ling 每次实现一项、运行测试、读取错误并继续修正。
不要把登录、数据库、付费和部署一次塞进第一轮。
无论你属于哪一类,都可以从第三章的六个问题开始:
```text
根据 handoff.md 生成六页图文脚本。

结构:
1. 封面:提出一个具体问题;
2. 读者正在经历的现象;
3. 核心判断;
4. 可以照做的方法;
5. 最容易误解的地方;
6. 行动总结。

每页包含:
- 标题;
- 60 字以内正文;
- 对应 idea_id;
- 画面需要表达的关系。

不要新增数字和案例。
```
这六个问题答清楚以后,提示词才有意义,API 才有东西可接,Agent 才知道应该往哪里走。
AI 工作流到底是什么?
它不是把提示词写成一份越来越长的说明书,也不是让几个 Agent 在屏幕上互相聊天。
它是把一件真实任务拆成可以前后连接的步骤:材料有入口,中间有交接,结果能检查,错误能退回,人知道自己在哪些地方必须签字。
Ling 对话端让你先把这条路跑通;Ling API 和 Harness 再替你接走读取、保存和搬运。
所谓榨干,最后落到一个很朴素的尺度:已经能说清、能检查、又不值得你反复亲手做的事,就交给 AI;其余的,继续握在自己手里。
我是诺鸭船长,带你在信息的海洋里寻找陆地~
AI系列⬇️其他系列移步个人主页
AI写作四部曲
选题方法全网最全使用指南:从入门到榨干
爬虫工具全网最全使用指南:从入门到榨干全网
写作 Skill 全网最全使用指南:从入门到榨干
去AI 去味全网最全指南:从识别到榨干
AI使用
Grok 4.5全网最全使用指南:从入门到榨干
GPT-5.6/Codex 全网最全设置指南:从入门到榨干
Codex插件全网最全使用指南:从入门到榨干
Claude Fable 5全网最全使用指南:从入门到榨干
Open 家族神器全网最全盘点:从入门到榨干