
Claude 终于会看视频了:这个 /watch Skill 值不值得装
Claude 终于会看视频了?
没那么简单。
最近 GitHub 上的 Claude Video 项目很火。你给它一个 YouTube 链接或本地视频,再输入 `/watch`,它会获取字幕、抽取关键画面,把文字、图片和时间线一起交给 Claude。
项目在 2026 年 7 月下旬已经获得约 1.18 万 Stars。
但 Star 数只能说明大家感兴趣,不能说明它真的看懂了视频。
我更想知道:它有没有提供字幕之外的信息?抽出来的画面准不准?为了这些信息,又要付出多少下载和上下文成本?
受控测试使用了一段本地录屏和两段公开 YouTube 视频。
结论是:Claude Video 不是让 Claude 完整观看视频的原生视频模型。它是一条视频预处理流水线。
如果任务需要画面证据,它有价值。
如果只是总结口播,它可能反而做多了。
`/watch` 实际做了什么
Claude Video 当前公开版本是 `v0.2.0`,采用 MIT 协议。
它主要依赖两个工具:
- `yt-dlp` 获取视频信息、字幕和视频文件。
- `ffmpeg` 提取关键帧、场景变化帧或均匀采样帧。
处理完成后,整段视频不会直接进入 Claude。
Claude 实际拿到的是一组 JPEG 图片,以及一份带时间戳的字幕。Agent 再把某一秒出现的画面和当时说过的话放在一起分析。
所以更准确的说法是:它把连续视频压缩成了多模态模型可以阅读的上下文。
一段 30 帧每秒的视频,每分钟有 1800 帧。Claude Video 不会看完每一帧,只会挑出几十到一百张代表画面。
它提供四种模式:
- `transcript`:只取字幕。
- `efficient`:快速抽关键帧,最多 50 张。
- `balanced`:识别场景变化,最多 100 张,默认使用。
- `token-burner`:保留更多场景候选,消耗也更高。
相邻的近似图片还会被删除,避免一张静止幻灯片反复占用上下文。
它解决的不是“完整观看”,而是“怎样用有限的图片,让 Claude 尽可能知道画面发生过什么”。
画面确实补上了字幕缺失的信息
第一组受控测试制作了一段 15 秒的本地录屏。
三个画面各持续 5 秒:
```text STEP 1 - LOGIN ERROR - PAYMENT FAILED STEP 3 - RETRY SUCCEEDED ```
使用 `balanced` 模式、最多 20 帧,并关闭外部语音转写后,工具留下三张图,时间点分别是 00:00、00:05 和 00:10。
00:00,第一张保留帧准确显示登录步骤:
https://x.com/i/article/207950693339728281600:05,画面切换到支付失败:
https://x.com/i/article/207905466178142617600:10,第三张保留帧显示重试成功:
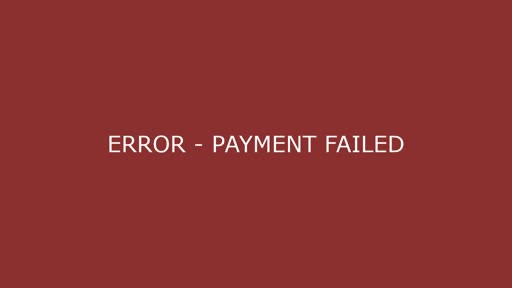
三张图来自本次自制测试视频的原始输出,不是后期重绘。人工核对后,画面内容和时间点都一致。另有 12 张近重复画面被去掉。
这类操作录屏正是它擅长的场景。
字幕可能只说“我点这里之后出错了”。真正重要的信息却在界面上:错误何时出现,哪个区域变化,重试后恢复到什么状态。
第二次测试使用了一段 19 秒的公开 YouTube 视频。
工具取得 6 段英文字幕和 19 张时间对齐的画面。
字幕提到“我们在象的前面”,而画面还能显示:人物在前景,象在围栏后的背景,不同时间点的位置和姿态有所变化,镜头整体基本固定。
这些信息没有完整出现在字幕里。
这能证明两件事:
- 采样画面与时间点能够对应。
- 画面能提供字幕之外的上下文。
但它不能证明 Claude 理解了连续运动,更不能证明它看到了每一个瞬间。
如果错误提示只闪现 0.2 秒,或者关键动作发生在两张采样图之间,它仍然可能错过。
不是所有视频都需要抽帧
第三次测试是一段 8 分 36 秒的演示视频。
使用 `transcript` 模式后,工具取得 278 段英文字幕,没有下载视频,也没有抽取画面。
如果问题只是“这段视频讲了什么”“帮我整理章节”“作者给了哪些建议”,字幕通常已经够用。
再下载视频、抽 80 张或 100 张图片,不一定明显改善答案,却一定会增加处理时间和图片 Token。
我会优先给这些视频开启画面模式:
- 竞品广告、产品发布、短视频钩子。
- 带图表、幻灯片或代码演示的课程。
- 需要确认按钮、菜单和状态变化的软件教程。
- 画面比口头描述更关键的故障录屏。
访谈、播客式视频、会议讲话和纯口播总结,先用 `transcript`。
更合理的方式不是一开始就扫描整条视频,而是先读字幕,定位“看这里”“这个图”“接下来我点击”之类的时间点,再补对应区间的画面。
真正的成本,不在这条命令
Claude Video 看起来像一条命令就能用,但实际成本藏在依赖、下载和隐私里。
依赖与平台限制
测试一开始,系统中的旧版 `yt-dlp` 无法识别用户配置里的新参数。
换到一次性最新版后,YouTube 视频可以处理,但过程中仍出现缺少 JavaScript runtime、缺少 impersonation target 和字幕请求限流等警告。
这次成功,不代表以后每条视频都会成功。YouTube 的下载策略、工具版本、网络状态和平台限制都可能改变结果。
聚焦模式仍可能下载完整视频
受控测试还尝试只分析一条 8 分 36 秒视频中的 30 秒区间。
当前代码仍然先下载完整视频,再限制后续抽帧范围。运行约一分钟还没有进入抽帧阶段,最后主动停止。
所以 `--start` 和 `--end` 能减少图片数量,却不一定减少下载成本。
字幕目前偏向英文
当前下载脚本优先请求 `en.*`。社区已经提交非英语字幕修复 PR,但尚未合并。
这次英文样本能工作,不代表中文视频也能稳定选中字幕。
Whisper 会带来隐私问题
无字幕时,Claude Video 可以提取音频,再发送给 Groq 或 OpenAI 的 Whisper 服务转写。
它不会上传完整视频,但音频本身也可能包含客户名字、会议内容和内部信息。
涉及内部系统、客户数据、账号信息或未公开产品时,要么关闭 Whisper,只处理本地画面;要么不要交给外部转写服务。
另外,公开 Issue 报告过一个文件安全风险:如果复用同一个输出目录,并把源视频放在里面,某种重跑方式可能误删源文件。
这次没有独立复现。但对重要素材,最稳妥的方式仍是把源文件与临时输出目录分开。
所以,这个 Skill 值不值得装
如果你经常拆竞品视频、研究短视频钩子、看带图表的课程,或者分析公开的产品操作录屏,值得试。
它把下载、字幕、抽帧、去重和时间线整理成了一条完整流程,比手动截图再逐张上传省事很多。
如果你主要处理访谈、播客式口播和会议讲话,先别急着下载画面。`transcript` 足够时就停下来。
如果你需要稳定处理中文视频,经常分析敏感录屏,要求完全开箱即用,或者无法接受长视频下载和图片 Token 成本,当前版本还不适合作为默认工具。
我更推荐把它拆成四步:
- 先获取字幕。 判断问题能不能只靠文字回答,能回答就不下载视频。
- 再定位关键时间段。 从“看这里”“这个图”“接下来我点击”等提示中找到需要画面的部分。
- 只为关键区间补帧。 优先使用 `balanced`,并控制图片数量。
- 最后人工核对。 检查决定结论的截图、时间点和前后状态,不把采样帧当成完整视频。

这样用,Claude Video 不是“AI 替你看完所有视频”,而是一个视频研究助手。
它真正值得关注的地方,不是让 Claude 突然拥有了一双眼睛,而是把连续视频转换成 Agent 已经会处理的图片和文字,再用时间戳把它们重新对齐。
很多 Agent 工作流都可以沿用这个思路:不必等待模型原生支持每一种文件,只要找到可靠的转换方式,保留来源、时间线和验证入口,复杂输入就能进入现有能力范围。
但转换不等于理解。
抽到关键帧,不等于看完整条视频;拿到字幕,不等于理解所有画面;生成一份流畅总结,也不等于每个判断都经过核对。
所以,这个 `/watch` Skill 值得装给需要画面证据的人。
不是因为 Claude 真的会看视频了,而是因为它终于拿到了一份比字幕更接近视频的上下文。
你最想用它分析哪类视频?欢迎在评论区聊聊。
历史文章推荐
- Skill 实战:做一个提示词工作台
- Skill 除了安装,还可以融合
Hi,我是 爱学习的Niko。17 年程序员老兵,现在每天用 AI 写代码,搞创作。这里分享学习和使用 AI 的经验、技术思考、踩过的坑、实用工具和 SKILL。关注我,一起学习。