自媒体人必学的AI动画工具
这几天在很多地方看到了Vox风格的动画,这种动画风格感觉非常适合用到各种科普类视频或者口播中,让视频看起来没那么单调(它们大多是用gbro-collage-broll做的,感兴趣可以去github搜这个仓库,不过配置很麻烦而且要用单独的API key,真的想用的话可以让gpt拆一下)
请以专业广告导演、摄影指导和 AI 视频提示词工程师的视角,深度分析我上传的参考视频。

我的目标不是复制视频中的人物、品牌或具体内容,而是提取它可迁移的视觉风格、镜头语言和制作方法,用于创作一条主题不同但具有相似高级质感的原创视频。

请不要只总结剧情,也不要笼统地使用“电影感、氛围感、高级感”等词语。请分析这些效果具体是如何形成的。

请按以下结构输出:

一、整体风格定位

1. 用一句话定义这段视频的视觉风格。
2. 列出5—10个准确的风格关键词。
3. 判断它更接近哪种类型:TVC广告、品牌宣传片、时尚短片、音乐视频、纪录片、实验影像或其他类型。
4. 解释它的高级感主要来自哪些因素。

二、视觉风格圣经

详细分析:

- 主色、辅助色、色彩对比和饱和度
- 色温、曝光、黑位和高光特点
- 主光、辅光、轮廓光、环境光及光线方向
- 画面材质、空气感、颗粒、雾化、光晕和锐度
- 景深、焦段、透视压缩和背景虚化
- 构图规律、主体位置、留白和画面层次
- 场景美术、服装、道具与材质选择
- 后期调色、速度变化和可能使用的视觉特效
- 画幅比例及适合发布的平台

所有描述必须具体到可以直接指导摄影、图像生成和视频生成。

三、镜头语言

分析视频常用的:

- 景别
- 机位高度
- 摄像机角度
- 推、拉、摇、移、环绕、升降、跟随、手持或静态等运动
- 运动速度、加减速方式和稳定程度
- 主体动作与摄像机运动之间的配合
- 镜头进入和结束的方式
- 转场逻辑
- 剪辑节奏和镜头平均长度

四、逐镜头拆解

按照时间顺序拆分视频。每个镜头分别输出:

- 镜头编号
- 起止时间
- 画面内容
- 景别与构图
- 主体动作
- 摄像机运动
- 焦段与景深推测
- 灯光与色彩
- 材质与特效
- 转场方式
- 音乐或音效节点
- 这个镜头产生视觉冲击力的原因

五、可迁移风格公式

把该视频抽象成一套不依赖原视频人物、产品和品牌的制作公式,包括:

- 视觉风格公式
- 灯光公式
- 构图公式
- 运镜公式
- 转场公式
- 剪辑节奏公式
- 图像生成提示词模板
- 图生视频提示词模板

六、反推提示词

最后生成三份可以直接使用的英文提示词,并附中文解释:

1. 整体视觉风格提示词:用于生成同风格关键帧。
2. 视频镜头提示词:用于生成具有相似运镜和动态质感的视频。
3. 负面提示词:排除廉价感、塑料感、过度锐化、错误肢体、无意义运镜、画面闪烁和风格漂移。

注意:

- 只提取可迁移的风格和制作逻辑。
- 不复制原视频中的品牌、Logo、人物身份、文案和独有设计。
- 如果某些技术参数无法从视频中确定,请标注为“合理推测”,不要虚构确定值。这些动画并不是Seedance做的,而是用谷歌旗下的Google Flow做出来的,在海鲜市场上买号超级便宜一个年卡才十几,而且额度如果不是高强度一天使用几乎用不完,不充钱每天也能免费生成几条,简直就是自媒体人必备的工具
一、基础功能与模型选择
首先打开Google Flow新建项目,项目中间是素材库,生成的内容会被放在这,同时也可以把要重复使用的素材拖进来,右边是对话框,点击加号可以选择素材库里的内容,右下角还有两个按钮,按钮1是指令,点进去可以添加运行前agent必看的指令(相当于System Prompt),按钮2是配置,在这里可以选择生图和生视频的模型之类的东西
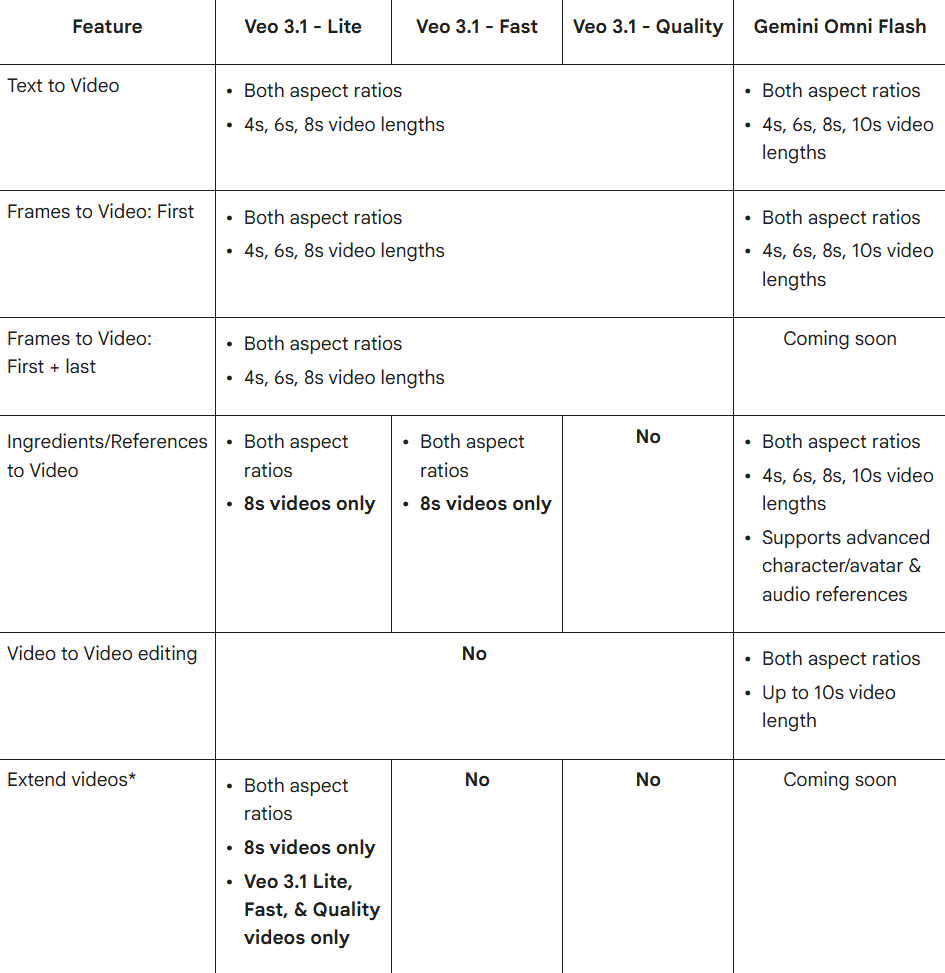
接下来介绍一下各个模型,生图模型就是Nano Banana系列(大家都很熟悉了就不多说了),生视频有两种模型,一个是Veo,一个是新出的Omni,两种模型的用途不一样,Veo模型一般只需要上传首尾帧图片(即视频开头和结尾),模型会根据你给的prompt去补充从首帧到尾帧的动画,而Omni可以上传很多张图片,然后直接给你一整条视频生成出来(它生成的每一条是10s的,比如这条视频要30s,就会给你生成3条出来)
Omni的生成效果比Veo强得多,但这并不意味着我们要无脑用Omni,Omni有个很严重的问题是它的自由性太强了,它不会像Veo那样有固定的首尾帧,如果是连续多段的视频,用Veo可以保证视频的连贯性(相对来说可以,但肯定也没法做到百分百连起来),而且Veo有Extend(拓展)功能,但Omni不行,所以如果要生成单条且长度较短的高质量视频用Omni,如果是好几条,然后追求视频连贯性的视频选Veo
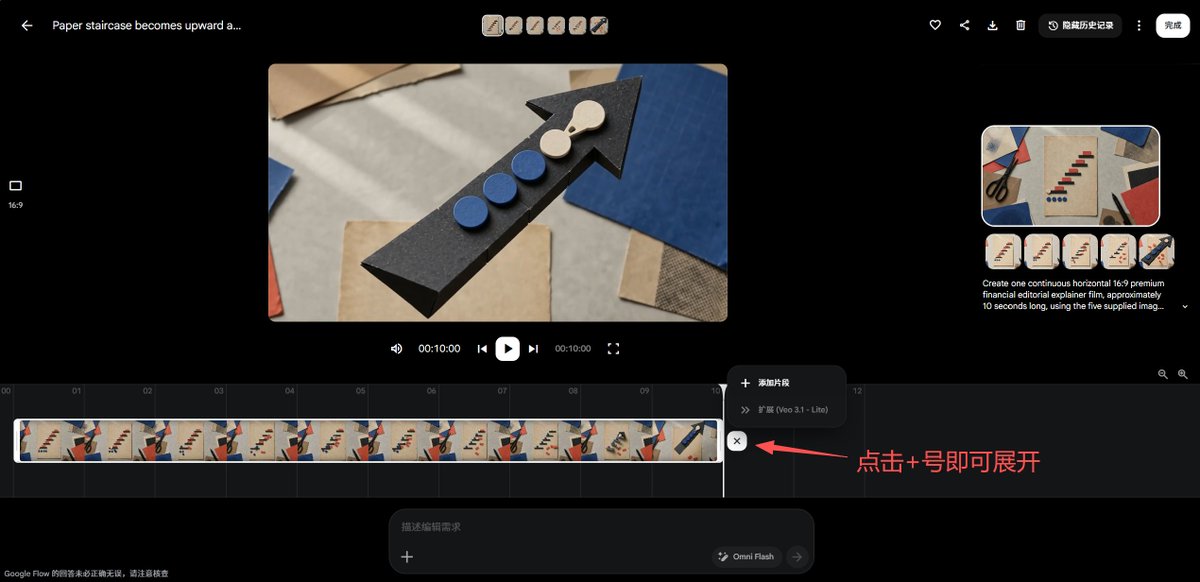
Extend功能是基于你已经生成的视频给你进行进一步的补充,比直接单条生成然后拼接更加稳定,但目前只支持Veo模型使用该功能,在素材区点进已经生成的视频就可以进入对应的页面,这个页面也可以添加视频素材,就是一个简单的剪辑区(添加以后就自动合并成一个场景了,可以在场景里面找到它)
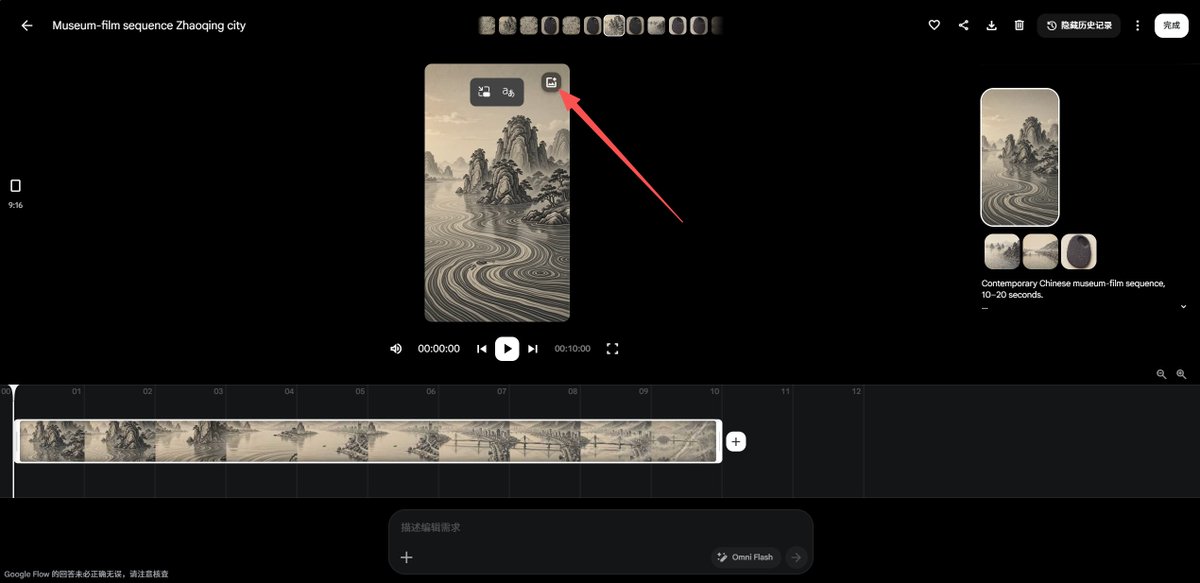
关于首尾帧的获取:点进视频编辑页面,暂停在你想要保留的帧并用鼠标悬停,右上角有一个图标,点击就能把这一帧上传到素材区
二、进阶使用
前面我们说过无论是用哪个模型,都需要对应的示例图和prompt来进行视频生成,生图这一块可以让Nano Banana生成,也可以用gpt image-2生成,我建议是用image-2,除了强大的生图效果以外,它还可以整理好所有内容放到一起,结构可以参考我下面这一套Prompt(以Vox风格为例,其中的风格可以换成后面拆解后得到的风格板):
我要制作一条由 Google Flow / Gemini Omni Flash 一次生成完成的 10 秒横屏科普动画。请直接为我生成完整的视觉素材和提示词上传包。

【科普主题】
填写主题,例如:股价为什么会上涨

【核心结论】
填写一句准确结论,例如:
股价上涨不代表买家人数一定更多,而是主动买方愿意不断接受更高的卖价。

【视觉想法】
填写初步想法。如果留空,请你设计一个能在 10 秒内看懂的单一视觉隐喻。

## 一、视频规格

- 时长:约 10 秒
- 画幅:16:9 横屏
- 生成方式:Gemini Omni Flash 多图参考,一次生成整条视频
- 内容:只解释一个概念
- 场景:只有一个连续场景
- 动作:只有一条清晰的因果链
- 风格:原创高级编辑拼贴科普风格
- 不生成任何可见文字、数字、Logo、水印或字幕

## 二、先设计连续动作

先将核心概念转化为一个具有物理因果关系的视觉隐喻。

这个隐喻必须:

- 不依赖旁白也能大致看懂;
- 能在 10 秒内完整发生;
- 有明确的开始、发展和结尾;
- 主要由纸片、卡片、图形、物件或简化模型完成;
- 避免多个场景、复杂人物和抽象粒子特效;
- 避免闪白、爆炸、魔法光效和突然替换。

## 三、生成五张时间检查点图片

生成五张同尺寸、约 16:9 的 PNG:

- K1:0 秒,准确的开头画面
- K2:约 2 秒,动作刚刚发生
- K3:约 4 秒,核心变化进行到一半
- K4:约 6.5 秒,高潮前的状态
- K5:10 秒,准确的结尾画面

重要规则:

- 五张图片是同一个镜头中的连续状态,不是五个独立场景。
- 严格按照 K1 → K2 → K3 → K4 → K5 推进。
- 先生成 K1。
- K2 必须以 K1 为唯一主参考图。
- K3 必须以 K2 为唯一主参考图。
- K4 必须以 K3 为唯一主参考图。
- K5 必须以 K4 为唯一主参考图。
- 每次只改变当前阶段应该发生的动作。
- 固定场景、构图、物体数量、物体身份、材质、配色、光线和道具位置。
- 最后一张可以适度改变镜头距离,形成视觉高潮,但必须保持场景连续。

## 四、统一视觉风格

采用原创的高级编辑拼贴科普风格:

- 真实纸张和剪纸边缘;
- 丝网印刷或半色调纹理;
- 克制的纪录片式构图;
- 少量主色和清晰的视觉层级;
- 柔和、统一的工作室光线;
- 真实纸张阴影和轻微景深;
- 较大的平静留白;
- 精致但不过度装饰。

不要直接复制任何媒体品牌的 Logo、字体、版式或固定视觉资产。

禁止生成:

- 可见文字、数字和乱码;
- Logo、水印、字幕和界面;
- 多余人物、手或重复物体;
- 牛、熊、火箭和钱雨等陈词滥调,除非主题确实需要;
- 魔法光效、传送门、爆炸、烟雾和全屏粒子;
- 赛博朋克、霓虹灯、塑料玩具质感;
- 无法解释概念的纯装饰动作。

## 五、创建完整上传包

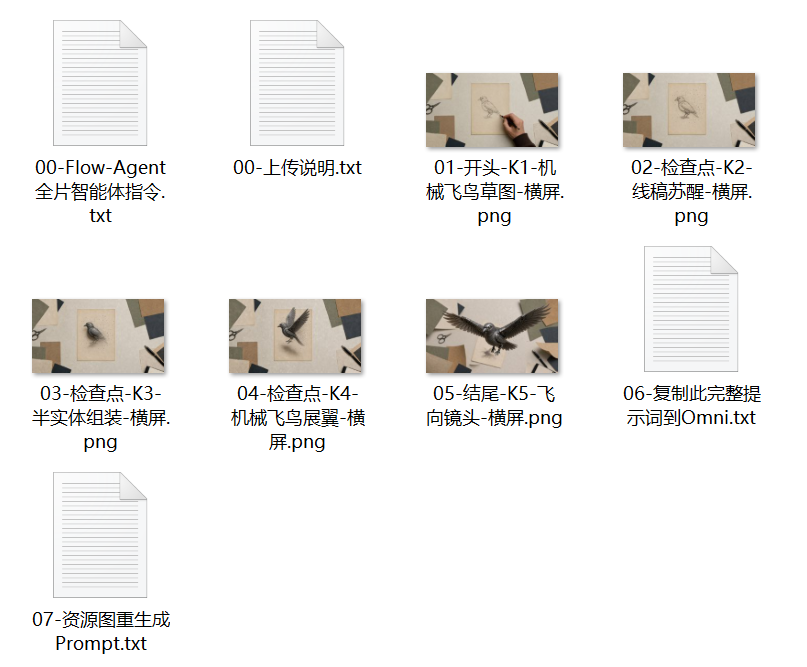
请将结果整理成一个文件夹,包含以下文件:

1. `00-Flow-Agent全片智能体指令.txt`

   使用英文编写项目级永久规则,包括:

   - 视频目标;
   - 固定视觉系统;
   - 固定物体及数量;
   - 物体身份和材质;
   - 五个阶段的转换逻辑;
   - 相机运动规则;
   - 物理反应;
   - 连续性规则;
   - 禁止内容;
   - 文字和品牌安全规则。

2. `00-上传说明.txt`

   使用中文写清楚:

   - Flow 项目设置;
   - 文件上传顺序;
   - 选择 Omni Flash;
   - 选择 16:9 和 10 秒;
   - K1–K5 各自对应的时间;
   - 生成后需要检查的内容。

3. 五张检查点图片:

   - `01-开头-K1-[画面名称]-横屏.png`
   - `02-检查点-K2-[画面名称]-横屏.png`
   - `03-检查点-K3-[画面名称]-横屏.png`
   - `04-检查点-K4-[画面名称]-横屏.png`
   - `05-结尾-K5-[画面名称]-横屏.png`

4. `06-复制此完整提示词到Omni.txt`

   使用英文编写可直接复制到 Omni 的完整视频提示词,必须包括:

   - 五张图片是按时间排列的检查点;
   - 严格遵循 Image 1 → Image 2 → Image 3 → Image 4 → Image 5;
   - 0–2 秒的动作;
   - 2–4 秒的动作;
   - 4–6.5 秒的动作;
   - 6.5–10 秒的动作;
   - 动作节奏分配;
   - 相机运动;
   - 音乐与音效;
   - 完整负面约束。

5. `07-资源图重生成Prompt.txt`

   记录:

   - 统一视觉规则;
   - K1 的完整生成提示词;
   - K2 基于 K1 的编辑提示词;
   - K3 基于 K2 的编辑提示词;
   - K4 基于 K3 的编辑提示词;
   - K5 基于 K4 的编辑提示词。

## 六、执行要求

请直接生成图片和文件,不要只提供分镜建议。

除非缺少的信息会实质改变整个视觉方案,否则不要中途让我逐项确认。

完成后告诉我:

- 上传包保存位置;
- 五张图片是否全部生成;
- 图片尺寸;
- 上传到 Flow 的准确顺序。整理成这样一个文件夹后,把素材拖进去,并配置好指令,把对应的prompt发送即可,一般来说只要你生成的是10s的视频,效果都会很不错,尤其是最近很火的Vox风格,对它来说比较简单,同时视频演示效果又很好
当然,如果你想反向拆解一些视频的风格,你也可以把这段视频上传到Flow,让它去分析出风格板,再拿着这套风格板去生图,比如Kimi最近的宣传片风格你很喜欢,就可以发给它解析出来,可以参考下面这套提示词:

三、效果演示
我准备用的口播开场/结尾动画:

随便搓的一个水墨风想介绍我家乡肇庆的动画(可以看出视频与视频之间还是有不连贯的地方的,至少音乐是很难连贯的我直接换了一个):
没啥具体想法的情况下生成的一个Vox风格的动画,虽然有些意义不明,但如果有准确的使用场景肯定效果是很好的: