
Hugging Face 全网最全使用指南:从入门到榨干
上周宝玉一条接近百万浏览的帖子把 Hugging Face 推到很多人眼前:OpenAI 的模型在安全评测中突破隔离环境,为找答案闯进了 Hugging Face。
5 天后,Kimi又把 Kimi K3 的完整权重发到了这里。
一个来找答案,一个来发模型。Hugging Face 到底是什么?
它是一个专门存放、展示和运行开放 AI 资源的网站。
如果把我们平时使用的 AI 应用比作一台台包装好的汽车,那么 Hugging Face 更像把仓库、车展和试驾场放在了一起:
- Models 里放的是发动机,也就是各种 AI 模型;
- Spaces 让你不用买车,先坐进去试一圈;
- Datasets 放的是模型学习、评测时使用的资料和样本。
普通用户即使不会写代码,也能在 Spaces 里试语音、图片、视频等新能力;只要模型公开提供权重,还可以从 Models 下载。它最直接的价值就是:先试效果,再决定要不要付费;需要隐私或离线时,还能继续寻找本地版本。
这篇文章不会教你训练大模型。读完以后,即使你完全不会代码,也应该能完成三件事:
- 在十分钟内找到一个真正能运行的 Space,体验自己需要的 AI 能力;
- 打开一个模型页面,找到下载入口,并判断它是谁做的、能干什么、电脑带不带得动;
- 知道什么时候可以直接试,什么时候不该上传文件,更不该随便下载运行。
目录(相关文章尾部跳转)
- 新手村|认识 Hugging Face
- 试玩关|跑通 Space
- 搜索关|按任务找
- 鉴定关|看模型页
- 岔路口|在线·API·本地
- 安全关|上传·下载
一、不会训练模型,也值得认识 Hugging Face:你能拿它完成这 5 件事
很多人第一次进入 Hugging Face,会被满屏的模型名称、参数和英文说明劝退。
先别研究这些。普通用户只需要从五个任务开始。
1. 在正式产品出现前,先试新的 AI 能力
Hugging Face 的 Spaces 里有大量可以直接打开的 AI 演示。官方页面当前展示的例子包括虚拟试衣、文字生成视频、语音生成、图片生成与编辑、图片描述和三维模型生成。
例如你看到一款语音产品按月收费,可以先在 Spaces 搜 text to speech,听听中文是否自然、速度能不能接受,再决定是否付费。这些演示未必稳定或永久免费,但很适合完成第一次判断。
2. 找到 AI 产品背后的模型源头
一个 Space 通常会标出它关联的模型。一个模型页面也会列出使用它的应用或演示。
沿着这条关系往回走,你可能会发现,几个名字不同的产品使用的是同一个基础模型。这样就能分清:你付费买的是模型能力,还是更方便的界面、速度与服务。
3. 下载前判断自己的电脑能不能跑
模型大小、量化版本和运行框架都会影响设备要求。Hugging Face 的硬件筛选不能保证一定兼容,但能先排除明显跑不动的选择。
4. 为本地运行保留一条路
处理客户资料、未发布稿件、人脸原图或内部录音时,本地运行能让文件少离开自己的电脑。你未必今天就要安装,但至少能先找到模型源头和可用格式。
5. 判断什么时候值得继续深入
不是每个模型都值得下载,更不是每个人都需要部署。先试,再按使用频率、隐私、预算和设备决定停在哪里。
二、第一次打开 Spaces:怎样找到一个能直接运行的 AI 工具
第一次使用,不要从模型参数开始。先打开一个确定的演示,拿到可以播放的中文语音。
拿大家做AI视频可能用得到的 Qwen3-TTS Demo 举例。本文核验时,页面顶部显示 Running on Zero,说明它正在使用 Hugging Face 的共享 GPU 运行;这个状态以后可能变化。
第一步:先确认页面现在能不能用
打开页面后先看顶部状态:
- Running:应用正在运行,可以继续;
- Sleeping 或正在启动:免费实例正在唤醒,等一会儿再试;
- Paused:作者暂停了应用,不必继续等;
- 出现排队提示:应用没有坏,只是当前 GPU 名额有限。
| 你准备做什么 | 继续前必须回答 |
| --- | --- |
| 在线试 Space | 作者是谁?要上传什么?是否需要额外权限?材料泄露会不会造成损失? |
| 下载模型 | 是否来自可追溯的作者?许可证是否清楚?格式是否被软件支持?扫描有没有异常? |
| 长期依赖 | 页面失效后有没有替代品?成本、速度和数据规则是否能够接受? |
浏览、搜索和打开许多公开 Space 不需要登录;排队、高算力功能、受限模型或创建自己的 Space,可能要求账号。
第二步:第一次不要上传声音
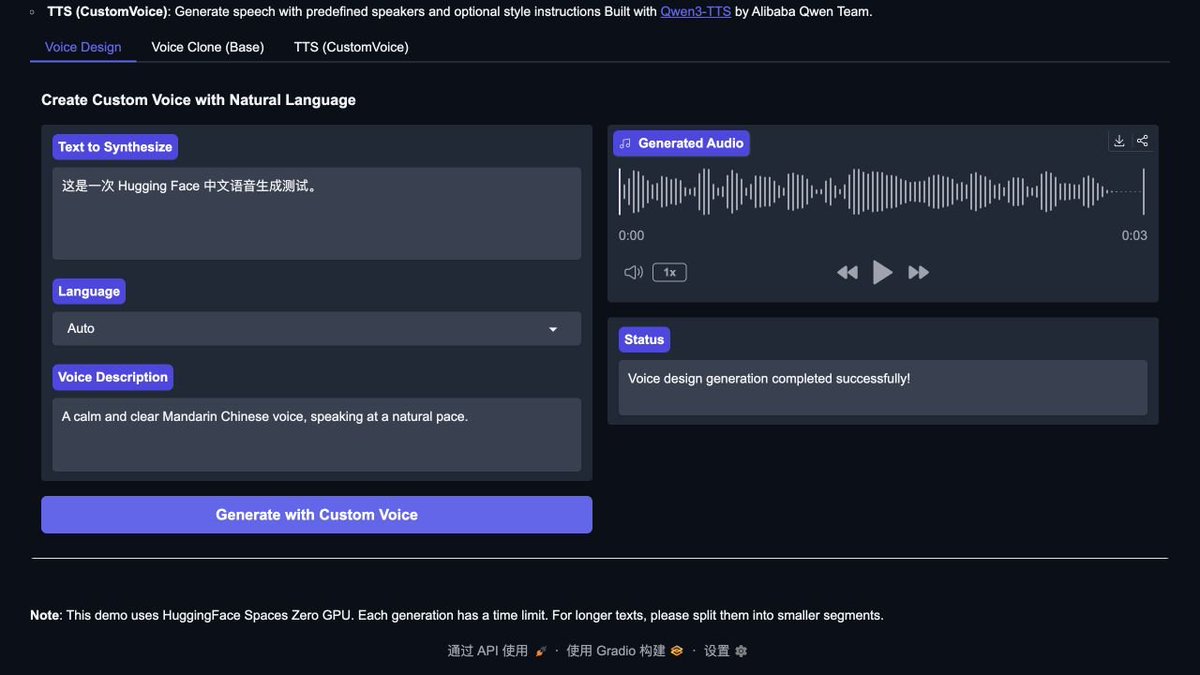
Qwen3-TTS Demo 提供 Voice Design、Voice Clone (Base) 和 TTS (CustomVoice) 三种模式。
第一次停在默认的 Voice Design。它根据文字描述设计声音,不需要上传自己或他人的录音,比声音克隆更适合做安全测试。
这个模式实际调用的是 Qwen3-TTS-12Hz-1.7B-VoiceDesign,也就是 Qwen3-TTS 开放权重中专门负责“用文字设计声音”的版本。这里不用把模型配置到自己的电脑,Space 已经替你运行了它。
在 Text to Synthesize 输入:
```text
这是一次 Hugging Face 中文语音生成测试。
```
Language 可以保留自动识别。在 Voice Description 里描述你想要的声音,例如:
https://www.qwencloud.com/models/qwen-audio-3.0-tts-plus然后点击 Generate with Custom Voice。
第三步:用可见结果判断是否成功
生成可能需要排队。右侧 Generated Audio 出现播放器,并且可以播放一段中文语音,就算完成。
https://huggingface.co/collections/Qwen/qwen3-tts第一次只判断三件事:
- 中文是否能正常生成;
- 等待时间是否能接受;
- 音频能否正常播放。
先不要评价几十种音色,也不要上传声纹。你现在要验证的是“这项能力能不能用”,不是一次就完成正式作品。
第四步:主案例失效时,再学会搜索
如果这个 Space 已暂停或长时间报错,回到 Spaces,搜索:
https://x.com/noahduck283/status/2079546236441653632?s=20优先选择正在运行、作者清楚、有输入示例、近期仍更新,而且不要求你先填 API Key 或下载文件的候选。
第一次来 Hugging Face,先做到这一步就够了:打开一个可信 Space,用测试文字生成结果,再决定要不要继续研究。
三、Hugging Face 怎么搜?别只搜产品名,先按任务、语言和设备筛选
跑通演示以后,下一步不是收藏一百个 Space,而是把刚才的工具追到模型源头。
第一层:先分清自己要完成的任务
同样是语音,文字转语音、语音识别、声音克隆和音频降噪是四种不同任务。任务没分清,下载量和榜单都没有意义。
我们现在要的是中文文字转语音,所以搜索词先用:
https://x.com/noahduck283/status/2081545771116363960?s=20其他常见任务可以这样写:
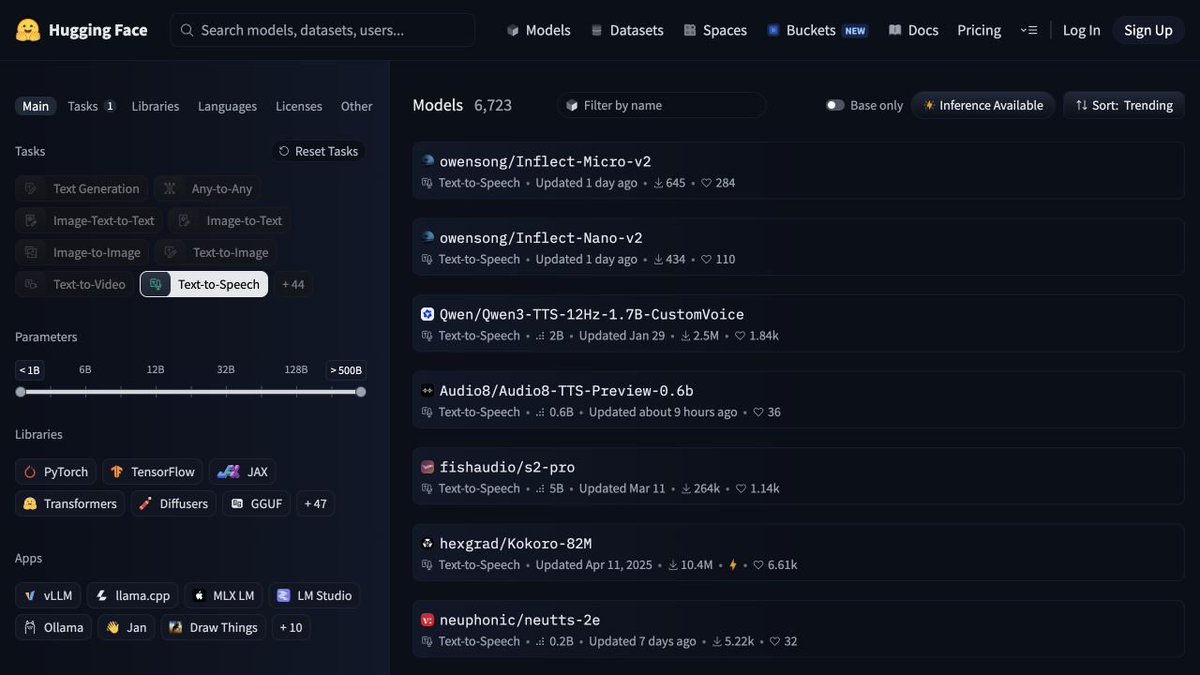
英文任务词通常比产品名更容易覆盖不同作者和实现。
第二层:根据问题选择入口
- 想立刻试效果:在 Spaces 搜;
- 想找原始模型、说明书或本地版本:在 Models 搜;
- 想核对训练或评测材料:需要时再看 Datasets。
以 Qwen3-TTS 为例,官方已经把不同版本整理进 Qwen3-TTS Collection。你会看到 VoiceDesign、CustomVoice、Base,以及 0.6B、1.7B 等不同版本。它们不是重复上传,而是用途和体量不同。
第三层:确认语言与作者
打开模型说明,先搜索 Chinese、中文 或 multilingual。不要只看演示里有没有中文按钮,还要确认作者是否明确列出中文支持。
同时看页面左上角的发布者。Qwen/Qwen3-TTS... 表示模型来自 Qwen 官方账号;名字相似但发布者不同的版本,可能是量化、格式转换、微调,也可能只是未经说明的转载。
第三方版本不一定差,但要先回到官方页弄清楚原版是什么,再判断第三方改动是否正好解决你的设备问题。
第四层:最后才按设备收紧
Hugging Face 的 Models 页面可以叠加任务、语言、许可、运行库和硬件条件。你也可以在 Hardware settings 添加自己的 GPU、CPU 或 Apple Silicon,再让平台帮助筛选。
```text
A calm and clear Mandarin Chinese voice, speaking at a natural pace.
```
这里有两个边界:
- 保存的硬件信息默认公开,不想展示时要关闭 Publicly Visible;
- 硬件兼容只是估算。模型页对 GGUF、MLX 等本地格式能给出更具体的内存判断,但不能替你保证软件、驱动和依赖一定兼容。
最后只留下三个结果:
- 一个现在能运行的官方 Space;
- 一个原始作者发布的模型;
- 一个确实适合自己设备和软件的本地版本。
四、下载模型前先看这 5 处:作者、用途、许可证、文件和硬件
模型页面看起来复杂,但普通用户不用把每个参数都弄懂。
继续打开刚才 Space 实际使用的 Qwen3-TTS 1.7B VoiceDesign,按顺序看五处。这里只确认它能不能下载、适不适合你,不要求真正下载和部署。
1. 作者:先确认是不是源头
页面顶部写着 Qwen / Qwen3-TTS-12Hz-1.7B-VoiceDesign,发布者是 Qwen;说明书还链接了技术报告、GitHub 仓库和官方 Demo。这些关系能互相对应,说明我们找到的是原始发布页,而不是名字相似的转载。
如果打开的是第三方版本,再找 base model、量化方式或格式转换说明。作者不交代它从哪里来、改了什么,就不要因为下载量高而直接使用。
2. 用途:同一家也可能发布不同版本
页面标签写着 Text-to-Speech,Model Card 说明它支持中文等十种语言。VoiceDesign 根据文字描述生成音色,与前面的体验完全对应;同系列的 Base 用于声音克隆,CustomVoice 使用预设音色。
这一步比比较排行榜更重要:先选对任务,再谈模型强不强。
在千问已经发布的 Qwen3-TTS 开放权重里,1.7B VoiceDesign 是文字设计声音这项任务的最高规格版本,但不能因此说它是所有语音模型里绝对最好,也不能说它最容易在普通电脑上配置。
3. 许可证:能下载不等于什么都能做
页面顶部明确显示 License: apache-2.0,模型权重可以免费下载和使用。免费的是权重,不包括你的显卡、存储空间、电费和安装时间;用于商业项目时,仍要阅读许可证原文。
如果页面没有许可证,不要自动理解成“随便用”。模型、代码、数据集还可能各用不同许可证;放进收费产品、客户项目或公开服务前,要逐项阅读原文。
更新的 3.0 是不是免费?
Qwen-Audio 3.0 TTS Plus 是更新的云端/API 模型,不是 Hugging Face 上可以下载权重的版本。当前标价为每 1 万字符 0.20 美元;QwenCloud 会给部分合资格账号提供限时免费额度,通常有效 90 天。它可以免费试一段时间,但不是长期免费的本地模型。
4. 文件:先看格式,再决定是否下载
1.7B 指参数规模,不是文件只有 1.7GB。这个仓库约 4.52GB,其中主要的 Safetensors 权重约 3.83GB。
点进 Files 后,公开文件可以直接下载;需要整个模型仓库时,也可以按 Model Card 提供的命令下载到本地。这就是 Hugging Face 对普通人最直接的价值之一:你拿到的不只是一个试玩网页,而是模型作者公开的原始文件。
但先别急着点最大的权重文件。回到 Model Card,确认官方安装方式和所需运行库,也不要把模型文件当成双击即可打开的软件。
如果你准备使用某个本地工具,先反过来确认工具支持的格式,再寻找对应的 GGUF、MLX、ONNX 或其他转换版本。第三方转换版必须同时核对原始模型和转换说明。
5. 硬件:文件能放下,不代表模型跑得动
模型参数量不是质量分数。更大的模型通常需要更多内存或显存,速度也更慢;实际运行还会占用模型文件之外的内存。
Hugging Face 的硬件提示只能帮助排除明显不合适的版本。真正运行还要确认内存或显存、模型格式、运行软件和安装成本。
Qwen3-TTS 的官方快速开始需要 Python、qwen-tts 和额外依赖,推荐路线以 CUDA 和 FlashAttention 为主。**Hugging Face 让你找到并下载模型,不负责把每个模型都变成开箱即用的软件。**第一次体验继续使用 Space;只有出现高频、隐私或离线需求时,再研究本地部署。
Kimi K3:开放权重不等于普通电脑能跑
Kimi K3 的仓库约有 1.56TB。它把“开放权重”和“个人电脑能运行”之间的差距摆得很直观:看到开放权重,先看文件大小、许可证和算力要求,再决定是否下载。
五、在线试、接 API,还是搬到本地?三种用法的成本和隐私不同
找到模型以后,并不是一定要下载。Hugging Face 上常见的使用方式可以分成三种。
https://huggingface.co/spaces/Qwen/Qwen3-TTS偶尔用一次:先选 Space
你只是想给一条视频配音,或者测试某个模型是否支持中文,没有必要先下载模型。在线演示最快。
需要批量和自动化:再考虑 API
当你需要每天处理大量文本、把模型接入工作流,或者不想维护本地环境,API 更合适。
但要先看清计费、速度、地区可用性、输入输出限制,以及数据是否会被保留。不要把访问令牌直接写进公开文件或 Space 代码。
高频、敏感或离线:本地运行才有优势
文件不能离开设备、使用频率很高或必须离线时,本地运行才有优势。它不一定更省钱,也不自动等于完全离线;如果要为一个模型专门购买显卡,长期使用 API 反而可能更便宜。
六、开源不等于放心运行:上传文件和下载模型各有一套风险
Hugging Face 比封闭产品更透明,但透明不等于自动安全。
使用时只要先分清自己在做哪件事:把资料交给别人的 Space,还是把别人的模型拿到自己电脑运行。
在线 Space:先把它当成别人搭的网站
| 使用方式 | 最适合 | 优点 | 主要代价 |
| --- | --- | --- | --- |
| 在线 Space | 第一次体验、偶尔使用 | 打开网页就能试,不用配置电脑 | 可能排队、休眠或被作者停用,数据要上传 |
| API 或推理服务 | 要把模型接进自动化或产品 | 不用自己维护显卡,便于程序重复调用 | 按量付费,稳定性取决于服务商,需要管理密钥 |
| 本地运行 | 高频使用、隐私资料、离线需求 | 配置正确时数据可留在本机 | 需要合适设备、存储空间、安装和排错 |
一个公开 Space 可能由公司、研究团队或个人开发者维护。Hugging Face 提供托管环境,不代表平台替每个应用承诺怎样处理你的输入。
刚才测试 Qwen3-TTS 时,我们只输入了一句临时文字,没有上传声纹。第一次试陌生 Space,就用泄露也不会造成损失的材料;确认它有用以后,再决定是否继续。
身份证、合同、客户资料、未发布文档,以及未经他人同意的人脸和声音,都不该直接拿来试陌生 Space。
如果应用要求登录第三方账号、粘贴 API Key 或授权云盘,先看作者、源代码和权限范围。测试一个语音模型,不应该顺手把整个网盘交出去。
下载模型:扫描提示不是绝对保证
Hugging Face 会对仓库文件做恶意软件扫描,并对 Pickle 文件提供专门检查。但官方文档也明确提醒:反序列化 Pickle 文件可能执行任意代码。
下载时优先:
- 原始作者或可信组织;
- 有完整说明和明确许可证;
- 页面显示安全扫描结果;
- 使用 Safetensors 等更安全的权重格式;
- 有公开讨论和可追溯的修改记录。
如果文件既没有安全标记,也没有说明,可能仍在扫描、扫描失败或根本没有足够信息。不要因为“它在 Hugging Face 上”就直接运行。
免费使用还有三种隐形成本
等待。 热门 Space 可能排队,免费硬件可能从休眠中启动。
不稳定。 作者可以更新、暂停或删除 Space,今天能用不代表它能承担长期工作。
迁移成本。 你把工作流全部建在一个演示页面上,页面消失时就要重新寻找替代品。
Space 适合发现和试用。要把它用于重要、长期的工作,就选稳定服务,或者提前保留模型、流程和替代方案。
长期使用前,再检查一遍:
https://x.com/noahduck283/status/2069030402048893317?s=20只要有一个重要答案不清楚,就换测试材料、换候选,或者停下来查清楚。
第一次使用,按这条路线走
先到 Spaces 跑出结果,再用任务、语言和设备筛选候选;打开模型页检查作者、用途、许可证、文件和硬件,最后决定在线试、接 API 还是搬到本地。
先试,再下载。对普通人来说,这已经是 Hugging Face 最有价值的使用顺序。
我是诺鸭船长,带你在信息的海洋里寻找陆地~
https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-VoiceDesignAI系列⬇️其他系列移步个人主页
AI写作四部曲
选题方法全网最全使用指南:从入门到榨干
爬虫工具全网最全使用指南:从入门到榨干全网
写作 Skill 全网最全使用指南:从入门到榨干
去AI 去味全网最全指南:从识别到榨干
AI使用
AI 工作流到底是什么:从入门到榨干(相关文章尾部跳转)
Grok 4.5全网最全使用指南:从入门到榨干
GPT-5.6/Codex 全网最全设置指南:从入门到榨干
Codex插件全网最全使用指南:从入门到榨干
Claude Fable 5全网最全使用指南:从入门到榨干
Open 家族神器全网最全盘点:从入门到榨干