
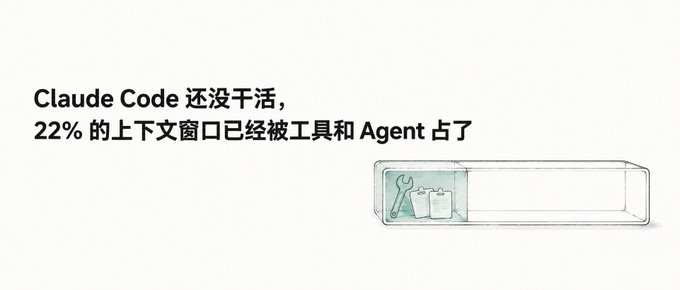
Claude Code 还没干活,22% 的上下文窗口已经被工具和 Agent 占了
我以为 Claude Code 的上下文大头,是聊天记录和 `CLAUDE.md`。
直到我运行了一次 `/context`。
200k 的窗口已经占用 65.4k。`System tools` 占 34.2k,`Custom agents` 占 10k。
两项合计 44.2k,相当于整个窗口的 22.1%。
真正的任务还没开始,工具定义和 Agent 摘要已经先拿走了超过五分之一的窗口。
这不是账单,也不能证明模型一定会变慢。
它证明的是:你写进输入框的提示词,只是模型实际上下文里很小的一部分。
Anthropic 为什么敢删掉 80% 的 system prompt
Anthropic 工程师 Thariq Shihipar 分享过 Claude Code 团队的一次大幅瘦身。
他们为最新一代 Claude 5 模型删除了超过 80% 的 system prompt,在内部编码评测中没有观察到可测量的损失。
这不是“提示词越短越好”。
他们删掉的主要是旧模型时代留下的补丁。
早期模型判断力有限,团队只能把最坏情况写成规则。为了防止它乱加注释,就写“不要加注释”;为了让它完善文档,又在别处写“适当补充文档”。
单独看都合理,放在同一次请求里却会互相打架。
新模型通常能猜到用户真正想要什么,但它必须先解决这些冲突,才能开始任务。
Anthropic 的新方向可以浓缩成三句话:
- 少写只能覆盖少数情况的过程规则,让模型结合上下文判断。
- 少堆工具调用示例,把接口和参数本身设计清楚。
- 不把所有知识放在开头,需要时再加载 Skill、工具定义和参考文件。
不是不要上下文,而是把“全部预装”改成“按任务供给”。
我的 `/context` 里,最大的不是 `CLAUDE.md`
这次 `/context` 显示,总占用是 65.4k。`System prompt` 是 3k,`System tools` 是 34.2k,`Custom agents` 是 10k,`Memory files` 是 115,`Skills` 是 2.1k,`Messages` 是 15.9k。已经注册的 22 个 `MCP tools` 显示为 0 tokens。
这里要先校准一个口径:`/context` 里显示的 200k,是 Claude Code CLI harness 在当前会话实际采用的有效 token 预算,不等于模型官方 API 支持的最大 context window。这次会话使用的 Fable 5 在官方 API 文档中支持 1M context window,因此文中的 22.1% 只对应这次 CLI 会话的 200k 预算。
换成别的模型、网关或配置,这个比例可能完全不同。审计时应该先认清当前会话采用的窗口口径,再讨论哪些内容值得优化。
develop套件注册了 39 个自定义 Agent。进入上下文的不是 39 份完整 system prompt,而是每个 Agent 的名称和描述摘要。仅这些摘要,就占了 10k,约为整个窗口的 5%。
`System tools` 和 `Custom agents` 合计 44.2k,相当于整个 200k 窗口的 22.1%,也接近当时已使用上下文的三分之二。
相比之下,Skills 摘要一共只有 2.1k,22 个 `MCP tools` 显示为 0 tokens。
这不代表 Skill 和 MCP 没有成本。完整说明仍会在真正调用时进入上下文。它说明的是加载方式不同:一套很长的专项流程,如果只在相关任务里出现,通常比把同样的内容塞进每次会话都要经过的根规则更合理。
所以,我不会因为 Skill 数量多就先清空它们。更值得优先检查的,是那些长期常驻、彼此重叠,却很少在真实任务里发挥作用的说明和能力。
会话后来给出了单个 system tool 各占多少 token 的估算,但那是模型根据工具定义篇幅推算的,不是 `/context` 的原始测量。这也是上下文审计容易踩的坑:数字只要带上小数点,看起来就很可信。可如果没有明确的测量入口,再精确也只是估算。本文只使用这次 `/context` 中可以直接核对的数据。
上下文其实有四种成本
第二篇参考文章把上下文分为长期指令、记忆、知识与文件、工具与连接器四层。
结合这次实测,我更愿意按加载方式把它们分成四类。

常驻成本
System prompt、项目根规则、常见工具定义、Agent 名称和描述,任务开始前就已经存在。
常驻不是坏事。但每一项都应该回答:它真的值得每次都让模型看到吗?
按需成本
Skill、deferred tools、专项验证流程和详细参考资料,需要时再加载。
它们可以写得很深,但不必进入每一个无关任务。
动态成本
对话消息、读过的文件、工具返回和中间结果,会随着工作自然增长。
它更适合通过拆分任务、压缩历史和结束无关会话管理。
历史遗留成本
过期记忆、重复文档、不再使用的连接器,以及旧模型时代留下的行为补丁。
它们不只是占空间,还可能继续以“当前事实”的身份影响模型。
真正麻烦的不是长,而是冲突
长上下文不一定差。
复杂任务需要完整规格、代码、测试和历史决策时,相关材料越充分,模型越有可能做对。
真正的问题是无关、过期和互相冲突的内容。
真正开始清理时,不需要记住一个专门术语。拿起任何一条长期存在的内容,问四个问题就够了:
- 它现在还是真的吗?
- 它是否与其他规则冲突?
- 一个能力合格的新同事是否本来就知道?
- 删除它,究竟会导致什么具体故障?
已经过期的规则可以删除。模型本来就知道的常识,通常也可以删除。
仍有价值、却只在少数任务里使用的内容,不该消失,而应该移到 Skill 或引用文件。
代码格式交给 formatter,质量底线交给测试,固定动作交给 Hook。
能够由工具确定执行的事情,不需要在多个说明文件里反复提醒。
优化上下文不是编辑比赛,而是重新决定每条信息应该住在哪里。
我会这样给 Claude Code 做一次体检
先看真实占用。
运行 `/context`,记录最大的几个类别。别因为某份文件看起来很长,就认定它一定是大头。
再列出常驻项。
全局规则、项目规则、已启用套件、Custom agents、MCP、记忆和连接器,都放进同一张审计清单。
然后重新安置。
每次任务都必须知道的项目陷阱留在根规则;专项流程放进 Skill;详细规范放进引用文件;能够机械验证的要求交给测试或 Hook。
最后,一次只改一个可回滚项。
暂停一个长期不用的插件,或拿掉一条疑似旧模型补丁。继续用真实任务观察错误、工具选择、重复解释和返工,再决定是否恢复。
如果条件允许,可以挑几个经常遇到的真实任务,固定输入、模型和验收标准。修改一个常驻项后重新执行,记录需要补充说明的次数、越界行为和人工返工,而不是只看 `/context` 少了多少。
删除量只是配置变化,任务结果才是优化效果。
我的记录只证明这些内容占据空间,没有做关闭 develop套件前后的同任务盲测。
所以,我不能声称删掉它就一定更快、更准或更省钱。
哪些东西不能删
“删掉 80%”很有传播力,但剩下的 20% 才决定系统能不能可靠工作。
安全、权限、数据访问、法律合规和发布确认必须明确。模型判断力变强,不等于它可以替用户决定风险。
项目里反直觉的设计、会导致事故的陷阱、可靠的构建和验证入口,也值得常驻。
同样的删减幅度不能照搬到所有模型。Anthropic 讨论的是最新一代 Claude 5。旧模型、小模型和本地模型可能仍需要更多脚手架。
插件、MCP、Agent 和 Skill 也不是越少越好。
一个经常使用、能稳定减少返工的工具,即使占一点常驻空间,也可能很划算。一个长期没有调用、描述却每次都出现的 Agent,才值得优先处理。
判断标准不是它占不占 token。
而是它带来的任务价值,是否配得上它的加载方式。
少不是目标,按需才是
这次 22% 的实测不是 Claude Code 的普遍基准,只是我这套重配置环境的一张快照。
但它改变了我优化上下文的顺序。
以前,我会先检查提示词和 `CLAUDE.md`。
现在,我会先问:
- 哪些能力在常驻?
- 哪些说明彼此冲突?
- 哪些内容只是旧模型留下的补丁?
- 哪些细节可以等任务需要时再加载?
如果你也装了不少插件、Agent、MCP 和 Skill,可以做一次最小审计:看一遍 `/context`,列出常驻项,删除一条明确冲突的规则,暂停一个长期闲置的能力,再把一份专项长流程移到按需层。
然后继续用真实任务观察一段时间。
上下文更短,不是目标。
让常驻信息具体、当前、彼此一致,让其他知识在需要时准确出现,才是上下文工程真正该追求的结果。
历史文章推荐
- 你写的 CLAUDE.md 越长,AI 越笨
- Claude Code 不是每次都失忆——它的自动记忆系统是怎么工作的
- Claude入门系列03|会提示词和会创建 Skill,是两回事
Hi,我是 爱学习的Niko。17 年程序员老兵,现在每天用 AI 写代码,搞创作。这里分享学习和使用 AI 的经验、技术思考、踩过的坑、实用工具和 SKILL。关注我,一起学习。