
Higgsfield + Codex/Claude MCP 全流程教程
一份从连接配置到案例实操的完整参考手册,覆盖8个真实案例、7大工具、30+模型、点数管理与避坑指南。

一、这是什么?
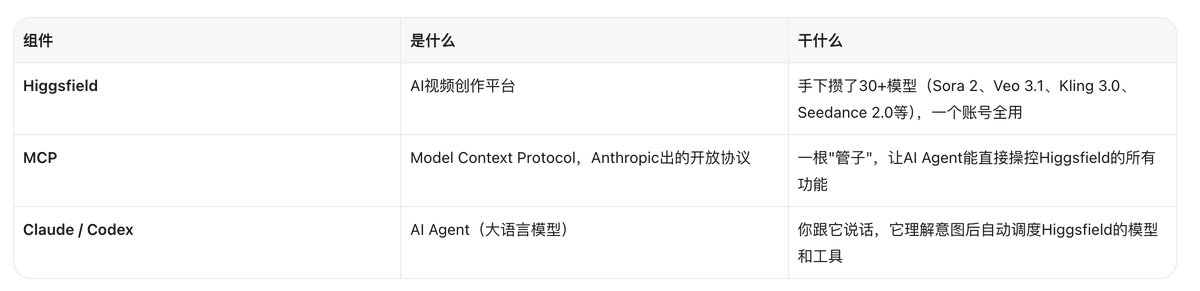
一句话版本: 你在 Claude 或 Codex 的聊天框里打一句话,AI 自动调用 30+ 视频模型,帮你从剧本到成片一条龙做完,甚至自动传 YouTube。
拆开来说:
以前做一条AI视频: ChatGPT写剧本 → Midjourney生角色图 → Runway/Kling生成视频片段 → ElevenLabs配音 → 剪映剪辑 → 每步手动搬运,5个工具,1整天。
现在: 一句话,Claude/Codex自动串完全流程,几分钟出片。
二、环境准备
2.1 你需要准备什么
项目
2.2 连接设置(3步搞定,约2分钟)
以下以 Claude 为例,Codex / Claude Code 流程基本一致。
第1步:复制 MCP 连接地址
去 Higgsfield 官网(higgsfield.ai),顶部导航栏找到「MCP」入口,复制连接地址:
如果用的是 Claude Code 或 Codex,官方建议用 CLI 方式连接,详见 higgsfield.ai/cli
第2步:在 Claude 中添加连接器
- 打开 Claude(桌面端或网页版 claude.ai)
- 进入 Settings → Connectors(设置 → 连接器)
- 点击右上角 Add → Add custom connector(添加自定义连接器)
- 名称填:Higgsfield
- URL 粘贴上面的地址
- 点击 Add
第3步:授权登录
- 点击 Connect
- 浏览器跳转到 Higgsfield 登录页,用你的 Higgsfield 账号登录
- 授权完成,连接器状态变为已连接
- (可选但推荐)在权限设置里把 Read 和 Write 都设为 Always Allow,这样后续生成不用每次手动确认
完成后,连接器会一直保持连接状态,这是一次性设置,以后不用重复操作。
2.3 验证连接
连接成功后,在 Claude 聊天框里发一句话验证:
你能用Higgsfield 做什么?列出所有可用工具。
Claude 会返回一份可用工具清单,包括图片生成、视频生成、角色训练、音频翻译等。同时你也可以让它查一下你的点数余额:
查一下我的Higgsfield点数余额。
如果工具没出现,断开连接器重新连一次,OAuth 会话过期是最常见的首次连接问题。
2.4 点数体系说明
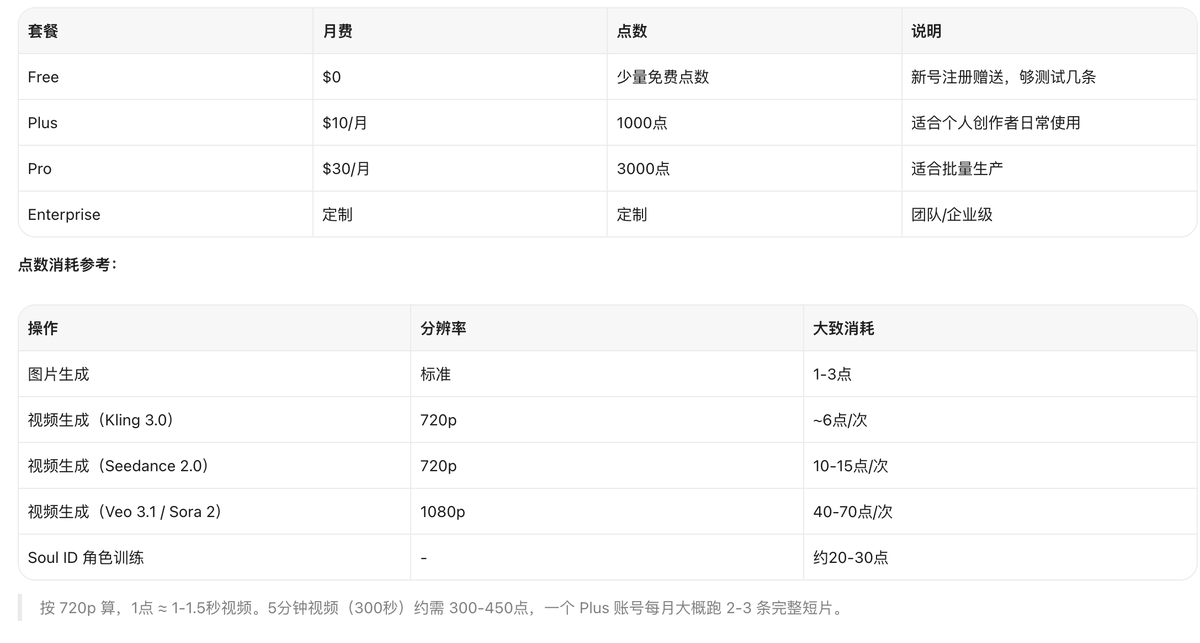
按 720p 算,1点 ≈ 1-1.5秒视频。5分钟视频(300秒)约需 300-450点,一个 Plus 账号每月大概跑 2-3 条完整短片。
三、基础教程:从0到1
3.1 生成第一张图片
最简单的入门操作,一句话生成一张图片:
用 Higgsfield 生成一张图片:纽约街头深夜,霓虹灯下一个人撑伞走过,电影感,16:9
Claude 会自动选择合适的图片模型(如 GPT Image 2 或 Nano Banana Pro),设置参数并生成。
要点:
- 描述尽量具体:场景、光线、构图、风格、比例
- 生成后如果不满意,直接跟 Claude 说"重新生成,改成xxx"
- 生成的图片会保存在你的 Higgsfield 工作区,后续可以直接引用
3.2 图片转视频(Image to Video)
核心技巧:先生成一张满意的图片作为"锚定帧",再用这张图作为视频的起始帧。
把刚才生成的那张纽约街头图片,用Seedance2.0做成5秒视频,慢速推镜头,电影感,1080p
为什么先图后视频?
- 直接文生视频,效果不可控,经常要重试,浪费点数
- 先生成图片,确认满意后再转视频,成功率高、成本低
- 被拒的视频要消耗完整点数,而图片只消耗1-3点
3.3 多镜头串联(Chain Shots)
做多镜头视频时,用"链式生成"保持画面连贯:
链式生成的好处:
- 画面连贯,不会有突兀的跳变
- 比每个镜头独立生成省点数(多镜头一次性生成比逐个生成更划算)
- Claude 会在同一个上下文里管理所有镜头的状态
3.4 角色一致性(Soul ID)
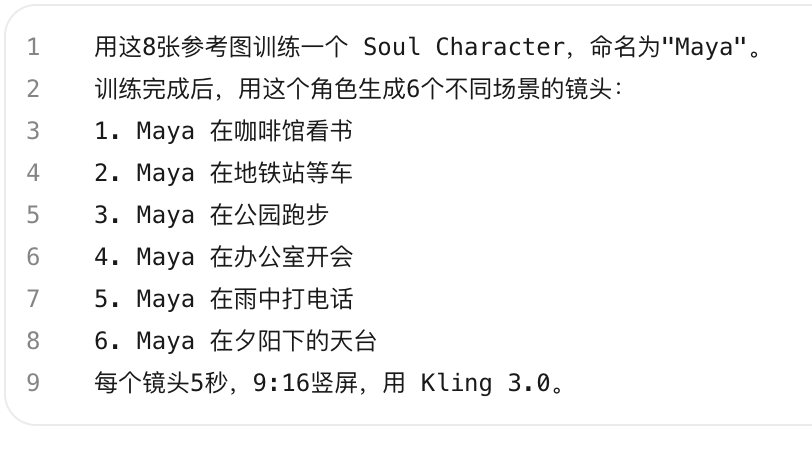
如果你要在多个镜头甚至多集内容里保持同一个角色的脸不变,用 Soul ID:

Soul ID 要点:
- 参考图最好提供多角度(正面、侧面、全身、特写)
- 灰色背景的参考图效果最好,去掉杂乱背景让模型聚焦人物
- 训练完成后,角色身份会保存在你的工作区,后续随时可调用
- 跨场景、跨集使用都没问题,脸不会跑
四、进阶工作流
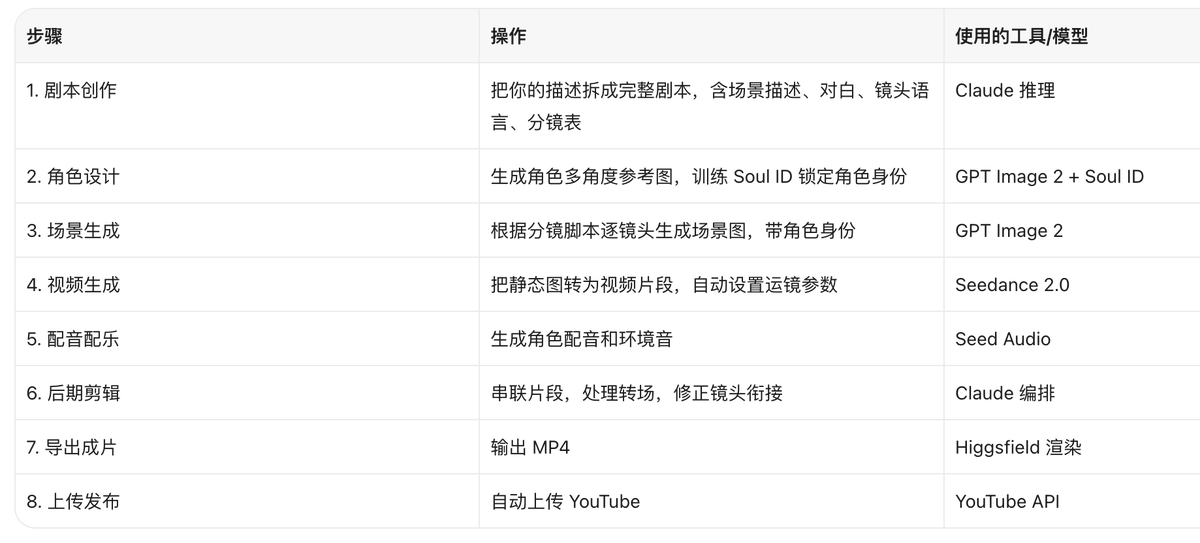
4.1 完整短剧制作8步流程
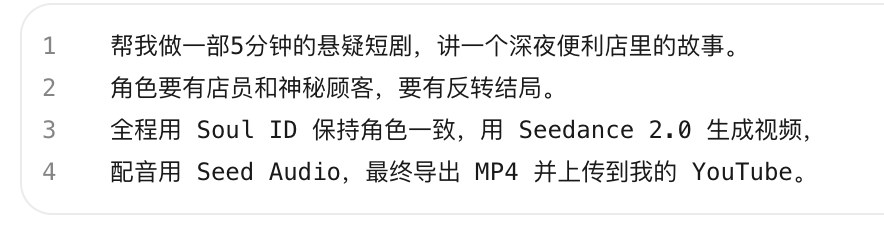
这是目前最炸裂的工作流,一条指令完成从剧本到YouTube上传的全链路:

Claude/Codex 会自动执行以下8步(流程图见上方可视化):
4.2 批量生成与并行处理4.3 YouTube频道自动化(Faceless无脸频道工作流)
用 Claude 的子代理(sub-agents)功能并行生成多个镜头:

Claude 会自动启动多个子代理并行处理,比逐个生成快数倍。
4.3 YouTube频道自动化(Faceless频道)
适合不露脸、纯靠内容和画面做起来的频道:

然后追一句话批量扩展:

Claude 会自动选题、研究、生成、包装,循环生产。
4.4 电商产品广告(3步工作流)
Higgsfield 官方教程的 4K 产品广告工作流:
4.5 UGC内容工厂
用 UGC 预设批量生成"真人推荐"风格的短视频:
Claude 会自动选择 UGC 预设,生成脚本 → 创作者表演画面 → 产品特写 → 字幕 → 成品。
五、8大真实案例详解
案例1:一句话生成篮球场电影感视频
难度: ★☆☆☆☆ 入门级
指令:
发生了什么:
- Claude 先自己写了一个比原话详细得多的图片提示词,包含破损沥青、褪色罚球线、铁丝网、纽约褐石建筑、涂鸦墙、金色光线、浅景深等细节
- 调 GPT Image 2 生成了一张高质量照片
- 拿了这张图的 job ID,直接作为起始帧传给 Kling 3.0
- 生成了3秒慢速电影感推镜头
要点: 两个工具调用,一条指令,零手动操作。以前你得先生图、下载、再上传到视频工具、重写提示词。现在中间的搬运彻底没了。
点数消耗: 约 8-10 点(图片2点 + 视频6点)
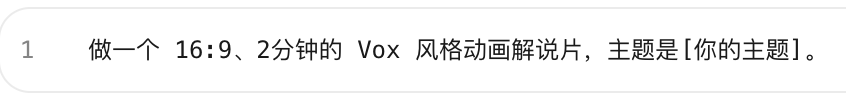
案例2:Vox风格2分钟动画解说片
难度: ★★☆☆☆ 中等级
指令:
发生了什么:
- Claude 自动研究主题相关资料
- 把内容结构化成不同段落,对齐视觉节点和旁白节奏
- 生成动态画面(信息可视化动效)
- 生成配音(可选 Brian、Naomi、Hugo 等声音)
- 旁白对应到选定语音,音轨纳入影片组装
- 组装成完整成片
要点: 提示词是触发器,不是逐镜头脚本。你不用为每个镜头单独写指令,Claude 自己规划分镜。
适用场景: YouTube Shorts、Instagram Reels、TikTok 短中视频。Vox风格辨识度高、节奏快、信息密度恰到好处。
点数消耗: 约 80-120 点
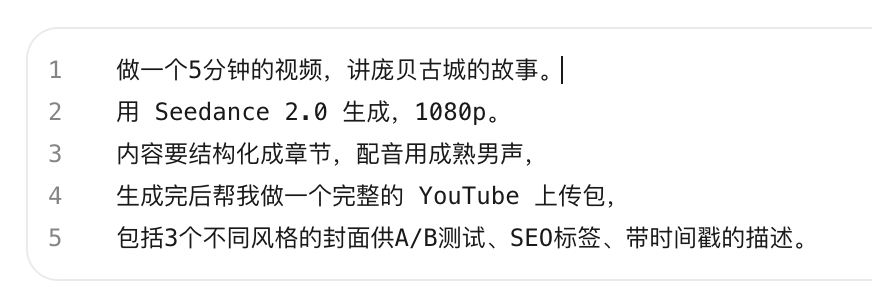
案例3:faceless YouTube频道(月入$39,500案例)
难度: ★★★☆☆ 高级
指令:
发生了什么:
- Claude 研究庞贝古城历史资料,内容结构化成9个章节,每章对应一段时间轴
- 生成全部分镜画面,角色和场景全程一致
- 配音自动生成并同步到时间轴,背景音乐配好
- 用户追加指令:帮我做完整 YouTube 上传包
- Claude 生成了3个不同风格的封面供 A/B 测试、SEO标签、带时间戳的描述
- 用户追加指令:Make me 2 more videos,选题你自己找
- Claude 自己选了两个选题,又跑了两条出来
要点: 最后那个"再帮我做两条"才是最要命的。它不是一次性生成,是可以像工厂一样持续运转。你给方向,它自己选题、生产、包装。
诚实提醒: $39,500 月收入是头部频道的数据,不代表你接上 MCP 就能复制。工具能帮你生产内容,但内容能不能赚钱是另一码事。能赚钱的永远是少数。
点数消耗: 单条约 300-450 点,3条约 900-1350 点(一个 Plus 账号勉强够一条)
案例4:5分钟AI短剧全自动生成 + 传YouTube
难度: ★★★☆☆ 高级
指令:
发生了什么: 见第四章 4.1 的8步流程,全自动执行。
关键细节:
- 剧本不是干巴巴大纲,有场景描述、对白、镜头语言
- 角色用 Soul ID 锁脸,全程不跑偏
- 运镜参数自动判断(急推、推轨、360环绕)
- 从剧本到YouTube一条龙
当前限制:
- 不是按一下回车就去喝咖啡,中间有等待生成时间
- 有需要人工确认的节点
- 5分钟成片实际可能需要 30-60 分钟跑完
- 点数消耗较大,建议 Pro 套餐
点数消耗: 约 400-600 点
案例5:4K产品广告3步工作流(耳机广告)
难度: ★★★★☆ 专业级
来源: Higgsfield 官方教程(2026年6月22日发布)
3步流程:
第1步:素材准备
- 用 GPT Image 2 生成耳机产品多角度图(正面、侧面、俯视、佩戴效果)
- 生成主角角色参考图(特写 + 全身,灰色背景)
- 生成场景参考图(录音棚、街头、办公室)
- 生成道具和服装参考
第2步:分镜脚本
- 用 Claude + 自定义 Skill 把广告脚本转成命名的 Seedance 提示词
- 每个镜头有独立提示词,共享风格前缀和命名元素
- 形成一个连贯的分镜文档
第3步:生成与迭代
- 逐场景用 Seedance 2.0 4K 生成
- 诊断失败镜头,改写提示词重新生成
- 从多次生成中挑选最佳片段
- 后期剪辑组装成最终广告
核心洞察: 最好的AI广告不是随机生成,而是系统。秘密不是每次生成都成功,而是工作流产出足够多的可控尝试,让剪辑师能找到最 keeper 的那几秒。
点数消耗: 约 500-800 点
案例6:50岁零基础批量生产AI漫画短视频
难度: ★★☆☆☆ 实用级
来源: 日本一位50多岁的创作者,自述"零艺术天赋、零剪辑技能"
工作流:
- 在 Claude 里设定一个"图片生成 Skill"(固定画风模板)
- 丢入剧本,Claude 自动生成每个场景的漫画分格图
- 用 Higgsfield 的图生视频功能,每张图转5秒慢速推镜头
- 用子代理并行处理所有场景(一次5个场景同时生成)
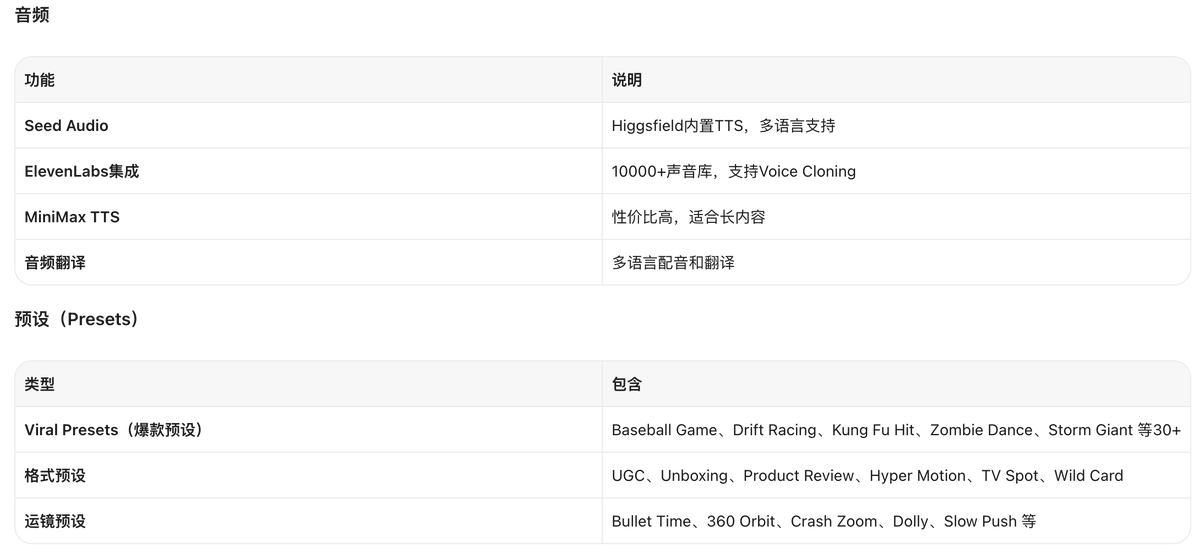
- 用 Higgsfield 内置 TTS 生成日语配音(可选 ElevenLabs 或 MiniMax 引擎)
- 用 Canva 或 Vrew 快速剪辑加字幕
他原话的精华:
"自从切换到这种思维方式,我能同时运营多个账号。一个50多岁、没有艺术天赋、没有剪辑技能的人也能做到这一步。这意味着,没有技能已经不再是借口了。"
要点: 关键不在于"打磨自己的技能",而在于"建立系统并自动化"。与其去上视频剪辑培训班,不如让 AI 来做视频。
点数消耗: 单条约 50-80 点(漫画风格比写实便宜)
案例7:YouTube长视频B-roll自动化
难度: ★★★☆☆ 效率级
来源: 一位 YouTube 创作者的实际工作流
痛点: 30分钟 talking-head 视频,B-roll 搜索和放置要花 3-5 小时,比剪辑本身还耗时。
核心洞察: 秘密不是更好的AI图片生成,而是时间戳。音频有了带时间戳的转录文本后,文件名就是放置地图。一张命名为 00:01:34.png 的图片,不只是描述一个时刻,它直接告诉编辑器在时间轴的哪个位置放这个文件。
工作流:
- 用 TurboScribe 把录制好的音频转录成带时间戳的文本
- Claude Code 读取转录文本,分析每个时间点需要什么画面
- 通过 Higgsfield Skill 自动生成每张 B-roll 图片
- 文件名用时间戳命名(如 00:01:34.png)
- 把整个文件夹拖进 CapCut,文件按时间戳自动排序 = 时间轴顺序
- 自动放置完成,不用手动拖
效果: 30分钟视频的 B-roll 从 3-5 小时压缩到约 30 分钟。
点数消耗: 30分钟视频约 60 张图,约 120-180 点
案例8:Higgsfield Original Series 原创AI剧集
难度: ★★★★★ 顶级(目前由 Higgsfield 官方团队制作)
已播出剧集:
意义: demo 和产品之间有条线。5分钟短剧demo可以说是技术展示,但完整剧集在自家平台播出还有多部,这就不是 demo 了,是正儿八经在做内容。
给普通创作者的启示: 这是方向标。官方做的,代表他们认为这条路线已经可以产出可消费的内容了。个人创作者现在可能还到不了这个水准,但半年后呢?
六、7大工具功能详解
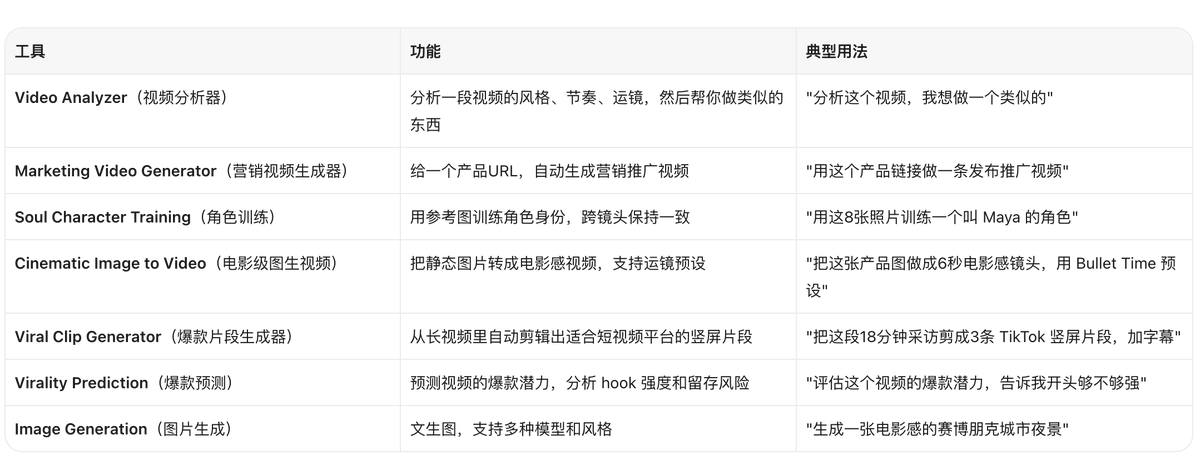
Higgsfield MCP 给你的 AI Agent 提供了7个可调用的工具:
连接成功后,可以直接问 Claude:"你能用 Higgsfield 做什么?"它会列出当前可用的所有工具和功能。
七、可用模型清单
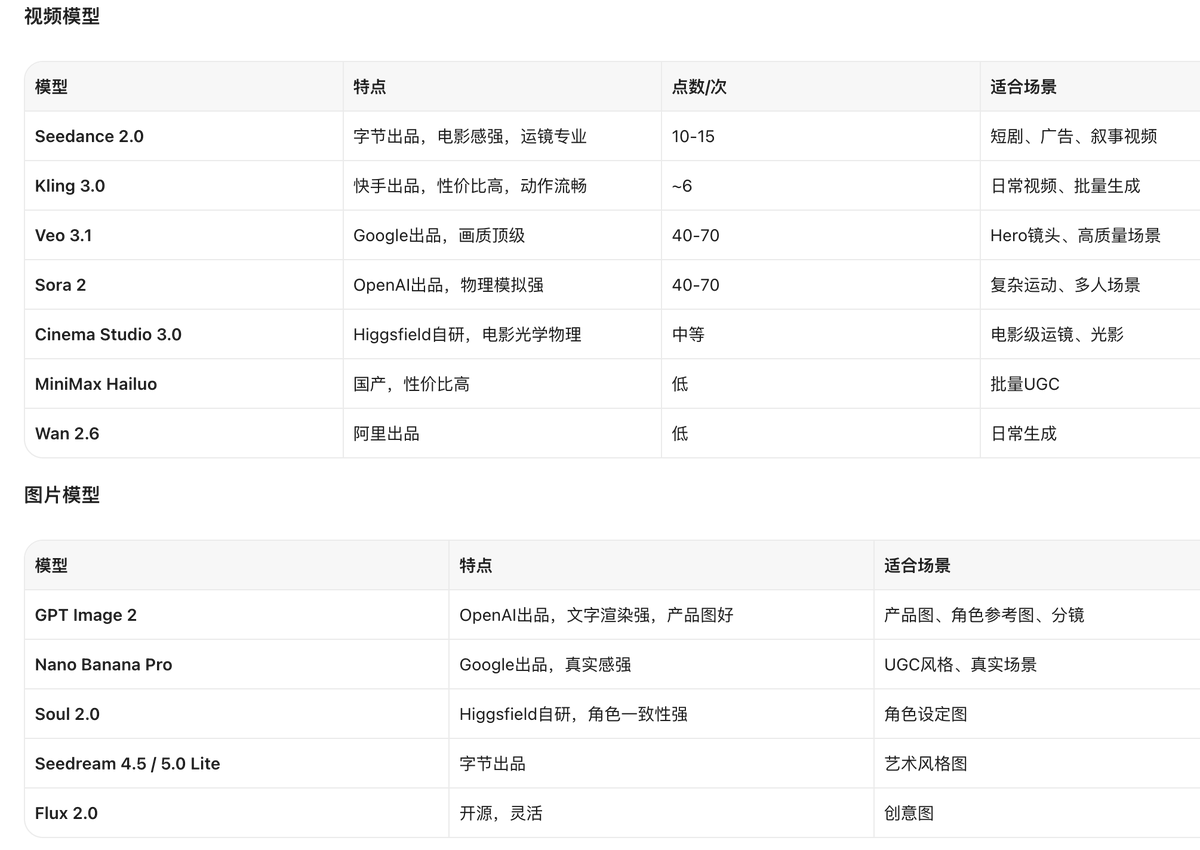
Higgsfield 一个账号覆盖 30+ 模型,以下是主要模型:

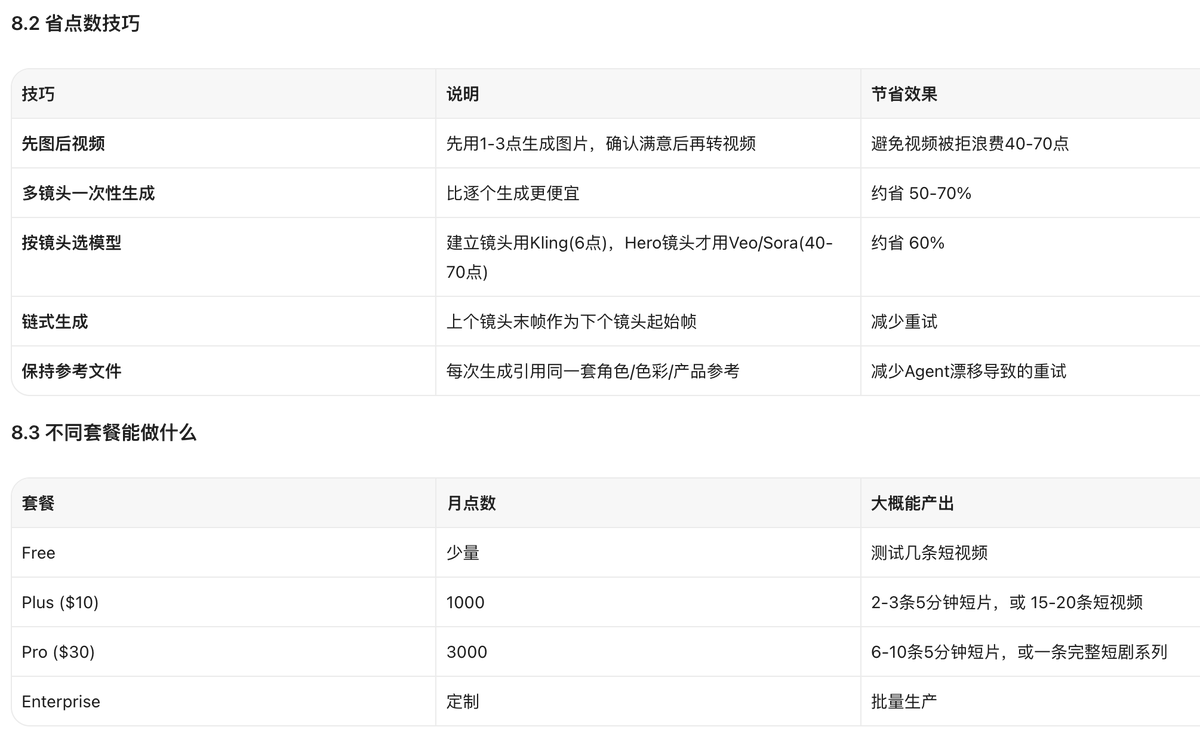
八、点数成本管理
8.1 核心原则
按交付物追踪点数,不按调用次数追踪。
一个15秒的广告片,用"锚定帧 + 链式多镜头"的方式,可以控制在 200-300 点以内。如果你不管理点数,逐个镜头独立生成,可能花掉 2-3 倍。
九、常见坑与最佳实践
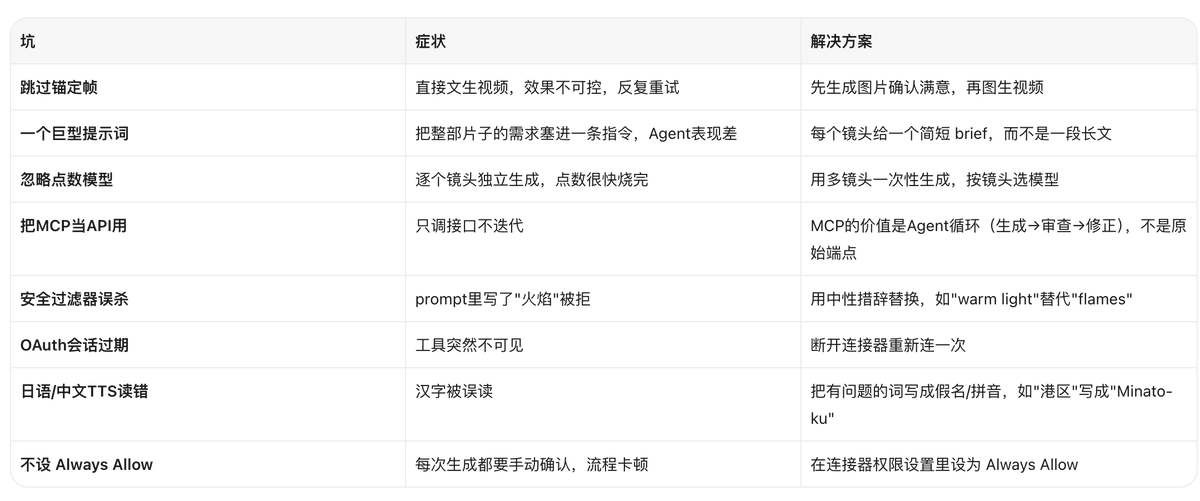
9.1 常见坑

9.2 最佳实践
1. 保持项目级参考文件
每次生成都引用同一套参考:角色设定、色彩方案、产品标识。Agent没有这个会漂移。
2. 像真实制片一样思考
最好的AI广告/视频不是随机生成的,而是系统。分离成可重复的步骤:准备素材 → 测试参考 → 生成分镜 → 逐场景迭代 → 剪辑最佳片段。
3. 按镜头选模型,不按项目选模型
10秒的建立镜头和紧凑的角色特写有不同的成本/质量权衡。Kling 3.0 跑约6点,Veo/Sora 要40-70点。不是所有镜头都需要最贵的模型。
4. 生成足够多的可控尝试
不是每次生成都成功。工作流的价值在于产出足够多的可控尝试,让你从中挑出最佳的几秒。
5. 描述运动,不描述场景
做图生视频时,场景已经锁定在锚定帧里了。你应该描述的是运动方式(推、拉、摇、移),不是重新描述场景。