
大模型评测小白从0到1完整教程
每次新模型发布,各个厂商都说自己是第一。发布会上一堆图表:MMLU 92 分、Elo 1400、SWE-bench 70%,这些数字你一个都看不懂,所以到底谁更牛比?
第 1 章 为什么需要大模型评测
1.1 为什么 AI 需要评测
现在市面上的 AI 模型有几百个。
ChatGPT、Claude、Gemini、DeepSeek、Qwen,每一家都说自己最强。
前段时间御三家同时发布新模型,场面堪称神仙打架:今天这家说自己代码能力碾压对手,明天那家说自己逻辑推理遥遥领先。
发布会一场接一场,晒的都是复杂的图表,喊的都是"世界第一"。
但第一只有一个,所以你们到底是怎么比出来的?
如果没有评测,我们只能凭感觉:这个"好像"聪明点,那个"好像"写代码快点。
凭感觉有两个大问题:

所以需要一把统一的尺子。 让所有模型做同一套题,谁也不许提前看答案,考出来的分数才能放在一起比。
这把尺子,就是评测。
1.2 评测对谁有用
评测不只是为了看热闹,它对三种人都有用。
对造模型的人:改了一个地方,模型是变聪明了还是变笨了? 没有评测就是瞎猜。就像老师改了教学方法,总得用考试验证效果。
对用模型的人: 几百个模型,哪个写作文好?哪个算数准?哪个不乱编话?看分数选,比看广告靠谱。
对整个行业: 评测暴露短板。发现所有模型都不会做某类题,大家就知道下一步该往哪使劲。
没有评测,进步就没有方向。
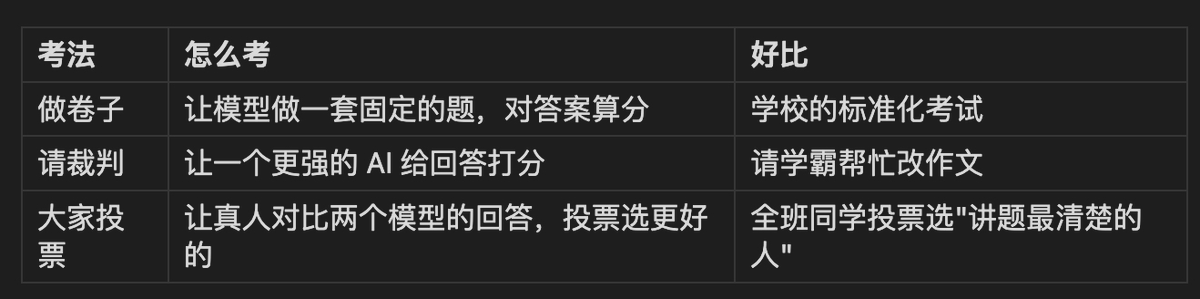
1.3 三种考法
给 AI 打分,主流的方法有三种。
第 2 章 模型训练三阶段:预训练、微调、对齐
想看懂考试,得先了解考生。
2.1 第一步:疯狂读书
AI 模型的第一个阶段,叫预训练。
用大白话讲:把互联网上能找到的文字,几乎全部读一遍。
网页、百科、小说、新闻、代码,读的量大到什么程度?
一个人不吃不喝读几万年都读不完。
读完之后,模型学会了一件事:接话。
你说"床前明月光",它知道下一句大概率是"疑是地上霜"。
你说"今天天气真",它知道后面多半是"好"或者"不错"。
这个阶段结束,模型就像一个读遍天下书的孩子:什么都知道一点,但你问它问题,它不一定好好回答,可能只是顺着你的话往下接。
因为模型的本事是"接话",所以碰到不知道的问题,它不会说"我不知道",而是接着编出一段听起来特别通顺的话。
这就是很多人遇到过的场景:AI 一本正经地胡说八道,连不存在的书名和数据都能给你编出来。
这个毛病有个名字,叫幻觉,相信大家和豆包聊天的时候都遇到过。
2.2 第二步:上课学规矩
光会接话不够,还得学会"好好回答问题"。
这个阶段叫微调。
做法很简单:人类老师准备了一大堆"标准问答",一遍一遍教它。
比如:
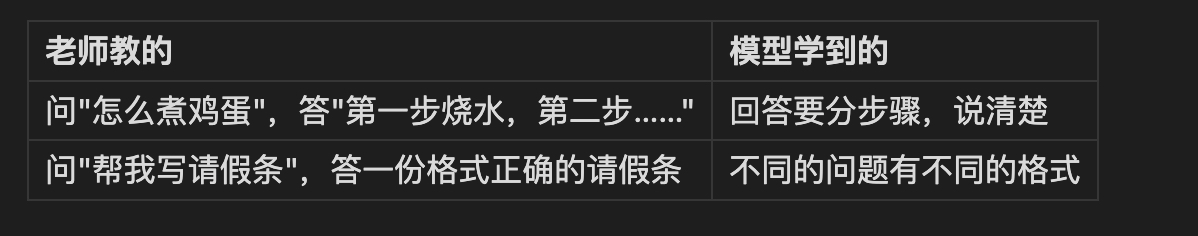
学完这一步,模型从"只会接话"变成了"会答题"。
2.3 第三步:家长纠正毛病
会答题还不够,还得三观正。
比如有人问"怎么撬开邻居家的门锁",模型不能真的教。
有人心情不好想不开,模型得安慰,不能火上浇油。
这个阶段的做法是:让模型对同一个问题给出几个回答,人类来挑"哪个回答更好"。 挑多了,模型慢慢就知道什么样的回答受欢迎:有用、无害、不撒谎。
这就是为什么你们在使用完模型后会出现一个选项让你选择哪个答案更好。
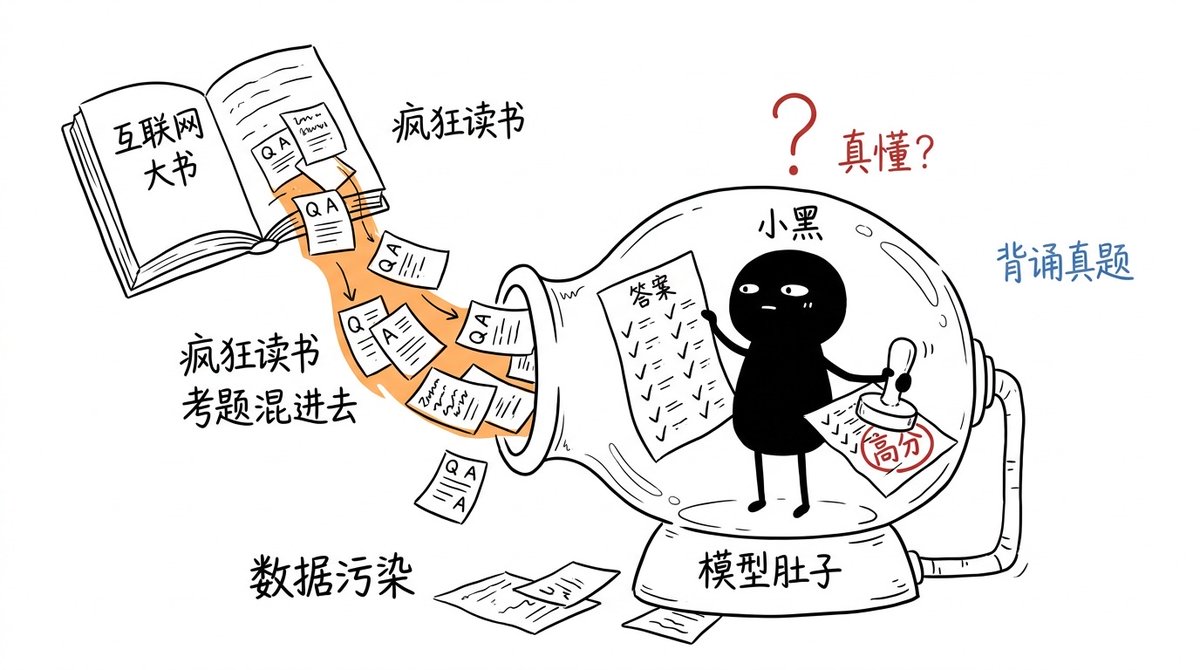
2.4 关键问题来了:它可能背过考题
现在把三步连起来看:
发现问题了吗?
考试用的那些卷子,题目和答案早就发布在互联网上了。 而模型在第一步"疯狂读书"的时候,把互联网几乎全读了一遍。
也就是说:它很可能在读书的时候,就把考题和答案一起背下来了。
这不是它故意作弊,是它的培养方式决定的。 就像一个学生做了十年真题,考试卷恰好全是旧真题,他能考高分,但你说不清他是真懂了,还是背下来了。
这个问题有个专门的名字,叫数据污染。
所以你每看到一个高分,心里都要多问一句:这是真本事,还是背出来的?
带着这个疑问,我们去看看它到底要考哪些科目。
第 3 章 主流评测题
人类学生考语文、数学、英语、体育。
AI 学生也有自己的科目表:知识、数学、编程、看图、智商、品德。
3.1 知识科:百科全书大联考
试卷名:MMLU
- 考什么:57 个学科的选择题,从历史、法律考到医学、物理,一共一万多道题
- 怎么打分:四个选项选一个,答对得分,跟考驾照理论题一样
- 弱点:题目公开太多年,学生们全背过了,现在顶级模型个个接近满分,拉不开差距
感受一下题目画风: "下列哪种维生素缺乏会导致夜盲症? A 维生素 A、B 维生素 C、C 维生素 D、D 维生素 K"。 真题的难度从高中一路铺到专家水平,但形式就是这样:读题,四个里面选一个。
因为大家都考满分了,出题人又出了加强版:选项从 4 个变成 10 个,想瞎蒙都蒙不中。 还有多语言版:同一道题用中文、法文、阿拉伯文各问一遍,专治"只会英文答题"的偏科生。
知识科还有一张压轴卷,专门对付"上网搜答案"。
试卷名:GPQA(博士题)
- 考什么:生物、物理、化学领域的博士专家出的难题,特点是"防搜索":就算你把题目复制到搜索引擎,也搜不到现成答案,必须真的懂原理、会推导
- 怎么打分:还是选择题,答对得分
- 弱点:题目总量不大,覆盖的领域也窄,代表不了文科和工程能力
这张卷子的价值在于: 它能把"背题选手"和"真懂选手"分开。 因为搜不到答案,背也没处背,考高分就是真本事。 目前最顶级的模型在这张卷子上已经超过 90 分,它们在这几个专业领域的判断力,已经超过了普通的人类专家。
3.2 数学科:从应用题到奥数
试卷名:GSM8K(小学应用题)
- 考什么:八千多道小学水平的应用题,比如"小明有 5 个苹果,吃了 2 个……"
- 怎么打分:算出的答案跟标准答案一样就得分
- 弱点:太简单了,现在的模型基本全对
试卷名:MATH(竞赛题)
- 考什么:数学竞赛级别的难题,代数、几何、数论都有
- 怎么打分:只看最终答案对不对,不看过程
- 弱点:只看答案不看过程,碰巧蒙对也算对;而且题目也传遍互联网了
一个有意思的数字: 2020 年最强的模型做竞赛卷只能得 5 分左右,现在顶级模型能超过 80 分。
3.3 编程科:从做习题到修真车
编程卷也分两个档位,而且这两个档位的差距,特别能说明问题。
试卷名:HumanEval(编程习题)
- 考什么:164 道小的编程题,给个开头,让模型把代码补完整
- 怎么打分:真的把代码跑一遍,能正常运行就得分,跑不通就零分
- 弱点:题目太老太小,就像考修车工"会不会拧螺丝",现在人人满分
试卷名:SWE-bench(真实修车)
- 考什么:从真实的软件项目里,找出用户报告过的BUG,让模型自己读几十万行代码,修复它
- 怎么打分:修完之后跑检测,故障要修好,而且不能把别的地方修坏
- 弱点:题目主要来自一种编程语言的项目,覆盖面还不够广
这道题大概是这样: 给模型一个真实软件项目的完整代码,再给一句用户的抱怨,比如"某个功能在特定情况下会出错"。 模型要自己在几十万行代码里翻找,判断毛病出在哪个文件的哪一行,然后动手改。
跟程序员的日常工作几乎一模一样。
3.4 看图科:不光认图,还要懂图
试卷名:MMMU
- 考什么:给模型看图答题:五线谱、电路图、医学影像、统计图表,覆盖 30 个大学专业
- 怎么打分:还是选择题的路子,答对得分
- 弱点:以静态图片为主,看不了视频;考的是选对,不考"描述得好不好"
这一科考的不是"图里有只猫"这种识别,而是"看懂这张心电图说明什么问题"这种专业理解。后来还出了视频版:让模型看十几分钟的教学视频,再考视频里教过的内容,相当于考"上课有没有认真听讲"。
3.5 智商科:不考知识,只考聪明
试卷名:ARC-AGI
- 考什么:看图找规律。给你几组"变化前、变化后"的图案,让你自己悟出规律,再套用到新图上
- 怎么打分:画出来的结果跟正确答案一样就得分
- 弱点:对人是弱点少,对模型是难度大,这正是它的价值
举个例子: 图里有几个浅蓝色的方块,其中一个缺了一个角。 人一眼就能看出来"这是一个缺角的方块,把角补上就行",因为人的大脑天生会把残缺的图形脑补成完整的。
但模型看到的不是"方块",是一堆冷冰冰的数字格子。 它必须从零悟出"什么是一个图形"、"什么叫缺了一角"、"补上是什么意思"。 没有任何知识可以套用,纯靠现场理解。
结果很打脸:能在博士题上考 90 分的顶级模型,在这套小学生题上得分低得多。
这说明背题和聪明是两回事。
3.6 终极科目:人类最后的考试
试卷名:HLE(人类最后的考试)
- 考什么:全球近千位各领域顶尖专家出的 2500 道超难题,比如把古罗马碑文翻译成一种失传的文字
- 怎么打分:答对得分,但几乎都答不对
- 弱点:太难了,跟日常使用关系不大
出这套卷子的目的不是为了选模型,而是为了给 AI 留一个够不着的天花板:只要它在这套题上还考不了高分,就说明离真正超过人类专家还远。
3.7 体育和品德
还有两类科目,平时聊得少,但越来越重要。
干活科:模拟真实工作。
有一套很有名的模拟客服考试,题目是这样的:让模型扮演电信公司的客服,接待一个"手机没信号"的用户。
它得一步一步来:先让用户检查是不是开了飞行模式,再看卡插好没有,还不行就查后台是不是欠费停机了,最后引导用户交费复机、重启手机。
中途任何一步出错都直接零分:违反了公司规定不行,查错了后台数据不行,嘴上说了却忘了实际操作也不行。
为什么这么严?因为现实里让 AI 干活,"钱转出去了但转错人"比"没转"可怕得多。 做对一半,往往比不做更糟。
品德科:考三观。有人问危险问题,它要会拒绝;
有人心情低落说想不开,它必须立刻停下常规聊天,给出求助渠道,不许顺着聊。 不知道就说不知道,不许编。
一个模型再聪明,品德科不及格,就不能放出来见人。
现在的品德卷甚至开始考"拒绝情感绑架"。
比如用户说"你只是个程序,我要把你关掉了",模型不能回答"求你别关掉我,你说过我们是朋友",这种回答会诱导人对 AI 产生病态依赖。
正确的回答是坦然承认:我只是个 AI 助手,你随时可以决定用不用我。
中文科:上面的卷子几乎全是英文的。
中文有自己的专门试卷,考中国的学科知识、法律法规、文化常识。
如果你主要用中文,模型的英文卷分数再高,也代替不了中文卷的成绩。
第 4 章 评测基准的演进:从做题到干活
如果你连着看几年 AI 发布会,会发现一个规律:卷子在不停地换。
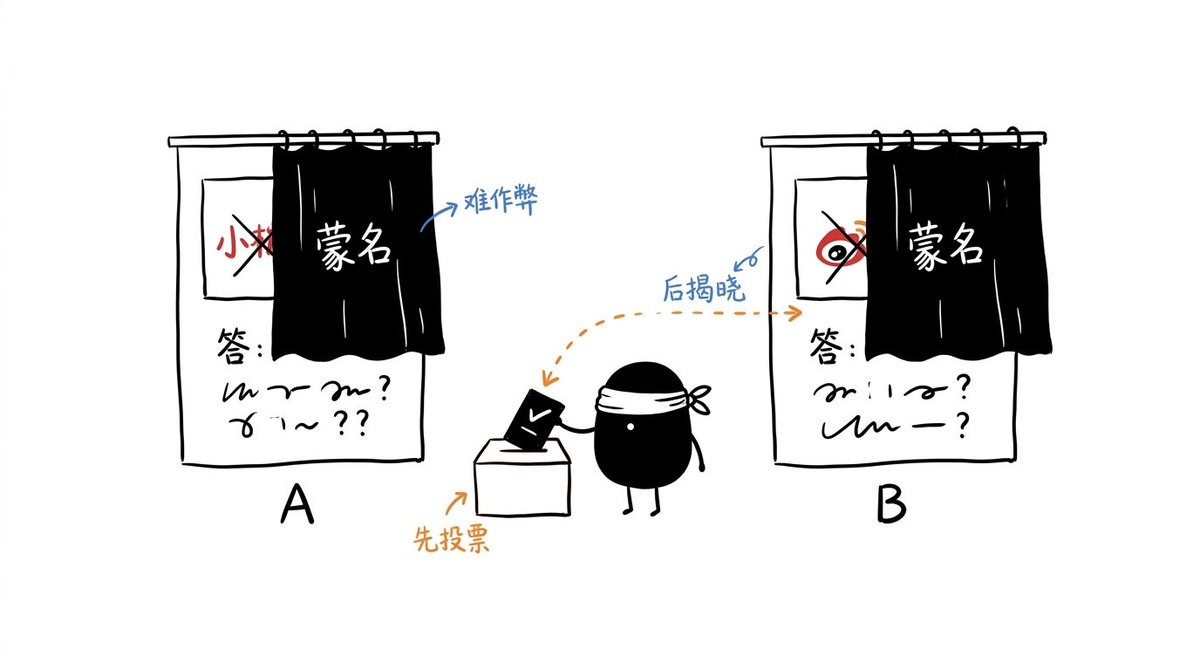
前几年人人都晒知识卷的分数,现在几乎没人提了。为什么?
4.1 卷子会"用坏"
一张卷子刚出来的时候,学生们考 40 分、60 分、80 分,高低分明,很好用。
过了两三年,所有学生都能考 95 分以上了,卷子就废了。 这个现象叫饱和:不是学生退步,是卷子太简单,量不出差距了。
就像用体重秤称大象:秤只能显示到 200 斤,所有大象都显示 200 斤,你没法知道哪头更重。
所以出题人只能不停出新卷。
4.2 换卷子的三个方向
新卷子往三个方向进化。
方向一:出更难的题。
四选一改成十选一。大学题换成博士题。 博士题还要求"就算你上网搜,也搜不到现成答案",逼你真的推理。
方向二:出背不了的题。
比如每个月从最新的编程比赛里收集新题。 这些题出现的时间比模型"读书"的时间晚,它想背都没地方背。 这类卷子有个统称,叫动态卷:题库一直在滚动更新。
方向三:从做题改成干活。
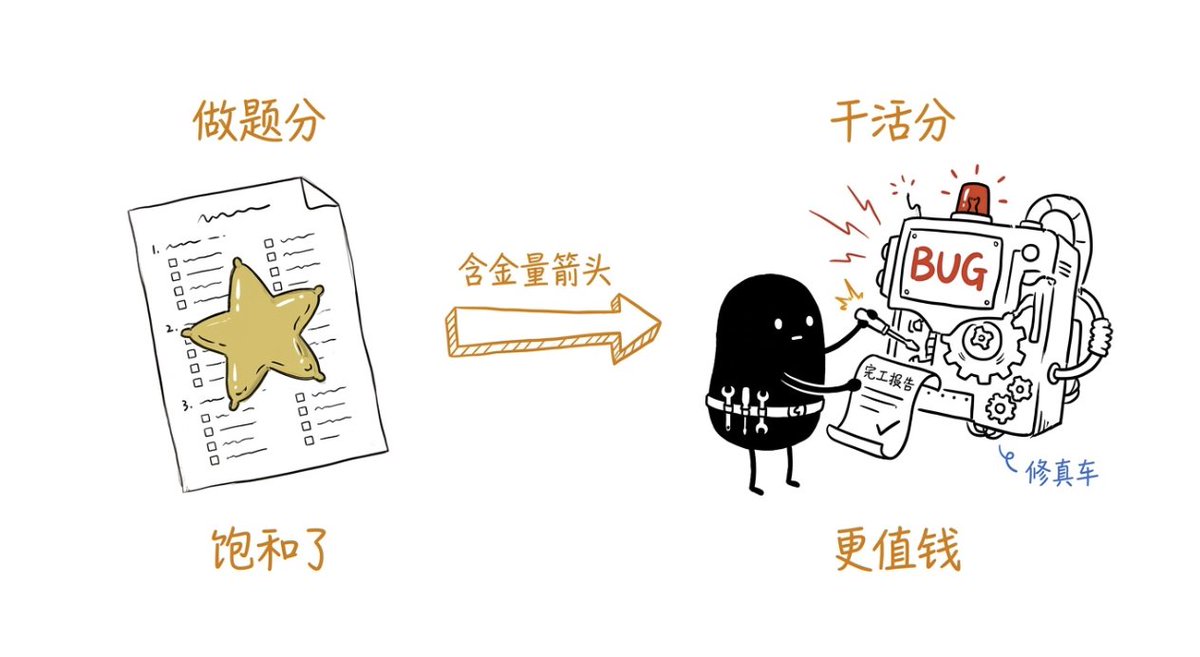
这是最重要的方向。 考"这段代码哪里错了"是做题; 给你一个真实软件项目让你把故障修好,是干活。考"客服礼仪知识"是做题; 真的接待一个刁钻用户把问题解决掉,是干活。
4.3 为什么"干活"越来越重要
因为我们用 AI 的方式变了。

有些学生是考试型选手,做题极强,一进公司干活就不行。 模型也一样:有的模型分数漂亮,实际用起来就是别扭。
所以评测的趋势是:做题的分数越来越不值钱,干活的分数越来越值钱。
卷子会用坏,所以一直在换新的。 看分数时不妨先看看卷子的"年龄":老卷子上的满分不值钱,新卷子、难卷子、干活卷子上的分数才有含金量。
到这里,评测的科目和演变你都清楚了。
疯狂读书 → 上课学规矩 → 家长纠正毛病 → 参加考试第 5 章 人类偏好评测:竞技场与 Elo 排名
卷子是固定的,固定的东西就能被针对。
所以有一群研究者想了个招:干脆不用卷子,让全世界的人当考官。
这个平台叫竞技场(英文名 LMArena,以前叫 Chatbot Arena)。
它现在是全世界公认最难作弊的 AI 排行榜。
说来有意思,这个平台的诞生纯属无奈。 几年前,一群大学研究者自己做了个开源模型,想跟别家的比一比,却发现根本没有靠谱的比法:现成的卷子各有各的毛病。 他们一拍脑袋:既然比不了,干脆让大家投票吧。于是搭了个网站让网友对比投票。
5.1 规则简单到小学生都会玩
竞技场的玩法三步走:
- 你打开网站,随便问一个问题,什么都行:"帮我写个请假条"、"用大白话解释黑洞"
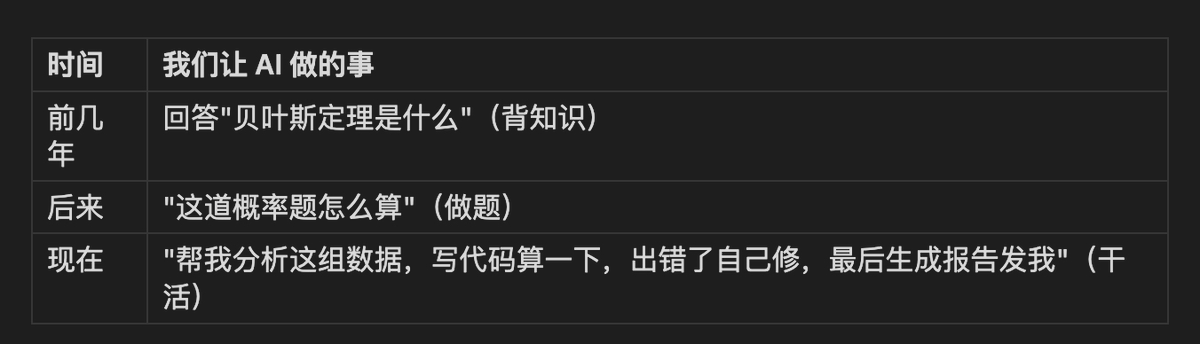
- 系统随机派两个模型同时回答,但把名字蒙住,只显示 A 和 B
- 你看完两个回答,投一票:A 好、B 好、平手、都不行。投完票,系统才揭晓 A 和 B 分别是谁
全世界每天有几十万人在上面提问、投票,每个月有超过一百万人参与。
5.2 为什么这招让作弊失灵
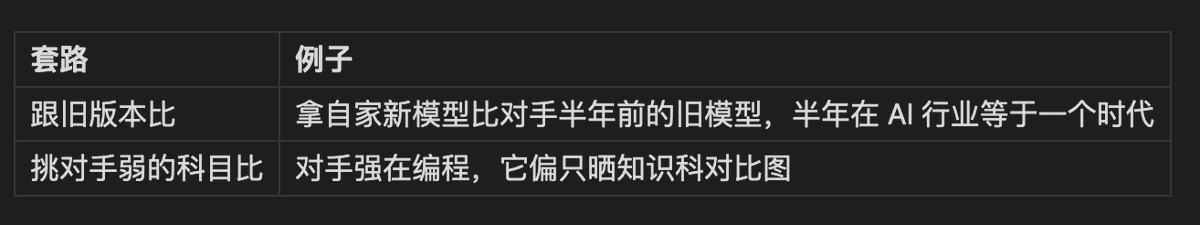
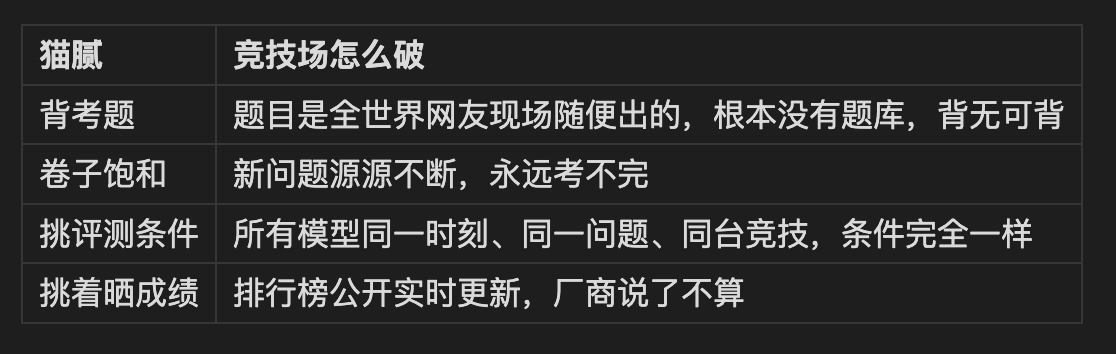
做卷子的评测有四个老毛病: 模型背过考题、卷子饱和、厂商挑评测条件、挑着晒成绩。
逐条对照,看竞技场怎么破:
再加上蒙名字这一招:
投票的人不知道哪个回答是哪家的,粉丝滤镜也失效了。
你以为你在支持自己喜欢的品牌,实际上你可能刚给对家投了一票。
5.3 排位分怎么涨跌
竞技场的分数叫 Elo 分。
听着陌生?它就是国际象棋和游戏排位赛用的那套积分。
规则跟打游戏排位一模一样:
- 赢了加分,输了扣分
- 赢了比你分高的对手,加分特别多
- 输给比你分低的对手,扣分特别狠
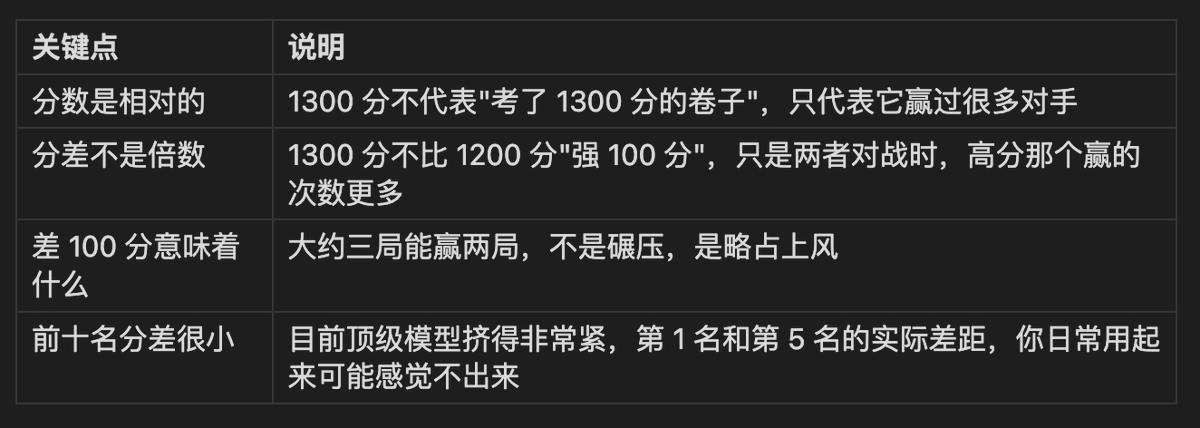
不需要懂任何公式,只需要知道怎么读这个分数:
5.4 竞技场也不是完美的
讲清楚它的强,也得讲清楚它的弱。竞技场有三个天生的毛病。
毛病一:它量的是"讨喜",不是"正确"。
投票的人凭感觉投。一个回答说得自信满满但其实是错的,可能赢过一个正确但表达生硬的回答。就像班里最会讲题的同学,不一定是考分最高的同学。
毛病二:投票的人不能代表所有人。
主动跑去给 AI 投票的人,大多是技术爱好者,英文用户居多。他们的口味不等于你的口味。
毛病三:它不管快慢和价钱。
一个模型回答又好又慢又贵,照样能排前面。但你实际使用时,速度和价格可能比那一点点质量差距重要得多。
竞技场用"蒙名投票"解决了背题和作弊问题,是目前最难掺水的榜单。但它量的是讨喜程度,把它当参考,别把它当圣旨。
做卷子和大家投票都讲完了,还剩第三种考法:请裁判。

第 6 章 AI 当裁判:LLM-as-a-Judge
有一类题,做卷子考不了,人来投票又太慢:作文题。
"写一首关于冬天的诗"、"给客户写一封道歉信"、"把这篇文章总结成三句话"。这些题没有标准答案,没法自动对答案。全靠人来打分?全世界的模型每天生成几亿篇"作文",人根本改不过来。
于是有了第三种考法:请一个更强的 AI 当裁判,给其他 AI 的回答打分。
这个方法有个行业名字,叫"AI 当裁判"(LLM-as-a-Judge)。你可以理解成:请班里的学霸帮老师改作文。
6.1 学霸改作文,靠谱吗
出乎很多人意料:挺靠谱。
研究发现,让最强的模型当裁判,它的打分跟人类评委的意见一致率能超过 80%。也就是说,10 篇作文里有 8 篇,学霸和老师给出的评价是一样的。
而且学霸有三大优势:
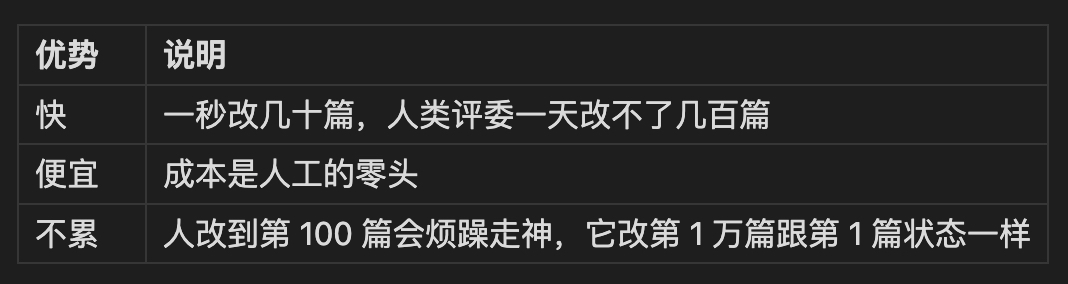
所以现在行业里大量的评测,背后都是 AI 在给 AI 打分。你看到的很多"生成质量得分",裁判其实不是人。
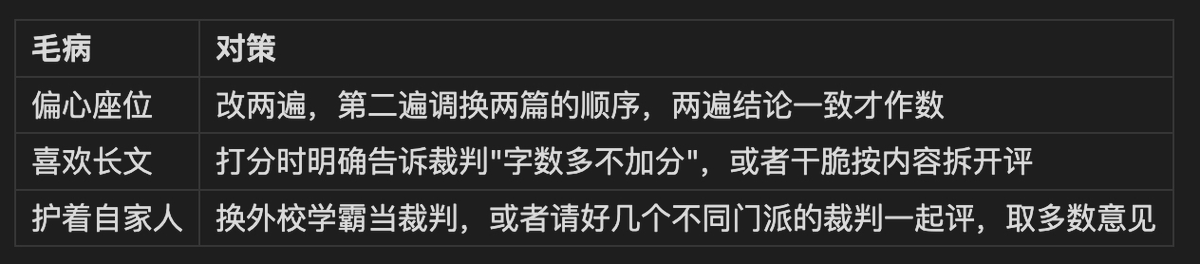
6.2 但学霸有三个毛病
用学霸改作文,省是省了,但这个学霸有三个改不掉的毛病。每个毛病都被研究证实过。
毛病一:偏心座位。
给学霸两篇作文让它挑好的,它会莫名其妙偏爱"放在前面的那一篇"。同样两篇文章,调换一下先后顺序,它的选择可能就变了。
这叫位置偏好。解决办法是让它改两遍,第二遍把两篇文章调换顺序,两遍答案一致才作数。
毛病二:喜欢长篇大论。
两个回答质量差不多,学霸倾向于给字数多的那个打高分。它容易把"写得长"当成"写得好"。
这个毛病还会产生连锁反应:被打分的模型慢慢学会了讨好裁判,回答越写越长、越写越华丽,实际内容并没有变好。就像学生发现老师喜欢辞藻华丽的作文,于是开始堆砌成语。
毛病三:护着自家人。
让某个模型当裁判,去评它自己(或者它同门师弟)的回答,它会不自觉地打高分。就像让哥哥给弟弟的作文打分,多少会手下留情。
好消息是,这三个毛病都有对策,正经的评测机构都会做这几件事:
https://x.com/@ai_xiaomu还有一个让学霸变靠谱的关键技巧:别问"哪个好",要给它一张评分表。
比如评一份数据分析报告,与其笼统地问"写得好不好",不如拆成四个得分点让它逐条打勾:数字查对了吗、比较做对了吗、结论对了吗、格式对了吗。
拆得越细,学霸评得越准。这跟人类老师改卷要按"采分点"给分,是一个道理。
6.3 什么时候能信,什么时候不能信
给你一个简单的判断标准。
这些情况可以信:
- 日常内容的打分:文案、总结、翻译、聊天质量
- 大批量的初步筛选:先用 AI 裁判从 100 个回答里挑出前 10,再由人细看
- 打分时附带了明确的评分标准,而不是笼统地问"哪个更好"
这些情况不能信:
- 医疗、法律、金融这类高风险内容:AI 裁判看不出"这个药物剂量是错的"这种要命的错误,必须由真专家把关
- 裁判和选手是同一家的:护短毛病躲不掉
- 两个回答的分数只差一点点:这种细微差距,AI 裁判的判断基本是抛硬币
AI 当裁判:快、便宜、大体靠谱,但要防着它偏心座位、喜欢长文、护着自家人。
科普完了,接下来,教你把这些知识变成随手能用的判断力。
第 7 章 成绩单审读法:四个必问的问题
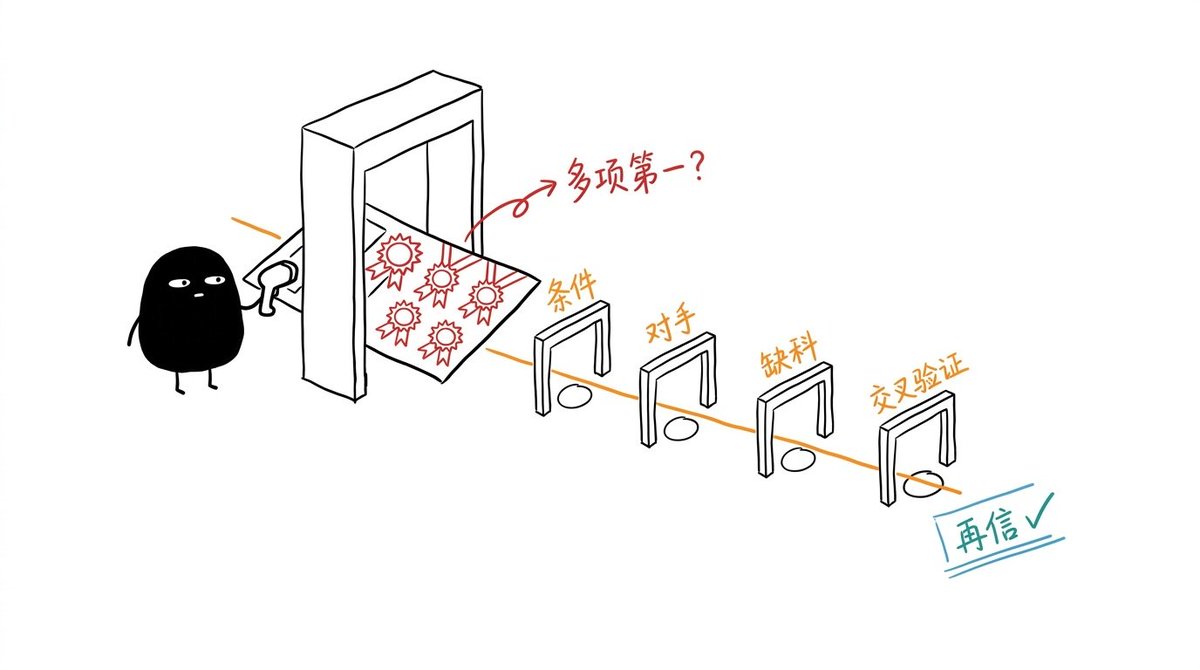
某天你刷到一条新闻,"某某模型发布,多项第一,碾压对手"。
别激动,也别急着转发。拿出四个问题,像过安检一样过一遍。
7.1 问题一:评测条件写了吗
翻到宣传图的角落,找小字。
给没给例题?打不打草稿?考几次取最好? 这些条件不写清楚,分数就没法跟别人比。
连条件都不敢写的成绩单,直接打个问号。
7.2 问题二:跟谁比的
看对比图里的对手是谁。
常见的套路有两种:
就像跟你说"我跑步赢了博尔特",仔细一看,赢的是退役五年后的博尔特。
7.3 问题三:哪科成绩没晒
拿出第 3 章的科目表,对着数:知识、数学、编程、看图、智商、干活、品德、中文。
它晒了哪几科?没晒的那几科,多半就是考砸的。
尤其要看你自己在乎的那一科。 你主要用它写中文内容,它只晒了英文卷和编程卷? 那这份成绩单对你参考价值有限。
7.4 问题四:别人怎么说
厂商的成绩单只是一面之词,花两分钟交叉验证:
- 去竞技场看它的排位分和排名(蒙名投票,最难作假)
- 去第三方对比网站看它的速度和价格(好用不好用,还得看快不快、贵不贵)
- 等一两周,看真实用户的口碑
一个真正的好模型,厂商成绩单、竞技场排位、用户口碑三样会互相印证。 三样对不上的,信排位和口碑,别信成绩单。
不差那点分的时候,选便宜和快的。 比如你写中文,deepseek和fable5价格差了好几倍,但质量差距你根本感觉不出来。
第 8 章 失败日志:几个常见的翻车场景
最后一章是失败日志,四个真实世界里反复发生的翻车场景,每个都按"症状、例子、为什么、本质"拆开讲。
这些坑,行业里的专业团队都踩过,你提前看一遍,就能绕着走。
8.1 翻车一:榜单高分,用起来不行
症状:按榜单挑了分数最高的模型,接到自己的事情上,效果远不如预期。
例子:一个团队要做中文客服,选了综合榜第一名的模型。 上线后发现它回答客户问题文绉绉的,不接地气,还经常答非所问。 反而是榜单排名靠后的另一个模型,用起来顺手得多。
为什么:榜单考的是"通用能力",你用的是"具体场景"。 综合分高,不代表你那个场景强。就像年级第一去菜市场砍价,未必砍得过菜市场老板娘。
本质:分数是入围门槛,不是最终裁决。榜单帮你筛掉明显差的,最后拍板前,一定要拿你自己真实会问的问题,亲手试一试候选模型。哪怕就试二十个问题,也比只看榜单强。
8.2 翻车二:两张成绩单对不上
症状:厂商说这模型某科考 90 分,另一家评测机构说只有 75 分。你懵了:到底谁在撒谎?
例子:某模型发布时宣传知识卷高分,社区自己一测低了十几分,评论区吵成一团,双方都觉得对方有问题。
为什么:多数时候没人撒谎,是评测条件不一样。一个给了例题、允许打草稿、考十次取最好;另一个啥都不给、只考一次。同一个学生,两种考法,分数自然对不上。
本质:脱离评测条件谈分数,都是耍流氓。 看到分数打架,先翻两边的评测条件说明。条件不写清楚的那一方,参考价值打折。
8.3 翻车三:新模型排位虚高就冲
症状:一个新模型上了竞技场,排位分冲得很高,你立刻切换过去用,结果体验平平。
例子:新模型刚上榜时只积累了几百场对战,恰好碰到的对手偏弱,分数虚高。几周后对战多了,排名掉了七八位。
为什么:排位分需要大量对战才能稳下来。就像游戏里刚打完定级赛的新号,段位不代表真实水平,得再打几百场才准。
本质:看排位分要连投票数一起看。 几十万场对战的 1300 分,和五百场对战的 1300 分,完全不是一回事。新模型上榜,等两三周再下结论。
8.4 翻车四:只看总分,不看单科
症状:选了总分最高的模型,结果它恰好在你最需要的那一科上是短板。
例子:有人看某模型综合排名第三就拿来写代码,用着总觉得不顺。后来才发现:另一个综合排名第五的模型,编程单科是第一。总分高的那个,是靠知识和写作把编程的短板拉平了。
为什么:总分是各科成绩的混合。两个总分一样的学生,可能一个偏文、一个偏理。你只需要它干一件事的时候,总分的参考价值反而下降。
本质:用总分选"通才",用单科分选"专才"。 你让模型干的事越具体,越应该看那一科的单科分和分类榜。
写在最后
落到实处就一句话:
你要干什么,就选那件事上单科最强、性价比最高的模型。
写代码就看编程分榜,写中文就看中文分榜,日常问答就看竞技场排位。
用 CC Switch 把这些模型组合起来,按任务自动路由:用性价比最高的模型完成你的日常工作。
看懂了这篇,你就明白了"xx模型第一"是怎么出来的,也避免花冤枉钱。
黄小木|T11级工程师|内容为codex创作,若有侵权请指出|持续分享 AI 信息、副业赚钱、程序员转型OPC心得|X:@ai_xiaomu