
AI 视频新手指南(二):怎么免费获得优质提示词?
上一篇分享了如何利用免费工具,把“生成—下载—发布”的 AI 视频工作流跑起来。
当工作流稳定以后,下一个真正影响作品质量的问题就是:
怎么持续获得优质提示词?
AI 生成图片和视频时,提示词决定了人物、场景、动作、镜头、光线和整体风格。提示词越清晰,生成结果通常越接近你的想法。
这次依然不推荐付费课程,也不需要购买提示词库。
一部手机,加上豆包 App,就可以完成找灵感、获取提示词、优化提示词和生成测试。
一、先去哪里找优质提示词?
打开豆包手机 App,进入:
AI 创作
https://x.com/AIVideoHub_/status/2082421822419771745?s=20在这里,你可以看到其他用户使用豆包生成的图片和视频。

相比在网上盲目搜索提示词,这种方式更加直观。你可以先看成品,再判断:
- 这是不是我喜欢的画面风格?
- 人物、服装和场景是否符合我的需求?
- 镜头、构图和光线能不能借鉴?
- 这套提示词适合生成图片,还是适合生成视频?
找到喜欢的作品后,点进去就能查看并获取它所使用的提示词。

这一步的重点不是原封不动地复制,而是先找到一个接近你目标的“提示词底稿”。
二、拿到提示词后,不要直接生成
获取提示词只是第一步。
别人使用效果不错的提示词,不一定完全适合你的角色、画面比例、模型和审美。
你还需要根据自己的需求进行优化,例如:
- 更换人物或服装
- 调整场景和时间
- 改变镜头角度
- 增加人物动作
- 调整画面风格
- 强化光线和氛围
- 删除互相冲突的描述
- 针对具体模型重新组织语言
提示词不是越长越好,而是要让模型清楚地理解:
谁,在什么地方,穿什么,做什么,镜头怎么拍,最终呈现什么风格。
三、怎么让 AI 帮你优化提示词?
把获得的提示词发送给豆包、GPT 或 Grok,并告诉 AI:
- 你准备使用什么模型
- 你准备生成图片还是视频
- 你希望修改哪些内容
- 哪些核心元素必须保留
例如,豆包常见的创作模型包括:
- Seedream 4.5:用于生成图片
- Seedance 2.0:用于生成视频
所以,不要只说“帮我优化一下”。
最好把模型和修改目标一起告诉 AI。
通用指令可以这样写:
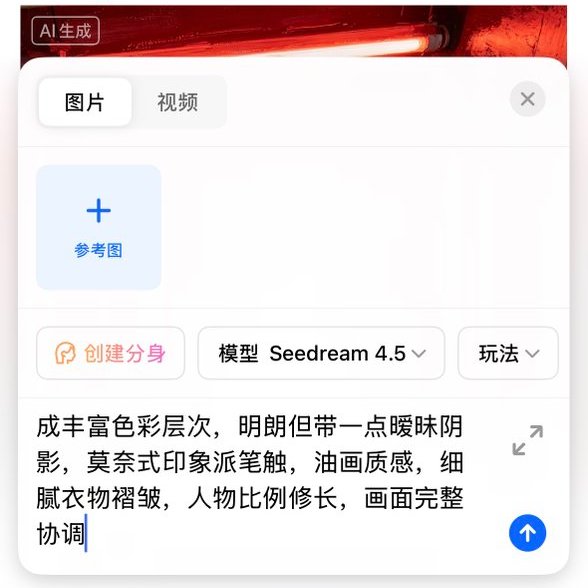
帮我优化以下提示词,我将使用 Seedream 4.5 生成图片。请保留原来的场景和人物气质,重点调整服装、构图和光线。不要堆砌重复形容词,避免互相冲突的描述,并输出一版可以直接复制使用的完整提示词。
生成视频时,可以改成:
帮我将以下图片提示词改写成适合 Seedance 2.0 的视频提示词。请补充人物动作、镜头运动、时间变化和画面节奏,保持人物与场景一致,并输出一版可以直接使用的完整提示词。
四、实际优化案例
例如,我在豆包 AI 创作中找到了一段提示词,希望保留原来的场景和日系氛围,同时调整服装设计,让人物形象更加成熟、有时尚感。
我发送给 AI 的修改要求是:
帮我优化以下提示词,我使用 Seedream 4.5 生成图片。人物必须是成年女性,保留暗红色霓虹灯、浅粉色护士主题服装、俯拍构图和日系甜美氛围。将服装调整为更具时尚感的改良领口设计,突出锁骨线条,但整体保持高级、不低俗。请删除重复描述,增强构图、光线和材质细节。
原始提示词
“狭小储物间内被暗红色霓虹灯管照亮,一位身形纤细的成年女性站在画面中央偏下,低束半扎发,浅粉色护士服搭配同色护士帽,瓷白透亮肌肤,桃花眼带着甜美又略显偏执的神情。金属圈耳饰、猫眼美甲和细钻手链清晰可见,指尖轻轻捻着一卷医疗绷带,脚穿细高跟鞋。
俯拍视角从上往下拍摄,空间紧凑但构图优雅。整体呈现日系甜美、轻微病娇感的视觉氛围,弱化恐怖元素。柔焦、胶片颗粒和柔和光线共同营造朦胧质感,暗红色与浅粉色形成丰富的色彩层次。莫奈式印象派笔触,油画质感,细腻衣物褶皱,人物比例修长,完整全身构图。”
优化后的提示词
“狭小而整洁的储物间,暗红色霓虹灯管作为主要环境光源,镜头采用从上向下的俯拍视角。一位身形纤细、比例修长的成年女性位于画面中央偏下位置,留着低束半扎发,身穿浅粉色改良护士主题服装,采用简洁时尚的领口设计,自然呈现肩颈与锁骨线条,搭配同色护士帽和细高跟鞋。
她拥有白皙通透的肌肤、柔和的桃花眼和甜美中略带偏执感的神情。金属圈耳饰、猫眼美甲和细钻手链细节清晰,指尖轻轻捻着一卷医疗绷带,动作自然克制。
狭小空间形成紧凑的纵深关系,但整体构图保持平衡、优雅。暗红色霓虹光与浅粉色服装形成鲜明而和谐的色彩对比,柔和漫射光在人物面部、发丝和衣物褶皱上形成细腻过渡。整体呈现日系甜美、轻微病娇感和时尚氛围,弱化恐怖与惊悚元素。
柔焦镜头、轻微胶片颗粒、朦胧阴影、莫奈式印象派笔触与细腻油画质感。完整全身入镜,人物比例自然协调,衣物材质和皮肤纹理清晰,画面细节丰富,高画质。”
可以看到,优化并不是简单增加更多形容词,而是完成了几件事:
明确人物年龄、减少重复描述、统一视觉风格、强化镜头构图,并让服装要求表达得更加准确。
得出以下图片:
五、开始生成并测试不同版本
提示词优化完成后,回到豆包的 AI 创作页面开始生成。
生成前可以根据用途选择画面比例:
- 9:16:适合短视频和手机内容
- 3:4:适合小红书和人物写真
- 1:1:适合头像、封面和社交媒体配图
- 16:9:适合横版视频、文章头图和 YouTube
风格选项也可以多测试几次。
同一段提示词,不同画面比例、风格和随机结果,可能会产生完全不同的效果。不要只生成一次就下结论,建议每次只修改一个变量,这样才能判断到底是哪部分影响了结果。
例如:
第一轮只测试构图,第二轮调整服装,第三轮优化光线,第四轮再处理人物表情。
这样比一次性修改全部内容更容易获得稳定结果。
六、遇到无法生成怎么办?
有时系统会提示:
我暂时无法生成你要求的内容,请尝试输入其他要求。
遇到这种情况,不要一直重复提交原提示词。
把提示信息和原始提示词发给 AI,让它检查可能存在的问题,并重新改写为更清晰、合规的表达。
可以这样说:
这段提示词暂时无法生成。请检查其中可能引起误解或不符合平台要求的描述,在保留核心场景、人物气质和画面风格的前提下,改写成更安全、清晰、可以正常生成的版本。
通常可以通过以下方式解决:
- 明确人物是成年人
- 删除过度身体化的描述
- 弱化暴力、恐怖或危险元素
- 把模糊词语改成具体的服装和镜头语言
- 删除容易产生歧义的表达
- 避免同时出现大量互相冲突的风格
最后总结
免费获得优质提示词的完整流程其实很简单:
豆包 AI 创作找灵感 → 获取提示词底稿 → 告诉 AI 使用的模型 → 提出具体修改要求 → 生成多个版本 → 根据结果继续优化
不要迷信所谓的“万能提示词”。
真正有价值的能力,是看到一个喜欢的作品后,能够拆解它的角色、场景、动作、镜头、光线和风格,再把这些内容改造成适合自己的提示词。
工具可以免费用,提示词也可以免费找。
但审美、判断和持续测试,才是你真正需要建立的能力。
好了,这期就分享到这里。
祝大家生成顺利,早日跑通自己的 AI 内容工作流。
AI 视频新手入门:先别急着付费,用豆包免费跑通完整工作流
传送门:https://x.com/AIVideoHub_/status/2082421822419771745?s=20