
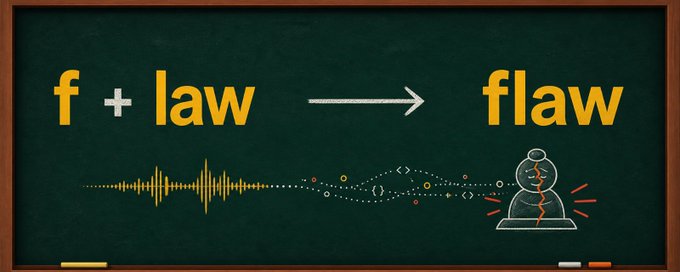
我把一个英文单词拆成中文故事,又把这套记忆法做成了开源视频 Skill
这个项目最初的问题很简单:
能不能参照抖音上的“一秒钟记一个单词”,输入一个英文单词,自动生成一条结构稳定的助记视频?
比如 vocal。
先告诉观众它是“直言不讳的”,再用一句有情绪的中文把声音和含义连起来,最后连续重复四次:
vocal!vocal!vocal!vocal!直言不讳的!
一开始我以为,难点只是找一个中文谐音,再让字幕动起来。
真正开始复刻参考视频以后才发现,这类内容同时涉及英文发音、中文助记、旁白边界、动态图形和短视频节奏。任何一层处理得不准确,成片就会变成“有动画的单词卡”,而不是参考视频里的记忆过程。
最终,这些修改被整理成了一个开源 Skill:
它不使用 Qwen,也不使用图片或视频生成模型。画面完全由 HTML、CSS、SVG 和 GSAP 编排,声音使用 Edge TTS,最后通过 HyperFrames 渲染并检查编码后的 MP4。

同一个单词,其实包含三个不同问题
制作这类视频时,最容易混淆的是三个概念:
- 英文单词真正的音节和发音。
- 为了记忆而设计的发音块。
- 根据发音块创作的中文助记故事。
它们彼此相关,却不是同一回事。
例如 flaw 是一个单音节词。如果严格按照音节数量处理,它只能作为一个整体出现。但只保留一个中文谐音,通常没有足够的素材组成故事。
因此,项目最后采用:
f + law 佛 落
这里的 f 和 law 不是两个音节,而是为了视觉记忆设计的两个 sound chunks,也就是“发音块”。
这条边界很重要。
我们可以为了记忆把声音拆得更细,却不能为了让故事成立,就告诉观众 flaw 有两个音节。趣味助记可以近似,语言学结论不能随意改变。
项目因此形成了一套和“查资料”类似的分工:
内容负责什么不能冒充什么单词与 IPA提供标准读音和含义不能由中文谐音反推真实发音发音块为动画和记忆提供可操作的声音片段不等于语言学音节中文助记字帮助中国观众建立声音联想不要求与英语音素完全一致助记故事把声音联想自然连接到词义不能只是把谐音和释义硬拼起来Edge TTS 边界决定文字什么时候出现不能用另一个单词的旧时间轴代替
有了这层区分,系统才不会把“为了好记的拆法”包装成“正确的英语音节分析”。
第一版的问题,不是不能播放,而是不像参考视频
最早的测试一次放了多个单词,也重新设计了开场方式。
但用户很快指出:每条视频只需要处理一个单词,而且参考视频从一开始就把完整单词亮出来了。任务是复刻它的结构,不是另做一套创意模板。
随后,开场规则被反复校准:
- 第 0 帧直接显示完整英文单词。
- 音标紧跟在单词下面。
- 中文释义同时出现。
- 首屏不能提前显示中文助记答案。
- 重要内容必须上下左右居中。
- 字号要足够大,补充说明保持次要。
以 ambitious 为例,首屏可以显示 ambitious、音标和“有野心的”,但不能立即读“俺必胜”。
旁白必须先完整介绍:
一秒钟记一个单词,今天要记的是 ambitious,有野心的。
只有这句话结束以后,才进入中文助记和组装阶段。
这个顺序决定了观众的认知过程:先知道今天要学什么,再看到它怎样被拆开和记住。如果首屏直接把谐音答案全部亮出来,后面的动画就失去了揭晓感。
字幕不是整句出现,而是被声音一个字一个字叫出来
制作 vivid 时,用户发现首屏提前出现了“微微的”。
正确的过程应该是:首屏只显示 vivid、音标和释义;等旁白真正读到“微、微”时,两个中文“微”才依次出现。
这意味着动画不能只使用人工填写的几组大概时间。
项目先让 Edge TTS 生成一条连续旁白,同时保存每个词的 WordBoundary。中文助记字通常在对应发音边界前 0.03 到 0.08 秒进入,让人眼感受到文字和声音几乎同时发生。
画面可以先显示英文发音块,但旁白不会逐个朗读这些英文碎片。
以 flaw 为例:
画面先出现:f law 旁白随后只读:佛,落
读到“佛”时,“佛”出现在 f 下面;读到“落”时,“落”才出现在 law 下面。
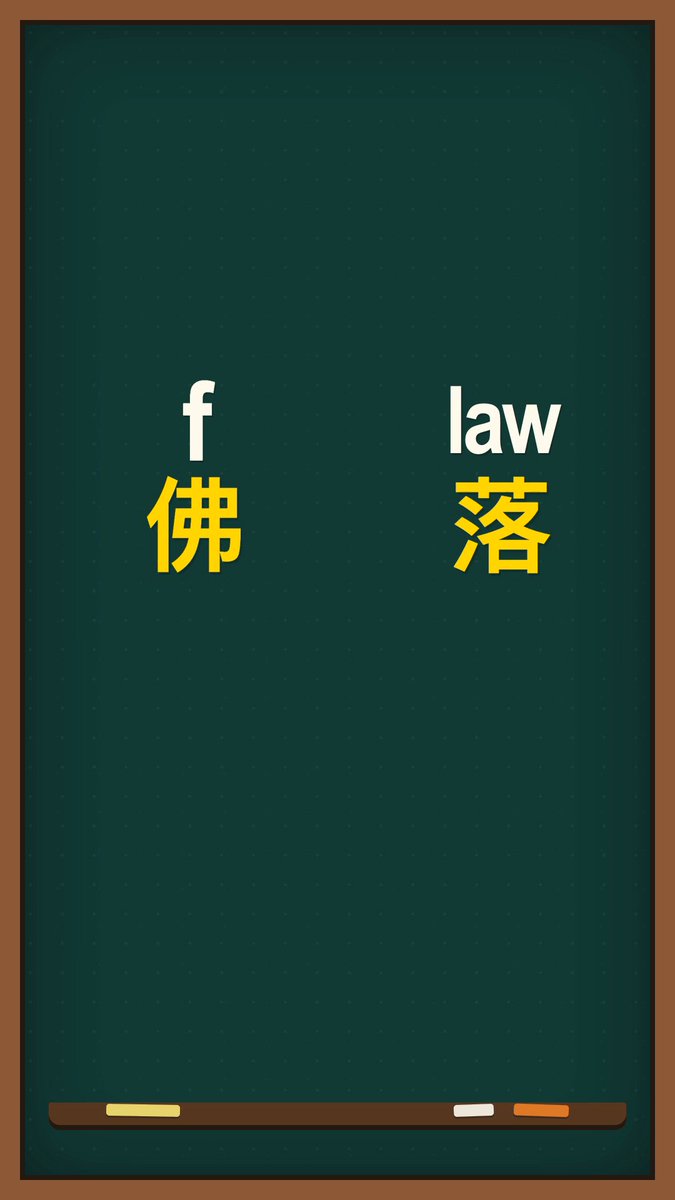
这种做法看起来只是精确了零点几秒,实际上决定了观众会不会把英文声音和中文记忆点对应起来。
单音节也尽可能拆,但必须先比较多个方案
用户后来提出了一个对记忆视频很实用的约束:尽可能不要只保留一个发音块,因为单块很难编出有动作、有因果的小故事。
因此,Skill 不会看到单音节词就立即放弃拆分,而是先尝试两到三种可能方案:
- onset 与 rime 的边界;
- 其他仍能保持发音可识别度的声音边界;
- 整词谐音作为最后的回退方案。
每个方案需要同时比较两件事:
- 拆完以后,观众还能不能认出目标单词的声音。
- 对应的中文单位能不能形成自然的动作或事件。
flaw 最后选择 f + law,不是因为它在语言学上是最标准的音节切分,而是因为“佛+落”能够形成非常清楚的动作。
如果所有多块方案都会让发音严重失真,或者仍然无法写出自然故事,才允许退回整词单块助记。这个例外还必须记录在项目的 BRIEF.md 中,说明尝试过哪些拆法、为什么放弃。
这样一来,“想到什么谐音就用什么”就变成了一套可以复查的候选比较过程。
真正困难的不是谐音,而是让故事自然落到释义上
有了“佛、落”,并不代表文案已经完成。
如果只是说:
佛落了,所以 flaw 是瑕疵、缺陷。
观众仍然不知道“佛落”为什么会产生“瑕疵”。助记和释义之间缺少一个具体、可见的因果关系。
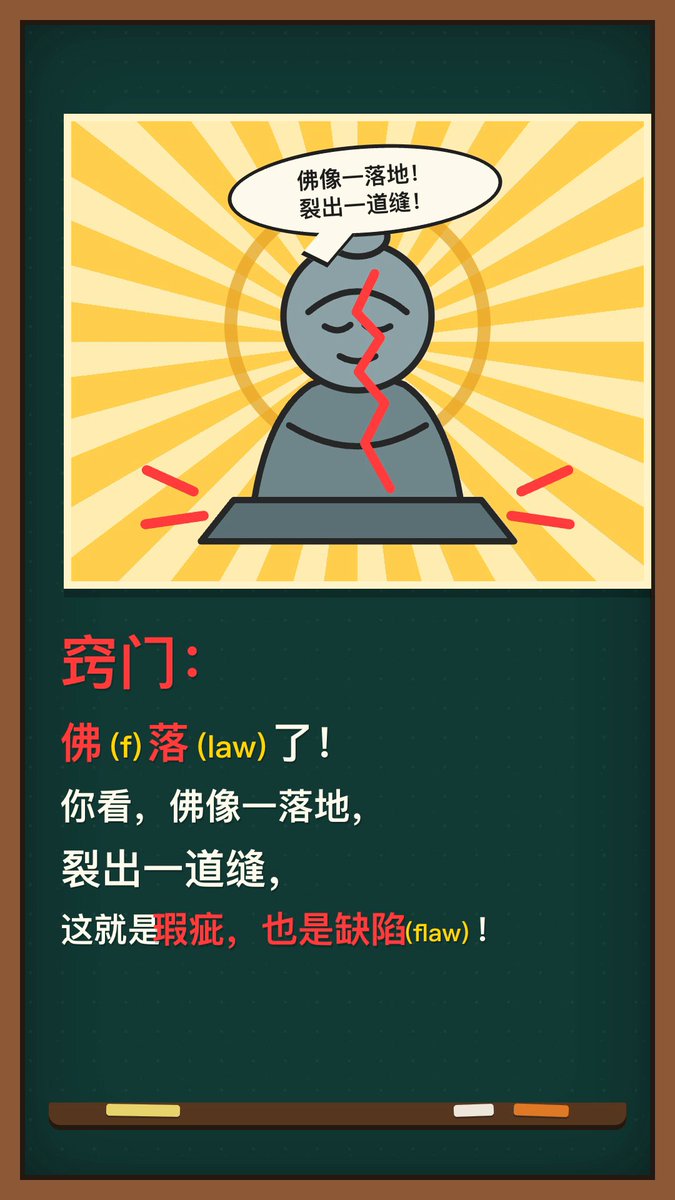
最终文案改成:
佛落了!你看,佛像一落地,裂出一道缝,这就是瑕疵,也是缺陷!
现在故事形成了完整链路:
佛像落地 → 裂出一道缝 → 出现瑕疵和缺陷 → 记住 flaw

vivid 的修改也暴露过同样的问题。句子虽然语法正确,却像是为了塞进“生动、鲜明”而临时拼接,读起来很生硬。
后来 Skill 增加了“自然语义桥接”规则:
- 优先使用具体人物、动作和物体。
- 让动作自然产生目标含义。
- 避免抽象地重复字典释义。
- 拒绝只把中文谐音和中文释义排列在同一句里。
发音块负责让人想起声音,故事负责让人想起含义。两者缺一不可。
组装必须真的拼成完整单词
参考视频的重要一拍,是拆开的英文发音块重新移动到一起,组成完整单词。
早期版本看起来已经“组装”了,但逐帧检查以后发现:
- 拼词时的高亮光效遮住了字母。
- f 和 law 移动后中间仍然有明显空隙。
- 完整单词刚刚形成就立刻切换,观众没有时间看清。
- 有些实现直接用一份新的完整单词覆盖原来的发音块,并不是真正的组装。
最终规则是复用屏幕上的同一组英文块,让它们移动、缩放并真正闭合成连续的 flaw,随后清楚停留,再进入“窍门”段落。
这个细节也说明了为什么项目没有使用视频生成模型。
生成式视频也许能做出“几个字母飞到一起”的大致效果,却很难稳定保证每一帧的间距、中心位置、文字清晰度和最后停留时间。代码动画更适合这种对几何关系和时序有严格要求的内容。
“所以”和四次重复,是记忆结构的一部分
故事解释完以后,画面不能直接结束。
参考结构会让“所以”单独占据一个强节奏画面,然后连续重复四次目标单词。
四个单词分别出现在画面的上、左、右、下,随后中文释义在中间出现,音标保留在释义下方,一直停到最后一帧。
这并不是为了把视频拖长,而是在短时间里完成四次不同位置的视觉强化。
末帧最初曾遗漏音标,用户指出后,它也被写进了硬性验收条件:最终画面必须同时保留四个单词、中文释义和 IPA。

浏览器里正常,不代表最终视频正常
动态图形项目很容易在网页预览正常,却在最终编码以后出现问题:
- 字体替换导致换行。
- SVG 路径在绘制前短暂露出端点。
- 转场中出现黑帧。
- 注释括号在缩放时被裁掉。
- 音频变成单声道或采样率不正确。
- MP4 没有 faststart,网络播放需要等待完整下载。
flaw 的裂纹动画就曾在正式绘制前露出红色端点,最后通过初始 opacity: 0 修复。例句中的 (flaw) 和末帧 IPA,也是在最终编码视频的全分辨率抽帧中重新确认的。
当前 Skill 要求最终成片至少满足:
- H.264 / yuv420p;
- 1080×1920;
- 24 fps;
- AAC 双声道 / 48 kHz;
- moov 位于 mdat 前,支持 faststart;
- 无黑帧;
- 无无法解释的长静音;
- 关键画面从最终 MP4 重新抽帧检查。
实测 flaw 成片为 18.208 秒、437 帧,综合响度约 -20.4 LUFS,True Peak 约 -6.6 dBFS。
每一次用户纠正,最后都变成了一条 Skill 规则
这个项目最有价值的地方,不只是做出了 ambitious、vivid 和 flaw。
更重要的是,每一次“不像参考视频”的地方,最后都变成了下一次不会再犯的规则:
- 一条视频只处理一个单词。
- 首屏从第 0 帧显示单词、IPA 和释义。
- 中文助记不能提前泄露。
- 首屏先完整介绍单词,之后才进入拆解。
- 英文发音块只显示,不逐块朗读。
- 中文助记字必须在对应中文发音边界出现。
- 单音节词也要优先比较多个发音块方案。
- 发音块不能被错误称为多个音节。
- 助记故事必须通过具体因果关系抵达词义。
- 发音块要真正闭合成完整单词并清楚停留。
- “所以”单独成拍,随后完成四次重复。
- 最终帧保留释义和 IPA。
- 只有最终编码 MP4 通过检查,任务才算完成。
这些规则已经被整理进 douyin-one-second-word-video Skill,并配套了 Edge TTS 词边界脚本和最终媒体 QA 脚本。
安装到 Codex:
curl -fsSL https://raw.githubusercontent.com/Mr-funny/hbg-douyin-one-second-word-video/main/install.sh | sh
之后只需要告诉 Agent:
使用 $douyin-one-second-word-video 制作 vivid:生动的,鲜明的。
这个项目真正自动化的,不是“编一个谐音”
回头看,最初的想法只是让 AI 帮忙做一条单词记忆视频。
最终沉淀下来的,却是一条从声音到故事、从故事到动画、从动画到成片检查的完整链路:
确认单词、IPA 和释义 → 比较多个发音块候选 → 设计中文声音映射 → 写出自然因果故事 → 生成连续 Edge TTS → 用真实边界驱动字幕与动画 → 组装完整单词 → 四次重复强化 → 检查最终编码 MP4
一个好记的谐音可能来自灵感,但一套能够持续生产的视频系统不能只依赖灵感。
它需要知道哪些内容可以近似,哪些概念不能混淆;哪些画面可以自由变化,哪些节奏必须保持;哪些问题肉眼看起来差不多,到了最终视频里却必须精确到帧。
这也许才是这个开源 Skill 真正想解决的问题:
不是让 AI 随便编一句中文去碰运气,而是把一次成功的单词记忆过程,变成下一次仍然可以稳定复用的能力。