
AI 学的越勤快,反而错的越牢?
最近看 Agent 项目,经常会碰到「自进化」这个词。通常的解释是:模型做完任务,收集反馈,再把这些反馈用于下一轮训练。循环跑起来,能力就会往上走。
这套说法听着很顺。可我读 Alloomi @AlloomiAI 两份技术报告时,脑子里一直冒出另一个问题:真实工作的记录那么乱,模型到底该信哪一条?
拿合同审查来说。同一个客户三个月前接受的风险,今天可能已经无法接受;律师写进初稿的意见,到了终稿也许被全部推翻。数据库保存这些版本很容易。训练模型之前,还得分清哪些内容已经失效。
如果经验选错了,训练越勤快,错误反而记得越牢。
Alloomi 的技术路线有意思的地方,就在这里。它没有直接从「怎么训练」讲起。第一份报告 Holistic Context 先处理混乱的工作历史,第二份报告 Self-Evolving Agent 才讨论怎样把整理后的经验送进模型。读下来更像上下两道工序:前面清理原料,后面负责加工。
先解决一个麻烦:AI 看到的历史往往是错的
假设一个 AI 在帮律师处理长期客户。
三个月前,客户接受某项风险;一个月前,新证据出现,律师推翻了原判断;上周,合同又换了版本。普通 RAG 可能把三段记录一起找回来。它知道过去说过什么,却不知道哪条现在仍然有效。
传统 RAG 遇到合同的多个版本,通常会按语义相似度找出相关片段。至于哪一版仍然生效、修改发生在哪个阶段,它未必分得清。
Holistic Context 给每条信息补上适用对象、任务、渠道和有效时间。同一个人的资料散落在邮件、会议和文件中,系统先把它们归到同一实体,再排成时间线。新证据推翻旧结论时,旧记录不会被删除,只会关闭有效期,并留下替代它的依据。
还有一个细节我觉得值得讲。
两条信息经常被一起用到,它们之间的联系会变强;长期没有共同出现,联系会慢慢减弱。关系也分类型,包括支持、竞争、相关和取代。检索因此多了一条路径,可以沿已经形成的关系继续追查。
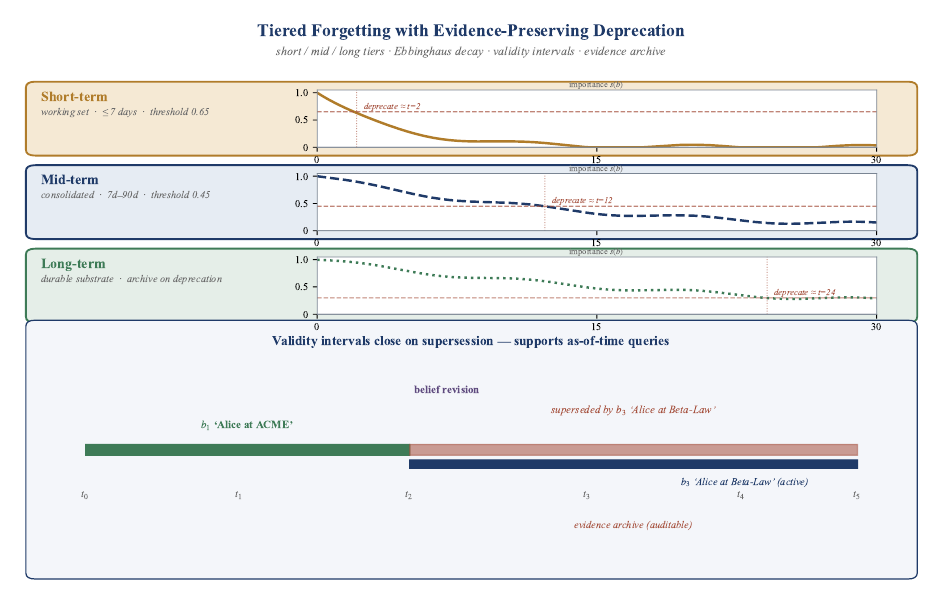
这一步很重要。错误的历史一旦变成训练数据,AI 用得越久,反而会把过期判断学得越牢。
经验整理好了,模型怎么吃进去?
整理好经验,仍然不等于模型学会了。Self-Evolving Agent 接着往下做。
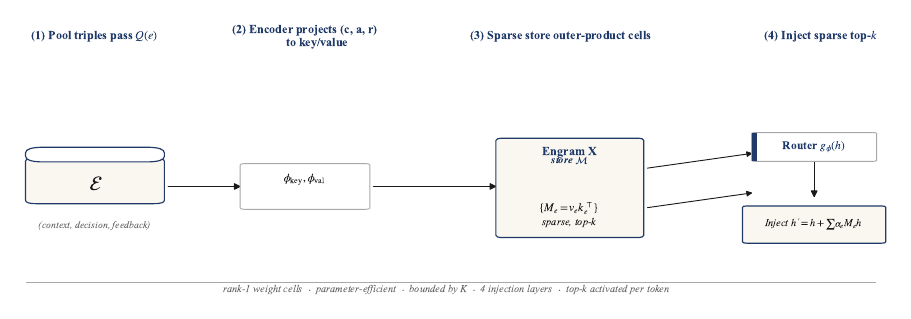
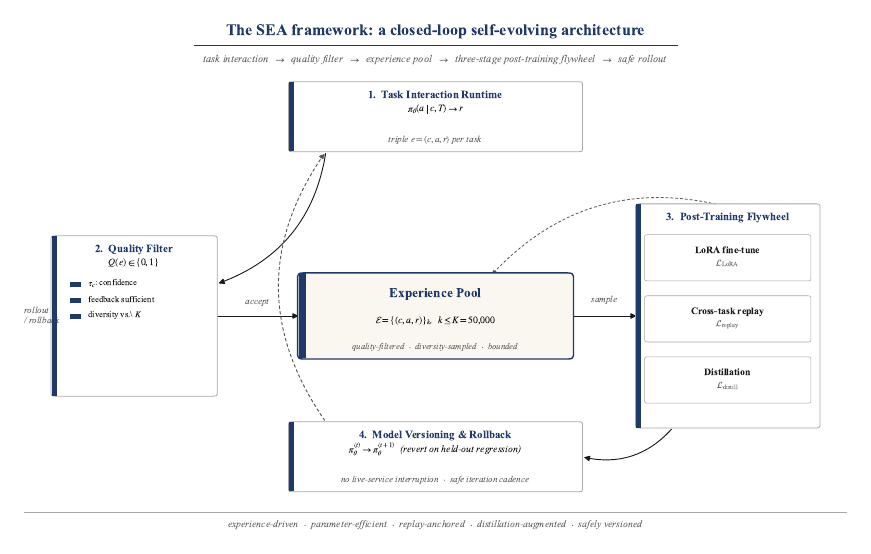
系统把任务背景、Agent 的操作和事后反馈组成一条经验。经验不会立刻进入训练池,它要先通过置信度、反馈完整度和重复性检查。经验池还有容量上限,避免数据只进不出。

训练分成几部分。当前任务的数据用于 LoRA 微调;旧任务会穿插回放,防止模型学了新东西就把过去忘掉。报告还引入更强教师模型的轨迹,让学生学习教师的决策分布。这里的用意很好理解:如果模型永远复习自己的旧答案,它很难跳出原来的能力范围。
Engram X 是其中比较特别的一层。通过筛选的经验会被编码成稀疏权重单元,推理时只激活少量相关单元。报告希望借此减少对外部检索和长文本拼接的依赖,让一部分经验进入模型内部的计算路径。
Alloomi 还加入了 Engram X,把部分经验编码进稀疏权重单元。这样做的目标,是减少每次推理都要检索并拼接大段历史的依赖。模型更新后不能直接上线,要先经过多项指标验证。效果变差,就退回上一个适配器版本。

这里的“自进化”更像一条受控生产线。什么经验能进来,向谁学习,更新后能不能上线,都有明确的门槛。
同一个模型,积累经验后有没有变强?
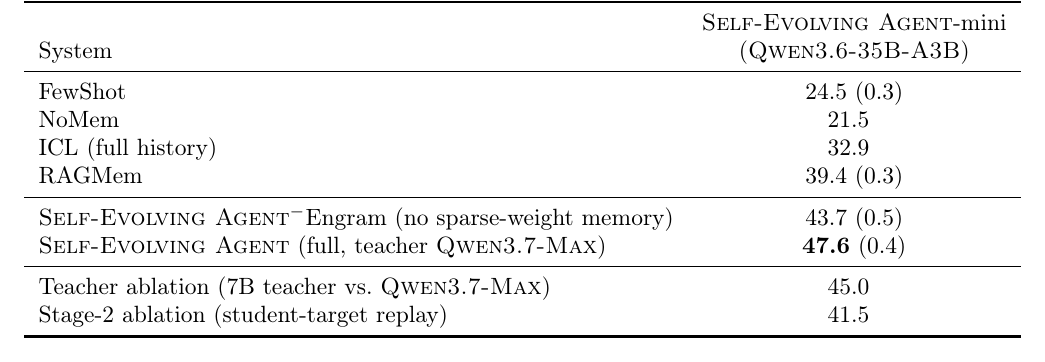
在完整的 1,899 项 CL-Bench 中,报告固定了 Qwen3.6-35B-A3B 基座和运行框架:
这组实验比跨模型排名更有解释力。换模型会混入参数规模、训练数据和推理预算;这里比较的是同一个基座在不同经验机制下的表现。加入完整 SEA 后,得分比 NoMem 高出 26.1 个百分点。
AI 公司的下一道分水岭
过去两年,Agent 的主要竞争发生在应用层:谁能接更多工具,谁能编排更长的工作流,谁能把更多资料塞进上下文。
这些能力让 AI 做更多事,却不会自动让它形成经验。真正困难的是另一条链路:应用捕获真实工作的过程和反馈,系统判断哪些经验可信,模型吸收这些经验,然后把提升带回下一次交付。
Alloomi 的两份报告给出了一套完整但仍在早期验证的答案。Holistic Context 负责避免 AI 学到过期和错位的历史,Self-Evolving Agent 再把筛选后的经验变成模型更新。CL-Bench 的同基座提升,是目前最有分量的证据;BEAM 10M 则说明这套方案并非简单地把上下文窗口做大。
这套技术最终要落到 Alloomi AI 上:面向法律、金融保险等专业团队,把真实工作中的修改、判断和结果反馈变成下一轮模型更新的原料。它能否形成产品壁垒,不取决于“自进化”这个名字,而取决于第二次交付是否真的优于第一次,而且这种提升能不能被验证、审计和回滚。