
从 OpenContext 本地部署,看懂 Alloomi 的自进化技术路线
今天的大多数 Agent 会调用工具也能完成一次性的复杂任务。但换一个会话、换一个项目,很多经验又要从头积累。
原因不只是上下文窗口不够长,而是系统没有把事实变化、过程判断和交付反馈沉淀成可持续维护的状态,更没有把这些经验转化为下一次任务中的稳定能力。
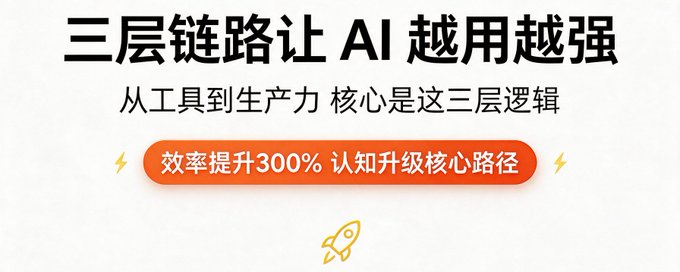
Alloomi @AlloomiAI 给出的答案不是单独做一个“记忆插件”,而是一条完整的自进化链路:
- Context:记得住。跨会话、跨平台维护实体、关系、时间和证据。
- Continual Learning:学得会。从任务轨迹和反馈中选择经验,通过回放、蒸馏和参数更新形成能力。
- Professional Delivery:做得成。把成长放回真实专业任务中,用结果和评测决定新版本是否可用。
这三层共同组成“工作 → 反馈 → 学习 → 再交付”的闭环。OpenContext 对应第一层,也是开发者目前最容易本地复现的一层。
两份技术报告,分别回答两个问题
1.Holistic Context:上下文不是窗口里的 token
HC 把上下文重新定义为跨会话持续维护的状态。它不是简单地把历史记录向量化后检索,而是围绕实体归一、适用范围归因、关系学习和带证据的退役机制,处理“同一个人是谁”“哪条信息更新了”“旧事实何时失效”“判断依据来自哪里”。
OpenContext 是这套思路的开源实现。它把外部记忆从单一的 retrieve 操作,扩展为实体、关系、时间变化和证据链等结构化能力。目标不是存得越多越好,而是用得越久仍然保持可解释、可更新。
2. Self\-Evolving Agent:记住之后,怎样真正学会?
SEA 把记忆作为学习飞轮的底座:先从执行轨迹中形成经验池,再以跨任务 replay 防止学新忘旧,通过外部 teacher 蒸馏和 LoRA 更新能力,最后由多指标 MAPE gate 决定新 adapter 是否发布;一旦整体能力退化,系统可以回滚到旧版本。
这里的关键区别是:Context 让 AI 在推理时调用过去,Continual Learning 则尝试把高价值经验内化为模型能力。两者不能互相替代。
9 项 benchmark 在验证什么?
https://x.com/AlloomiAI如何读这些数字:它们覆盖长期记忆、持续学习和专业交付三个层面,但不应全部当成同配置的严格横向对照。SEA 报告明确区分公开榜单背景与同 backbone、同 harness 的归因实验;JobBench 还存在 judge substitution。两份材料目前均为公开技术报告,不等同于正式同行评审论文。
我为什么先从 OpenContext 开始测?
因为它是整套路线中已经开源、可以直接拉到本地、还能通过 MCP 接入现有 Agent 的部分。对开发者来说,这比只转述 benchmark 更有价值:先验证系统能不能把零散事实写入、更新和取回,再讨论更重的学习与交付实验。
本地构建
https://github.com/melandlabs/opencontext如果只想先验证 HTTP daemon,也可以直接使用 npm 包:
https://alloomi.ai/浏览器直接访问根路径出现 404 Not Found 不代表启动失败;daemon 的健康检查地址是 /health,它本身不是一个网站首页。
通过 MCP 接入 Codex / Cursor / Claude Desktop
https://github.com/melandlabs/opencontextMCP server 的名字可以自定义;我使用 opencontext。接入后可先检查 memory.health,再调用 memory.writeRawMessage、memory.getRawMessage 和 memory.searchUnified。
一个最小复现实验
我写入三条带时间的事实:
- 1 月:端哥目前住在上海
- 3 月:端哥搬到了杭州
- 4 月:端哥更喜欢上午处理重要工作
随后在新会话询问“端哥现在住哪里”。这个实验至少要检查三件事:系统能否跨会话召回;能否识别 3 月事实对 1 月事实的更新;回答能否带回原始证据,而不是只给出一个无法追溯的结论。
我目前已经验证了本地 MCP 的写入与读取链路。更严谨的下一步,是固定 embedding、模型、数据集版本和评测 harness,再跑 LongMemEval\-S 或 LoCoMo\-V2;否则一次问答成功只能算 smoke test,不能等同于复现论文成绩。
我的结论
OpenContext 最值得关注的地方,不是又多了一个向量数据库封装,而是它把“上下文”放回了自进化系统的第一环:AI 先形成可维护的工作档案,才能筛选经验、持续学习,并把能力变化带回下一次专业交付。
所以这次本地部署不是对 Alloomi 的全部测评,而是从开发者视角验证完整路线的第一步。更重要的是让更多人看到:Alloomi 正在把 Context、Continual Learning 与 Professional Delivery 连成一套可以公开讨论、验证和迭代的技术体系。
如果你也在关注 Agent 的长期记忆与自进化,可以到 GitHub 看看 OpenContext;如果认可这条路线,也欢迎给项目一个 **Star**。
相关技术资料
- OpenContext GitHub:项目源码与复现实验
- Holistic Context 技术报告
- Self\-Evolving Agent 技术报告
- Alloomi 官方 X
- Alloomi 官网
- 官方贴文
一句话总结:OpenContext 解决“记得住”,SEA 解决“学得会”,真实交付与 benchmark 检查“做得成”;三者连起来,才是“让 AI 每完成一次交付,就获得一次成长”。