
「自进化数字员工」是怎样炼成的?拆解 Alloomi 的三层技术路线
一个 Agent 能找到过去,不代表它能从过去中学习。
别再问 Agent 有没有记忆了,该问的是它学没学会。
真正的自进化数字员工,需要同时通过“记得住、学得会、做得成”三类能力验证——让 AI 每完成一次交付,就获得一次成长。
01|检索不等于学习
如果把今天的 Agent 放到真实的企业工作流里,你会发现一个荒谬的现实:
- 一个人类员工处理过 100 次合同,通常会越来越熟练——他记得上次哪个条款被客户挑刺,记得哪位合伙人对风险的容忍度更低,记得三个月前那次修改是为什么。
- 一个 AI 数字员工处理过 100 次合同,第 101 次交付时,却依然可能犯下和第 1 次完全相同的低级错误。
入职第 365 天,它的能力可能还停在入职第 1 天。
过去两年,行业给 Agent 装了更大的向量数据库、更长的上下文窗口、更全的知识图谱。
但如果你观察得足够仔细,会发现一个很少被追问的底层问题:我们解决的究竟是“记忆”,还是“检索”?
大部分开发者在构建 Agent Memory 时,沿用的依然是标准的 RAG 范式:
这套方法当然有用。它能回答“用户过去说过什么”、“某份文件存在哪里”。
但把它直接当成数字员工的“长期记忆”,在真实长周期业务中会瞬间崩溃。
假设一个最常见的跨工具工作场景:
- 星期一在微信工作群里说:“我会在周五之前发送季度总结报告。”
- 星期二在飞书文档评论区:“将报告提交推迟到下周三——指标数据有变。”
- 星期三在微信工作群里发消息:“最终总结报告已准备就绪。”
如果你的记忆系统只是把句子嵌入成向量,检索时同时把周一和周二的消息文本塞进 Prompt,Agent 就会陷入混乱——究竟现在的截止日期是周五还是下周三?
这就是记忆腐烂:向量召回只能找到“语义相似的历史片段”,却无法回答:
谁在什么时间、针对什么项目作出了什么判断?这个判断为什么发生变化?现在真正有效的状态是什么?
在同一套严苛测试(Hindsight 团队重评估 pipeline)下,纯 RAG 方案在 10M 千万级 Token 规模下准确率跌至 24.9%,对比基线 LIGHT 同样跌至 26.6%。“存下来再搜”这条路径,在规模拉长后当场失灵。
一个 Agent 能找到过去,不代表它能从过去中学习。别再问 Agent 有没有记忆了,该问的是它学没学会。RAG 可以让 Agent 带着资料工作,但不会自动让 Agent 形成经验。检索解决“想起来”,自进化解决“学会了”。
02|Alloomi 的三层技术路线
要实现从“查找资料”到“内化经验”的跨越,Alloomi 提出了贯穿系统运转的三层技术路线:任务层、脚手架层与模型层。
需要先澄清两套“三层”的区别:
- 任务层 — 脚手架层 — 模型层:描述的是系统如何运转;
- 记得住 — 学得会 — 做得成:描述的是系统最终要通过的三类能力验证。
两者并非简单的一一对应关系。“做得成”是整套闭环最终在真实交付上的产出,而脚手架层的 MAPE 则是保障闭环运转的安全闸门。
Alloomi 的技术路线主要建立在两份公开技术报告上:
Holistic Context 与 Self-Evolving Agent
第一层|任务层:全域上下文
Holistic Context 放弃了简单的向量拼接,改为持续维护带有实体、来源和时间状态的业务上下文:
- 适用域归因 (5-tuple Scope Attribution):给每条信息标注 (task, conversation, channel, person, validity interval) 5 个标签,限定信息的适用范围,并支持实体时间线重建。
- 承诺生命周期与半开区间 [valid_from, valid_until):将承诺建模为状态机。当周二产生新变化时,旧信念的 valid_until 被自动闭合,留下 supersede(取代)记录,支持精准的时间旅行查询。
- 赫布联想网络 (Hebbian Relation Learning):基于“同时激活则关联强化”原理,构建包含支持、竞争与取代边的动态关系图谱。
Alloomi 提供的补充消融数据还显示:在 BEAM-10M 上,关闭跨会话归因后,得分从 41.3% 降至 30.8%,下降 10.5 个百分点。至少在这组千万 Token 规模的实验中,跨会话归因对全局状态理解具有明显贡献。
第二层|脚手架层:筛选、评测与回滚
有了业务状态只解决了“记得住”。错误答案与劣质样本一旦进入训练,会让进化变成积累偏差。Alloomi 在脚手架层建立了受控治理机制:
- 专家锚定 (Expert Anchoring):以专家示范和最优交付标准为基准,避免低质量自我循环。
- MAPE 控制环 (Monitor-Analyze-Plan-Execute):监测验证奖励(Reward)、校准误差(ECE)与推理轨迹一致性(Trace Consistency)。按照报告当前的配置,只有三项指标同时超过各自允许的退化范围,系统才触发回滚。
它是一套运行时治理机制,不是“模型一定会越学越好”的形式化数学保证。但也正因为有这层安全闸门,模型更新才具备可验证、可审计与可撤销性。
第三层|模型层:能力内化
经过筛选的经验,会进入由 LoRA 轻量训练、跨任务经验重放和强教师能力蒸馏组成的后训练流程(SEA):
- Engram X 稀疏残差流注入:在报告采用的 BF16、dh=4096 配置下,每条经验的稀疏存储开销约为 16KB。它将经验作为稀疏 Top-k 单元直接注入 Transformer 残差流,不再只依赖外部检索。
- 三阶段后训练飞轮:Stage 1 吸收轻量更新;Stage 2 通过经验重放抵抗灾难性遗忘;Stage 3 从更强的外部教师 Qwen3.7-Max 蒸馏能力。避免模型始终拿自己的旧答案当教材,导致“左脚踩右脚”把错误固化。
把三层路线串联起来,即构成了闭环链路:
真实任务轨迹 ➔ 质量筛选 ➔ 专家锚定 ➔ 后训练 ➔ 评测准入 ➔ 版本回滚
从而落到 Alloomi 的产品主张:让 AI 每完成一次交付,就获得一次成长。
03|九项 Benchmark:三类能力验证
一个架构到底有没有用,首先要看控制变量下的同基座消融,其次看多维能力验证。
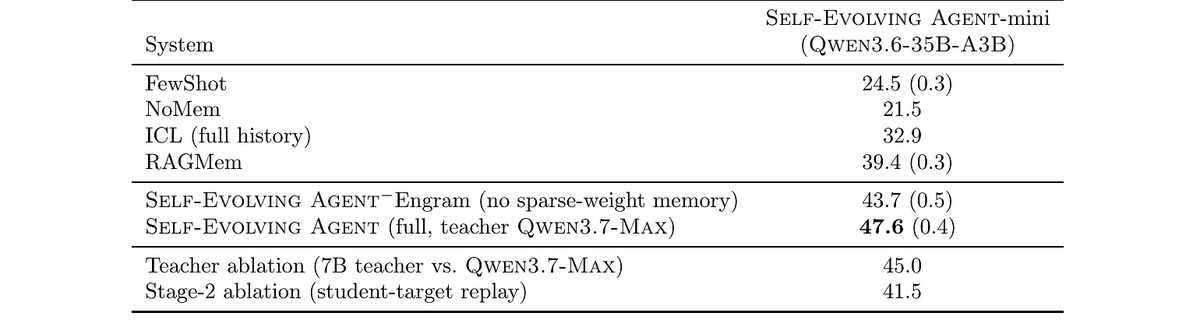
在保持 Qwen3.6-35B-A3B 基础模型和评测 Harness 一致时,SEA-mini 的 CL-Bench 通过率从 FewShot 的 24.5% 提升到 47.6%,提升 23.1 个百分点,接近原来的两倍。
https://x.com/AlloomiAI移除 Engram X 的核心对照提供了 3 个种子的逐种子结果(下降 3.9 个百分点);学生历史 logits 的 Stage-2 消融目前仍是固定基座下的单次点估计(下降 6.1 个百分点)。
在三类能力验证上,Alloomi 公开了九项 Benchmark 的表现:

记得住|长期记忆与全域理解
- BEAM 10M:67.0%,外部参考 Hindsight 的 64.1%;报告还列出了同规模下纯 RAG 24.9% 的公开结果。该评测考察千万 Token 历史规模下的全局任务能力。
- LongMemEval-S:97.6%,对比 Mem0-V3 (94.4%) 高 3.2 个百分点,比公开人类参考 (82.9%) 高 14.7 个百分点;测试长期信息提取、知识更新与多会话推理。
- LoCoMo-V2:97.4%,对比 Mem0-V3 (92.5%) 高 4.9 个百分点;测试跨会话问答、时间关系和多跳推理。
学得会|上下文学习与持续进化
- CL-Bench:47.6%,参考 GPT 5.6 SOL 为 21.5%;测试从复杂上下文学习新知识和新规则。
- CL-Bench-Life:32.1%,对比 GPT-5.5 (high) 的 22.2% 高 9.9 个百分点;测试长周期经验积累与迁移。
- Con.L Bench:32.6%,对比 Claude Sonnet 4.6 (22.3%) 高 10.3 个百分点;测试跨任务持续学习与抗遗忘。同榜统计中,SEA-mini 的单个任务序列 API 支出为 11.2 美元,低于 ICL + Claude Sonnet 4.6 的 30.4 美元。
做得成|真实任务与工程交付
- GDPval:74.2%;作为外部参考,benchlm.ai 榜单快照中的 Claude Opus 5 为 67.3%。两者数字相差 6.9 个百分点,但使用不同计分口径,不构成严格同尺度比较;覆盖高经济价值职业任务。
- JobBench:57.5%;参考 Kimi-K3 的 54.7%。由于 SEA-mini 使用了替代评审模型,这项结果不属于严格同评审口径的直接排名;测试真实职业任务和复杂工作流。
- SWE-Bench-CL:80.6%,对比 OpenCode + Kimi K3 + FAISS (73.3%) 高 7.3 个百分点;测试连续软件工程中的经验迁移与抗遗忘。
上述结果来自 Alloomi 官方技术报告和公开材料。HC 的主要结果属于单种子、单基座的可行性展示。SEA 的四个核心对照组提供了 3 个种子的结果,但部分非核心消融仍以固定基座的单次点估计呈现。
报告虽然给出了重采样置信区间和多重比较校正结果,也明确说明 k=3 只能视作跨种子一致性证据,而不是正式显著性结论。除明确标出的同基座实验外,部分外部对照还来自不同论文、模型、评审或计分配置,不应被理解为作者独立复测的严格同环境排名。
但这并不影响这条技术路线提出了一个值得认真讨论的问题:Agent 的终点,究竟是更擅长查资料,还是能把每次交付变成下一次工作的起点?��
存储历史 ➔ 向量检索 ➔ 召回片段 ➔ 拼接 Prompt ➔ 重新推理04|数字员工的三项检验
Alloomi 一边在做面向专业团队的自进化数字员工,一边通过 OpenContext 开放上下文运行时能力。
比具体产品更值得关注的是,它试图把三件过去相对分散的事放进同一个闭环:维护正确的长期上下文,从真实反馈中形成能力,再安全地管理模型更新。
以后判断一个数字员工,也许不该只问它今天能做什么,还应该问:
- 它能不能找到正确、仍然有效的过去?
- 专家的修改能不能影响下一次交付?
- 模型学偏以后,能不能被发现并回滚?
我们需要的不是越来越庞大的历史检索系统,而是一个能把有效经验带进下一次工作的 Agent。
一个 Agent 能找到过去,不代表它能从过去中学习。
你认为 Agent 的长期经验应该主要保存在数据库里,还是应该逐渐进入模型能力?
更多技术进展,可关注 @AlloomiAI
👉🏻 Holistic Context 技术报告
👉🏻 Self-Evolving Agent 技术报告
https://alloomi.ai/reports/hc.pdf如果这篇对你有帮助,关注 + 收藏 + 转发走一个呗 👏🏻
关注 @Lonely__MH,会持续更新新手向的教程和 AI 工具用得上的心得。