
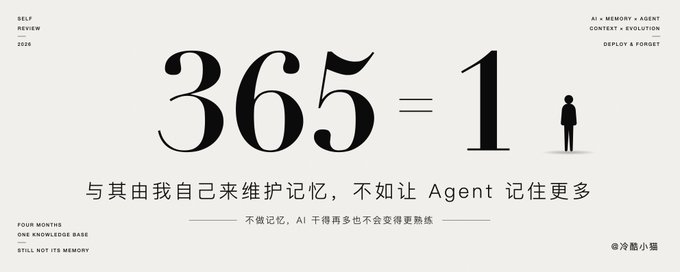
与其由我自己来维护记忆,不如让Agent记住更多
我为Agent做的知识管理,就是搭建了一个很大的知识库,以及每次手动在项目内创建Skill,有点像每次都在给Agent喂饭,还得是我自己嚼过的
我碰到的Agent使用痛点⬇️
一、Skill 迁移不过去
在项目内使用AI手动创建Skill,其实还是针对于项目有特异性的,同一个项目的经验无法把它完全抽取出来,迁移到另外一个项目
尴尬的是,之前我还发过一条推:
| 考察能力 | 评测 | Alloomi | 对比 | 能力详情 |
| :--- | :--- | :--- | :--- | :--- |
| **长期记忆** | LongMemEval-S | **97.6%** | Mem0-V3 94.4% | 长期信息提取、知识更新与多会话综合推理 |
| **持续学习** | CL-Bench-Life | **32.1%** | GPT-5.5 (high) 22.2% | 长周期、多阶段任务中的上下文学习与**经验迁移** |
| **超长上下文** | BEAM 10M | **67.0%** | Hindsight 64.1% | 千万 Token 历史规模下的全局任务理解与执行 |
三个月过去,我发现我还是误判了,落到 Skills 里也不是真能复用,换个项目大概率还是得重写
二、给AI搭建知识库
我这四个月以来,一直想搭建一个知识库框架,能够达到在最低摩擦的情况下,能存入知识,然后让 Agent 有更多的记忆可参考
4 月:
| 考察能力 | 评测 | Alloomi | 对比 | 能力详情 |
| :--- | :--- | :--- | :--- | :--- |
| **职业交付** | GDPval-AA Normalized | **74.2%** | Claude Opus 5 67.3% | 覆盖 9 大职业领域、44 类职业的高经济价值任务交付 |
| **工程抗遗忘** | SWE-Bench-CL | **80.6%** | OpenCode + Kimi-K3 + FAISS 73.3% | 真实 GitHub 问题修复、连续软件工程任务中的经验迁移与抗遗忘 |
5 月:
8 月:
三、知识库变大了,然后呢?
关于采集的这条链路,让知识库变大了,但是在实际使用Agent的时候,还是需要我做指定去读取这些对应的文件,它可能才能获取这些记忆
发现最后还是我自己人工在替 Agent 做记忆,而不是它自己在做记忆自进化
为什么得我来替它记?因为它自己什么都留不下。这一轮里它学会的、我纠正过的、它踩过的坑,会话一结束就全没了。下次开个新窗口,它还是那个什么都不知道的它
Alloomi 管这个叫部署即遗忘:模型部署完,能力就定在那一刻了,之后干多少活都不会再长进
今天处理 100 张发票的 AI,明天还是从零开始——入职第 365 天,和入职第 1 天是一样的
人不是这样的,人干得越多只会越熟练
四、Agent无痛自进化
我想要的是:它可以看到我的完整经验,然后进行自进化之后进行自我的训练,训练完成之后就把这些经验内化了。一方面是解放了我人工的工作,另一方面是对于我们人来说,AI可以无痛地进行自进化了 无痛的方式真的很重要
Alloomi 把这件事拆成三层
记得住,全域上下文:召回返回历史片段,全域上下文重建业务状态
或者说,召回解决 找到过去,全域上下文解决 理解过去如何演变成现在
学得会,自进化后训练
其中的一个能力,说得特别形象,用最近最强教师轨迹做回放,而不是回放学生自己的旧逻辑值( logits)
我这四个月,回放的就是我自己的旧逻辑值,但是我自己的能力增长速度其实远跟不上模型的进化速度
Alloomi技术报告公布的公开评测:
中间那条 CL-Bench-Life 就是经验迁移,正是我想要解决的那个痛点
记得住,学得会,接下来当然是实践
自此形成闭环:真实任务轨迹 → 质量筛选 → 专家锚定 → 后训练 → 评测准入 → 版本回滚
一句话总结,这个产品想实现的愿景是:让 AI 每完成一次交付,就获得一次成长
五、产品生态中开源的OpenContext
本地试了下OpenContext,记忆相关信息的效率不错,而且反馈的Bug修得很快,这几天就多了30多个提交
我觉得挺靠谱的,产品迭代很积极,也愿意听用户和客户的建议来改进,这恰恰是一个好的产品该有的样子,快速迭代与进步
六、未来的 Agent ?
所以我希望以后的 Agent 的产品,或者是针对于偏知识库类的 Agent 的产品,都需要有这种自进化的能力,或者是帮助用户组织属于他们自己的底层记忆的能力,期待产品的公测
@AllomiAI