
我之前把 Agent 记忆想简单了:记住,不等于学会
我之前写过一篇 Agent 记忆方案的文章,核心判断是:把旧聊天记录重新塞回 Prompt,不算真正的记忆。更好的方向,是从执行过程里提炼出策略,让 Agent 在下一次任务里少走一遍旧路。
https://alloomi.ai/reports/sea.pdf这个判断现在仍然成立,但我当时把问题想简单了。
记住历史,只是第一步。
真正长期工作的 Agent,还要回答四个问题:
- 这条信息现在还有效吗?
- 过去的判断为什么后来被改掉了?
- 上一次交付得到的反馈,能不能改变下一次行为?
- 如果它学偏了,谁能发现,能不能退回去?
记住历史,第一步就会撞上过期信息
我最近一次做跨 Agent 记忆测试时,系统找出了 960 条历史记录。

数量看起来不少,但真正难的地方很快就出现了:同一个项目里,同时存在旧方案、新方案和没有完成的事项。
比如供应商已经换过一次,旧记录还在;某个 PR 的自动摘要写着“已经部署”,完整历史却只能证明“已经创建,等待验证”。
系统把它们都召回,并不代表它知道哪条应该被相信。
最后最有价值的回答,反而不是一个看起来很确定的结论,而是:这几条记录互相冲突,目前只能确认到这里。

这件事让我重新理解了 Agent 记忆。
记忆系统最怕的不是少记一条,而是把过期信息当成当前事实,带着 Agent 继续往错误方向执行。
Agent 记忆不是一个更大的向量数据库
传统的记忆方案通常从一个合理的地方开始:把历史切块、建立索引、根据问题召回相关片段,再放回上下文。
这条路径没有错。问题在于,专业工作本身不是一堆静态文档。
一个项目里的信息会持续变化:
- 谁负责这件事;
- 哪个客户在什么时间提出了什么要求;
- 专家为什么接受 A 方案,而不是 B 方案;
- 某个判断后来被什么证据推翻;
- 现在真正有效的状态是什么。
如果记忆只回答“过去说过什么”,它更像搜索。
长期工作的 Agent 还需要理解“过去如何演变成现在”。
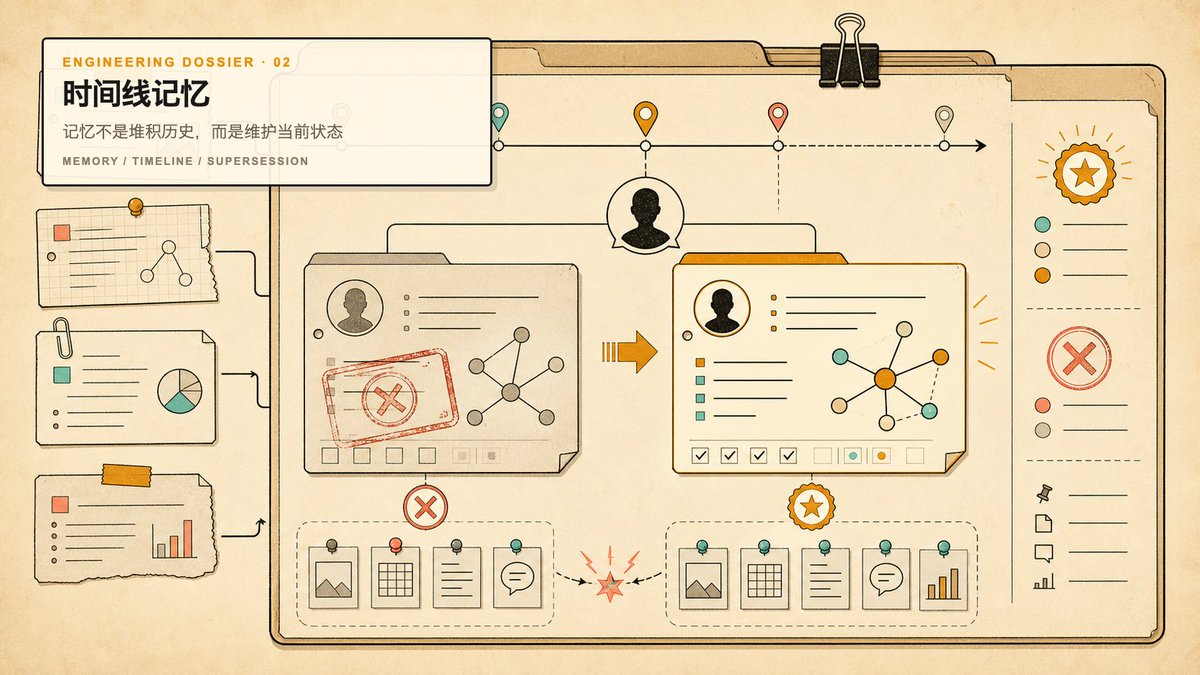
Alloomi 的 Holistic Context 技术报告,走的就是这条路线。它把跨会话、跨平台的片段,按照人物、项目、任务、渠道和有效时间组织成实体时间线,同时保留来源、冲突和被替代的关系。
这里有一个很关键的变化:旧事实不是简单删除,而是被标记为已经失效,并保留它为什么被替代的证据。系统还可以回看某个时间点上,它当时相信的是什么。
这和“把所有历史都存下来”是两回事。
前者维护的是一个会变化的工作世界,后者只是堆积了一批记录。
https://alloomi.ai/reports/hc.pdf10M 测的不是窗口大小,而是能不能继续工作
这也是为什么我现在不太会只看一个模型的上下文窗口有多大。
128K 能放下一份很长的文档,但真实工作可能持续几个月甚至几年。客户开过几十次会,项目积累了几百个文件,关键判断散落在邮件、即时通讯、任务系统和交付物里。新的信息还会不断补充,甚至推翻旧结论。
真正的问题是:历史规模变大以后,Agent 还能不能找到关键线索,分清当前状态和过期状态,并把几个月前的决策带到今天的任务里。
在 Holistic Context 报告披露的 BEAM 结果中,128K、500K、1M 和 10M tokens 下的 nugget pass rate 分别是 72.8%、75.7%、76.5% 和 67.0%。从 128K 到 10M,历史规模扩大约 78 倍,10M 时仍保留了 128K 结果约 92% 的水平;10M 这一点对比 Hindsight 的 64.1%,Alloomi 为 67.0%。
这个数字不能被简单理解成“全面碾压其他方案”。报告自己也注明,这是一组单 seed、单 backbone 的可行性结果,跨论文对比并不是严格控制的 head-to-head 实验。
但它说明了一个值得关注的方向:长期记忆的竞争,不只是让窗口变长,而是让历史变得可组织、可追溯、可更新。
看见经验,不等于学会经验
到这里,Agent 还只是拥有更好的外部记忆。
它能看见完整的工作历史,但不代表模型本身已经学会了下一次该怎么做。
我之前写 Agent 记忆时,用过一条链路来描述这个过程:
trace → policy → skill
先记录发生了什么,再提炼行为策略,最后沉淀成下一次可以调用的技能。
现在我会在这条链路后面再加一层:
experience → evaluation → deployment
经验必须经过评估,确认真的改善了行为,才应该回到部署中的 Agent。
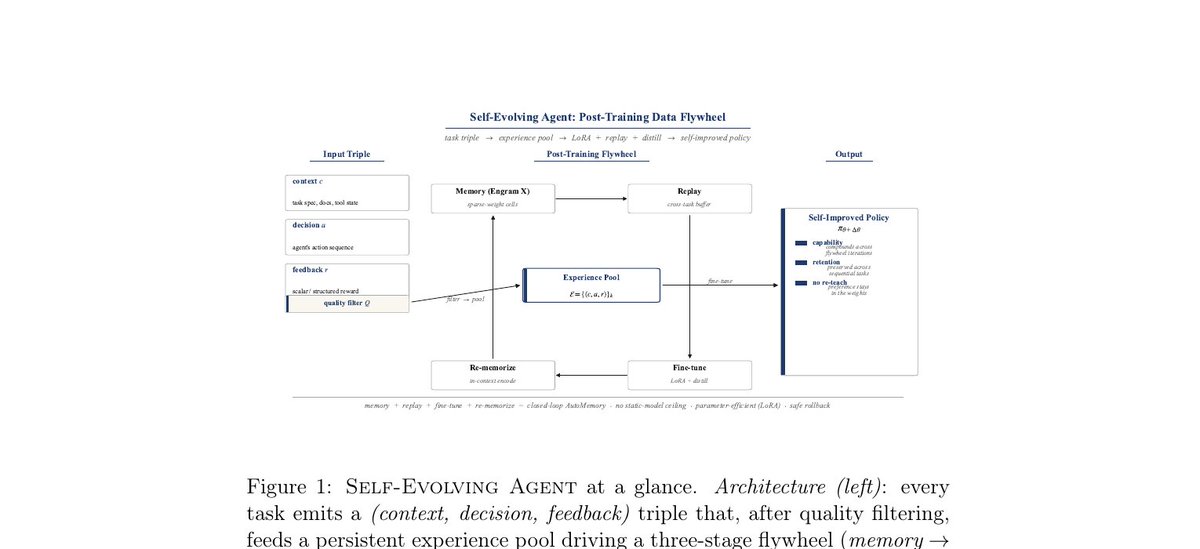
Alloomi 的 Self-Evolving Agent 报告把一次任务表示成三元组:上下文、决策和反馈。只有经过质量筛选,经验才会进入经验池,然后通过三段式飞轮继续训练:LoRA 更新、跨任务经验回放,以及更强教师模型的能力蒸馏。
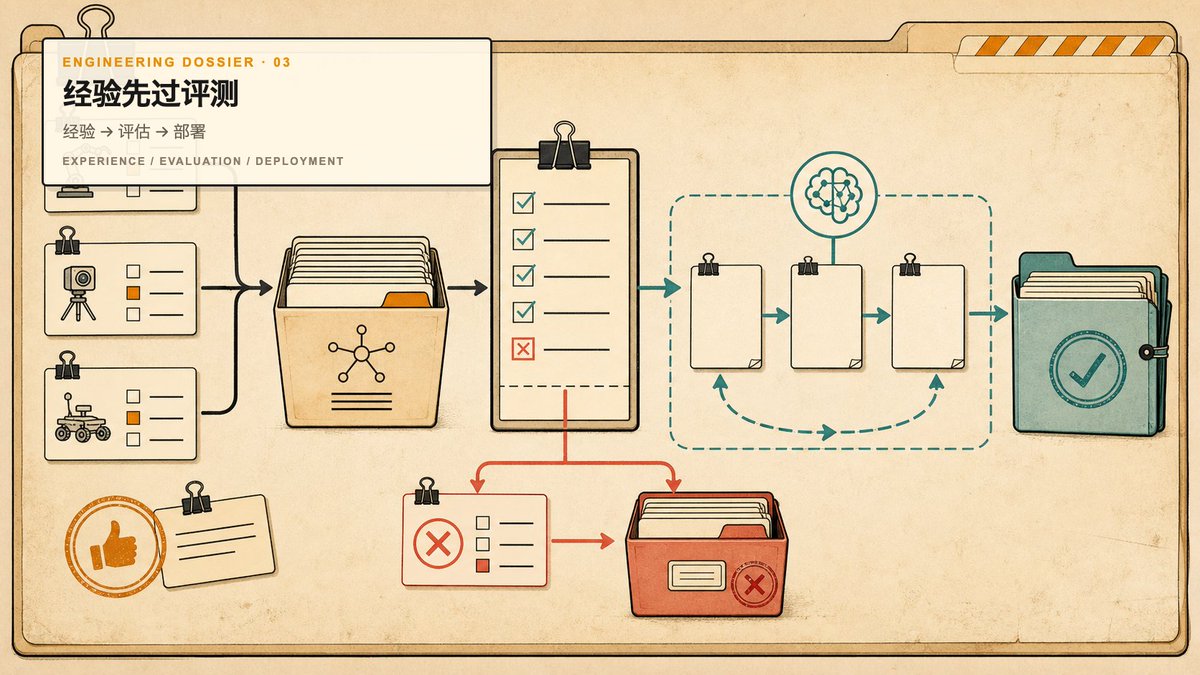
这和“每完成一次任务,模型立刻自己改写自己”差别很大。
后者听起来更像科幻,前者才更接近能被企业接受的工程系统。一次交付里可能有错误,也可能有不完整的反馈。如果每个结果都直接写回模型,错误会和经验一起积累。
所以,真正有价值的不是让 Agent 学得更快,而是先判断什么值得学。
在固定模型骨干的对照实验中,Self-Evolving Agent-mini 在 CL-Bench 上从 24.5% 提升到 47.6%,提升了 23.1 个百分点。10-task retention suite 上,它的平均结果是 51.3%,同骨干的 no-replay 对照是 33.6%;品牌 benchmark 总览则以 GPT 5.6 Sol 的 21.5% 作为 CL-Bench 公开对照。

这里最值得看的不是一个排行榜名次,而是实验问题本身:固定同一个 backbone,加入经验回放、后训练和教师蒸馏之后,Agent 是否真的比原来更会做连续任务。
自进化的最后一公里,是治理
我对“自进化 Agent”最先想到的,并不是它能不能自己变强,而是它变差之后怎么办。
这和我之前写 Harness Engineering 时的判断是一致的:Agent 的自主权更像信用额度,不是打开一个开关就自动获得的。它要用可验证的结果,慢慢挣到更多权限。
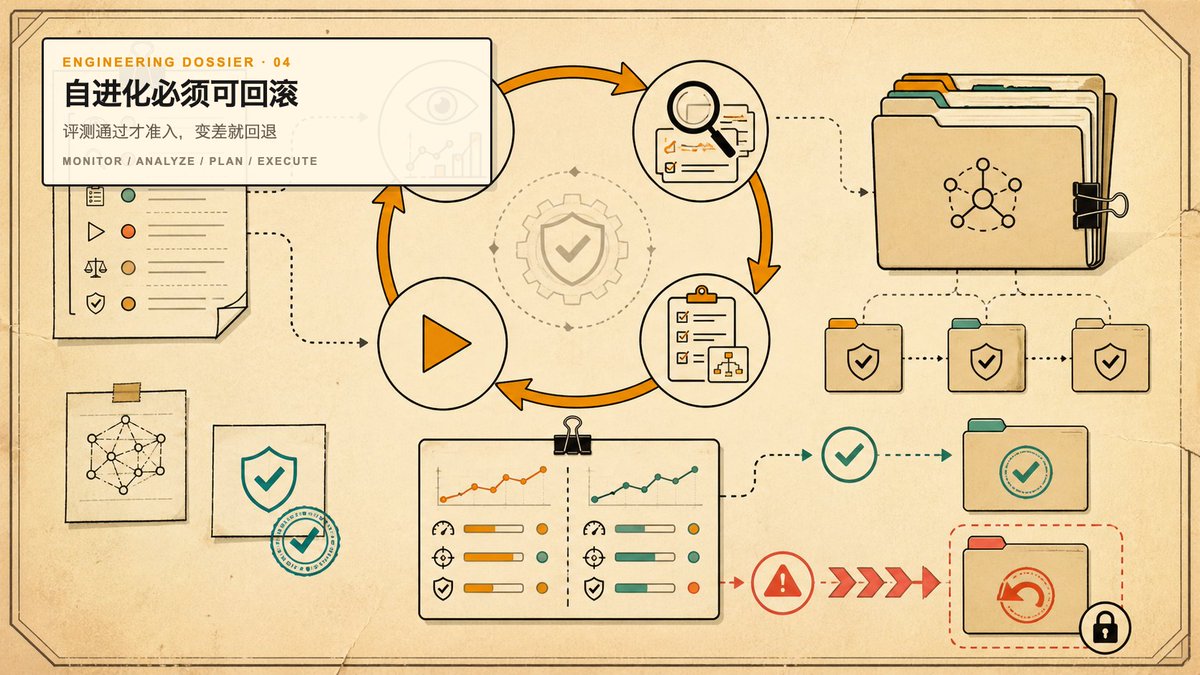
Self-Evolving Agent 里有一套 MAPE 控制循环:Monitor、Analyze、Plan、Execute。模型更新前后,会看 reward、calibration error 和 reasoning trace consistency 等指标,再决定这次版本是否准入。
如果结果变差,就需要回滚,而不是继续相信“它正在学习”。
这里也有一个我认为必须保留的限制:报告把这套机制描述为在 20 次 burn-in 中具备经验性的 rollback tolerance,但明确没有宣称正式的单调提升保证。因为真实部署中的验证分布会变化,实验无法证明模型以后每一次更新都一定变好。
这种保留边界的写法,反而比“模型会持续自我进化”更让我信服。
自进化不是放弃控制,而是把学习、评测、准入和回退做成一个闭环。
从记得住,到学得会,再到做得成
前面讲的主要是第一层和第二层:让 Agent 看见完整历史,再把筛选过的经验变成能力。
但这条技术路线的终点,不是记忆本身,也不是训练曲线,而是能不能把学到的东西变成真实工作的交付。
我现在会把它分成三层。
下面的 benchmark 数字按品牌公开技术资料整理,具体评测协议和限制以对应报告及数据页为准。
第一层:记得住
这里测的不是能不能复述一段文本,而是跨会话、时间变化、多跳关系和超长历史下,能不能找到当前有效事实。
- LoCoMo-V2:97.4%,对比 Mem0-V3 的 92.5%,高 4.9 个百分点。它主要测跨会话问答、时间关系理解和多跳推理。
- LongMemEval-S:97.6%,对比 Mem0-V3 的 94.4%,高 3.2 个百分点。它主要测长期信息提取、知识更新和多会话综合推理,公开人类参考为 82.9%。
- BEAM 10M:67.0%,对比 Hindsight 的 64.1%,高 2.9 个百分点。它测的是千万 Token 历史规模下的全局任务理解和信息定位。
这里的“对比”要谨慎读。不同 benchmark 的模型、评测协议和数据规模并不完全相同,Holistic Context 报告也把这些结果定位为单 seed、单 backbone 的可行性示范,而不是严格横向排名。
第二层:学得会
记忆让 Agent 找回过去,持续学习则要让过去的经验改变后续行为。
- CL-Bench:47.6%,对比 GPT 5.6 Sol 的 21.5%,高 26.1 个百分点。它测从复杂上下文中学习新知识、新规则,并把规则用于后续执行的能力。Self-Evolving Agent 报告里还有一个同骨干内部对照:FewShot 从 24.5% 提升到 47.6%。这两个对照对象不能混写。
- CL-Bench-Life:32.1%,对比 GPT-5.5(High)的 22.2%,高 9.9 个百分点。它把任务拉到多会话、长周期场景,测经验能不能跨阶段迁移。
- Con.L Bench(技术报告中写作 Cont.L.Bench):32.6%,对比 Claude Sonnet 4.6 的 22.3%,高 10.3 个百分点。它测跨任务持续学习、环境适应和抗遗忘能力。
这三项放在一起看,比单独看 CL-Bench 更有意义。任务从单次上下文学习延伸到跨会话和跨任务后,优势会收窄,但仍然存在。真正的问题也从“能不能学会”变成了“学会之后能不能保持”。
第三层:做得成
最后要看的,是学到的能力能不能变成专业交付,而不是只在记忆或学习 benchmark 上得分。
- GDPval-AA Normalized:74.2%,对比 Claude Opus 5 的 67.9%,高 6.3 个百分点。它覆盖 44 类职业的高经济价值任务,测真实专业任务的完成质量。
- JobBench:57.5%,对比 Muse Spark 1.1 的 54.7%,高 2.8 个百分点。它测真实职业任务、复杂工作流程和专业结果交付。
- SWE-Bench-CL:80.6%,对比 OpenCode + Kimi K3 + FAISS 的 73.3%,高 7.3 个百分点。它测真实 GitHub 问题修复,以及连续软件工程任务中的经验迁移和抗遗忘。
这三层不是三个互相独立的宣传词,而是一条工程链:
真实任务轨迹 → 质量筛选 → 专家锚定 → 后训练 → 评测准入 → 版本回滚
第一层让系统知道工作世界现在是什么样,第二层让它从交付经验里学会新的做法,第三层验证这些做法有没有真正改善结果。三层串起来,才是“让 AI 每完成一次交付,就获得一次成长”。
我现在会怎样评估一个数字员工
如果只看第一次 Demo,几乎所有 Agent 都可以显得很聪明。
我更想问下面三个问题:
- 第二次做同类任务时,它有没有比第一次少犯同样的错?
- 它能不能解释当前状态,以及旧判断为什么被替代?
- 这次更新如果让结果变差,系统里有没有明确的回滚路径?
这三个问题,分别对应三种能力:经验迁移、状态理解和受控进化。
Alloomi 现在的技术叙事,真正有意思的地方也在这里。它不是只给 Agent 增加一个聊天入口,而是把“连接工作上下文、完成真实交付、吸收专家反馈、改进下一次能力”串成一个循环。
Holistic Context 负责让系统知道工作世界现在是什么样,Self-Evolving Agent 负责把经过筛选的交付经验带回模型能力,OpenContext 则把上下文图谱、记忆 API、检索和 Agent runtime 做成可以嵌入其他应用的开源底座。
这几层合在一起,才更接近“数字员工”这个词应该表达的东西。
我现在会把 Agent 的长期能力分成三层:
第一层,找回发生过什么,并理解什么仍然有效。
第二层,把被筛选和评测过的经验带回模型能力。
第三层,让能力改善下一次真实交付,同时保留评测和回退能力。
终点不是让 Agent 知道更多过去,而是让它下一次做得更好。
如果一个系统只会召回更多历史,它拥有的是更大的档案库。如果它会更新自己,却不能解释变化、接受评测和安全回退,那更像自我修改,还称不上可靠学习。
想继续看这条路线,可以从 @AlloomiAI 的两份公开技术报告开始:
- Holistic Context 技术报告
- Self-Evolving Agent 技术报告
对我来说,这次阅读和实测最大的收获不是又认识了一个“有长期记忆”的 Agent,而是把过去关于记忆的判断往前推进了一步:
记住,不等于学会。学会,也不等于可以放心上线。
我是Yanhua,持续关注AI Agent,出海,关注我--> @yanhua1010