
MiniMax H3 双 4090 本地部署实操教程
MiniMax H3 开源了视频生成模型,支持文生视频、图生视频、音画联合生成。云端 API 按量付费,跑一条 10 秒视频几毛到几块钱,量一上来账单很吓人。自己有双卡 4090 的话,把推理搬到本地是更划算的选择。
这篇教程记录的是我在 Windows 宿主 + Linux Docker 容器上,用双 RTX 4090(48GB)跑通 H3 I2VA(图生视频+音频)的完整过程。所有配置和数据都经过 2026 年 8 月 13 日的实机验证。
此篇由Claude Opus4.6,读取所有正确的操作记录后撰写。
为什么要本地跑
三个直接的理由。
成本。云端 API 每条视频几毛到几块,做内容的人一天可能要出几十条候选。本地部署的边际成本只有电费,双 4090 满载功耗大约 900W,跑一条 10 秒视频不到两分钟,折合电费几分钱。
隐私。商业项目的分镜、首帧、角色设计全部在本地流转,不经过任何第三方服务器。对于还没公布的产品、还没签完合同的客户素材,这一点没有替代方案。
可控性。本地环境可以锁定 ComfyUI 版本、节点版本、模型权重的 SHA-256,做到"同输入同输出"的确定性复现。云端 API 的后端版本更新你控制不了,上周能跑的提示词这周可能出完全不同的画面。
双 GPU 架构
H3 的推理链里有一个 32B 参数的 Qwen3-VL CLIP 文本编码器,单这一个模型就吃掉大量显存。如果和扩散模型挤在同一张卡上,显存不够用,要么 OOM 要么频繁换入换出,速度崩盘。
双卡的分工方案很直接。
GPU0 干计算密集的活,GPU1 只负责文本编码,加载一次之后就待命。这样两张卡各自的显存压力都在可控范围内。
实现这个分工需要一个自定义 ComfyUI 节点 H3CLIPLoaderGPU1,后面会详细说。
宿主机目录布局
所有模型权重、入口脚本、自定义节点都放在宿主机上,通过 Docker 挂载进容器。这样容器可以随时重建,不丢任何数据。
E:\minimax-h3\ ├── models\ │ ├── diffusion_models\ │ ├── text_encoders\ │ ├── vae\ │ ├── loras\ │ └── output\ └── scripts\ ├── entrypoint.sh ├── comfyui_mcp_server.py ├── mcp-requirements.txt └── ComfyUI-H3-GPU1\__init__.py
models/ 下面按 ComfyUI 的标准子目录组织权重文件,output/ 存生成结果。scripts/ 放入口脚本和自定义节点代码,容器启动时自动软链接到 ComfyUI 的 custom_nodes 目录。
几十 GB 的权重文件不要放进 Docker 镜像层,否则每次构建镜像都要重新打包,镜像体积也会膨胀到不可维护。
模型文件清单
已验证可用的 FL2VA / I2VA 模型组合(FL2VA 路径同时覆盖 T2VA、I2VA、L2VA 模式)。
ffmpeg -y -v error -i output.mp4 \
  -vf "select='eq(n,0)+eq(n,60)+eq(n,123)',scale=640:360,tile=3x1" \
  -frames:v 1 contact.jpg
几个注意点。
扩散模型用的是 INT8 量化版(pruned_int8_convrot),双 4090 能装下。CLIP 是 NVFP4 AWQ 量化,32B 参数量化后约 16GB 显存占用。
Turbo LoRA(turbo_v4_step600_ema)能把采样步数从几十步降到 4-8 步,速度提升巨大,是生产链的必选项。
真人 LoRA(h3-realism-people-t2v-i2v-r2v)可选。触发词是 r34l1sm,建议强度从 0.6-0.8 开始 A/B 测试,1.0 是上游设计强度但不是每个镜头都适合。
模式和权重必须匹配。T2VA、I2VA、FL2VA、L2VA 都走 FL2VA 权重路径。Ref2VA 有独立的权重和工作流,不能混用。
Docker 容器创建
基础镜像用 NVIDIA CUDA 12.8 系列,容器内需要 ComfyUI 0.32.0、PyTorch 2.11.0+cu130、torchaudio 2.11.0+cu130。
torch 和 torchaudio 的版本号以及 CUDA 构建标签必须完全一致,这是音频解码能不能跑通的硬性条件。
PowerShell 创建容器的完整命令。
docker run -d ` --name comfyui-h3 ` --gpus all ` --restart unless-stopped ` -p 16888:8188 ` -p 16889:16789 ` -v "E:\minimax-h3\models:/models" ` -v "E:\minimax-h3\scripts:/scripts" ` --entrypoint /scripts/entrypoint.sh ` comfyui-h3:reproducible
端口映射说明。16888 是 ComfyUI Web UI 和 API 的访问端口,映射到容器内 8188。16889 是 MCP 控制层端口(如果不需要 Agent 调用可以去掉)。
两个 -v 挂载把宿主机的模型目录和脚本目录映射进容器。--entrypoint 指定入口脚本,容器启动时自动执行环境恢复和服务启动。
长期生产环境建议用 Dockerfile 固定所有依赖版本,而不是 docker commit 保存调试状态。一个最小 Dockerfile 的骨架长这样。
diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors
text_encoders/qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
vae/minimax_h3_video_vae_fp16.safetensors
vae/minimax_h3_audio_vae_fp32.safetensors
loras/minimax_h3_turbo_v4_step600_ema.safetensors
loras/h3-realism-people-t2v-i2v-r2v.safetensors   # 可选,真人 LoRA
构建时通过 --build-arg 传入 PyTorch 版本和索引 URL。
启动验收
容器跑起来之后,不要直接提交长视频生成任务。按顺序跑下面几条 curl 命令验证环境是否正常。
# 检查系统状态,确认两张 GPU 都可见 curl http://YOUR_HOST:16888/system_stats # 检查队列接口是否响应 curl http://YOUR_HOST:16888/queue # 验证 GPU1 CLIP 加载器节点已注册 curl http://YOUR_HOST:16888/object_info/H3CLIPLoaderGPU1 # 验证 T8 采样器节点 curl http://YOUR_HOST:16888/object_info/MiniMaxH3DualClockSamplerT8 # 验证 T8 音画解码节点 curl http://YOUR_HOST:16888/object_info/MiniMaxH3AVDecodeT8
通过标准。
- system_stats 返回 JSON 里能看到两张 GPU 的名称和显存信息
- queue 返回空队列,接口正常响应
- 三个 object_info 都返回完整的节点 schema(输入参数定义),没有 404
如果 object_info 返回 404,去看容器启动日志里有没有 ImportError。大概率是某个自定义节点的依赖没装好或者软链接断了。
第一次提交生成任务时,CLIP 会做一次冷加载(加载 32B 量化权重到 GPU1),这次会比较慢。后续的任务走热缓存,速度正常。性能对比必须拿热缓存对热缓存,拿冷启动比不公平。
已验证推理链
从模型加载到视频保存的完整节点链。
GPU0(cuda:0)
  扩散模型(UNet / DiT)
  VAE 编解码
  音画联合采样(T8 sampler)

GPU1(cuda:1)
  常驻 Qwen3-VL 32B CLIP(NVFP4 量化)
  加载后不卸载,热缓存常驻
两种采样配置,按用途选择。
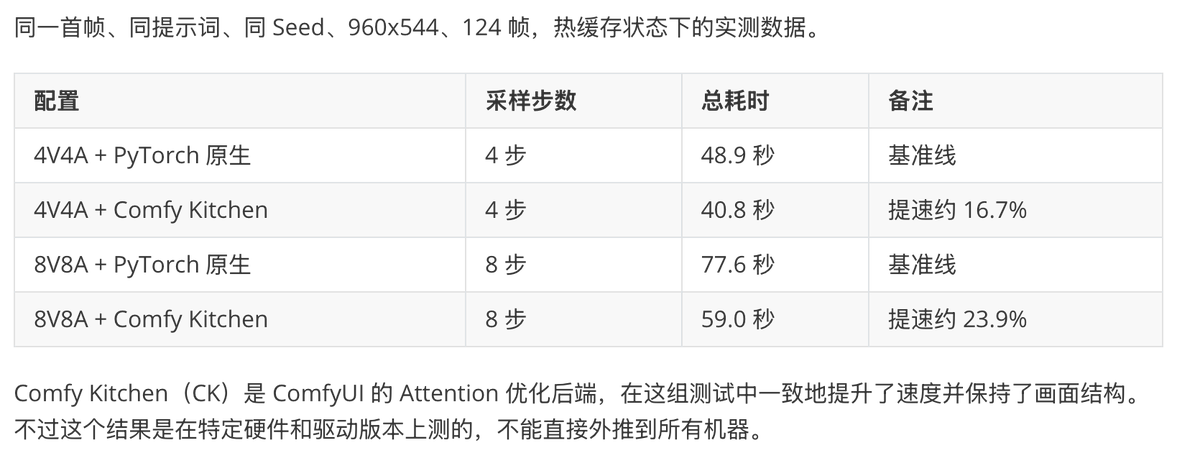
预览(4V4A)。用 MiniMaxH3DualClockSamplerT8,4 步采样,shift_video=12,shift_audio=3,调度器 dual_clock_euler,噪声类型 native_flow。一条 960x544、124 帧的视频热缓存大约 49 秒(PyTorch 原生)或 41 秒(Comfy Kitchen 加速)。
正式候选(8V8A)。用 MiniMaxH3MultiRateSamplerEXPT8,8 步视频 + 8 步音频,位移参数同上。热缓存大约 78 秒(PyTorch)或 59 秒(CK 加速)。
一个重要的教训。不要给 Turbo 四步采样再接一套外部六步调度器,T8 节点内部已经包含了 model、sampler 和 sigmas 的完整配置,外挂调度器只会制造冲突。
8V8A 也不是无条件优于 4V4A。实测中真人哭戏 A/B 对比,4V4A 生成了更克制的单泪轨效果,8V8A 反而出现了不自然的双泪轨。正确做法是同素材、同提示词、同 Seed 做候选,人工验收选择。
速度实测
FROM nvidia/cuda:12.8.1-cudnn-devel-ubuntu22.04

ARG DEBIAN_FRONTEND=noninteractive
RUN apt-get update && apt-get install -y --no-install-recommends \
      python3 python3-pip python3-venv git ffmpeg curl ca-certificates \
    && rm -rf /var/lib/apt/lists/*

WORKDIR /app/ComfyUI
COPY ComfyUI-pinned.tar.gz /tmp/ComfyUI.tar.gz
RUN tar -xzf /tmp/ComfyUI.tar.gz -C /app/ComfyUI --strip-components=1 \
    && rm /tmp/ComfyUI.tar.gz \
    && python3 -m pip install --no-cache-dir -r requirements.txt

ARG TORCH_VERSION
ARG TORCHAUDIO_VERSION
ARG TORCH_INDEX_URL
RUN test -n "$TORCH_VERSION" \
    && test -n "$TORCHAUDIO_VERSION" \
    && test -n "$TORCH_INDEX_URL" \
    && python3 -m pip install --no-cache-dir --index-url "$TORCH_INDEX_URL" \
         "torch==$TORCH_VERSION" "torchaudio==$TORCHAUDIO_VERSION"

RUN mkdir -p /models/diffusion_models /models/text_encoders \
    /models/vae /models/loras /models/output

EXPOSE 8188 16789
CMD ["python3", "main.py", "--listen", "0.0.0.0", "--port", "8188", \
     "--disable-auto-launch"]
分辨率、帧数和音频
几个容易踩坑的细节。
分辨率。宽和高必须都是 32 的倍数。16x9 横屏的推荐生成分辨率是 960x544(不是 960x540)。如果最终交付需要标准 540p,生成后用 ffmpeg 裁掉上下各 2 像素。
ffmpeg -i input.mp4 -vf "crop=960:540:0:2" -c:a copy output_540p.mp4
帧数。常见的可用帧数按 17k+5 公式规划,比如 124 帧(k=7)、141 帧(k=8)、175 帧(k=10)。124 帧在 24fps 下约 5.2 秒。
有个已知现象。T8 的 "240 长度配置" 实测解码出来是 243 帧,即 24fps 下 10.125 秒。在项目文档和时间轴计划里应该同时记录请求帧数和实际 ffprobe 输出帧数,不要假设它们一定相等。
音频。H3 原生音频是 32kHz 双声道。这个参数和大多数视频编辑软件默认的 48kHz 不同,后期处理时注意重采样的时机和方式。
最小生成验证流程
每次改动环境配置后,先跑一个短的 I2VA 生成做验证。检查这五项。
- 首帧构图和人物身份是否保留(有没有崩脸、变形、丢了关键元素)
- 中间帧的肢体、面部、比例、局部主体是否稳定
- 尾帧是否停在合理的动作边界(而不是随机截断)
- 音轨是否存在、有没有爆音、有没有出现意料之外的 BGM
- 提示词、Seed、模型、LoRA、采样配置、Prompt ID、输出路径全部记录到清单
用 ffmpeg 快速做 contact sheet 目视检查。
UNETLoader
  -> ModelAttentionBackend("comfy kitchen attention")
  -> LoraLoaderModelOnly(真人 LoRA, 可选)
  -> MiniMaxH3TurboLoRA
  -> MiniMaxH3ImageToVideo
  -> MiniMaxH3PreflightT8
  -> T8 sampler
  -> BasicGuider + RandomNoise + SamplerCustomAdvanced
  -> MiniMaxH3AVDecodeT8
  -> CreateVideo + SaveVideo
这条命令抽取第 0、60、123 帧(对应首、中、尾),拼成一行用于快速目视。
复现清单
"跑通过一次"和"可复现"是两回事。要做到可复现,每次冻结环境时需要记录以下全部信息。
- Docker 镜像 tag 和 digest(docker inspect 的 SHA-256)
- ComfyUI 源码的 Git 提交哈希
- 每个自定义节点插件目录的 Git 提交哈希(如果有 .git)或目录的 SHA-256 清单
- Python 依赖冻结清单(pip freeze)
- 模型文件的 SHA-256(每个 .safetensors)
- GPU 型号和驱动版本
- 工作流 JSON 文件
- 提示词全文
- 输入图片的文件哈希
- Seed 值
- 采样档位(4V4A / 8V8A、步数、shift 参数)
- 请求帧数 vs 实际输出帧数(ffprobe 验证)
- 输出视频文件的 SHA-256
- 导演/验收结论
生产链必需节点
跑通 H3 I2VA 的完整推理链至少需要以下 ComfyUI 节点。
MiniMaxH3ImageToVideo MiniMaxH3TurboLoRA MiniMaxH3PreflightT8 MiniMaxH3DualClockSamplerT8 MiniMaxH3MultiRateSamplerEXPT8 MiniMaxH3AVDecodeT8 ModelAttentionBackend H3CLIPLoaderGPU1(本教程提供的自定义节点)
前六个来自 H3 和 Turbo/T8 相关的第三方 ComfyUI 插件。由于这些节点目录在实测环境中没有完整可追溯的 Git remote 和 commit 记录,这里不编造安装 URL。第一次搭建时从维护者或已有可用环境获取经过许可的节点目录,对目录做 SHA-256 清单存档。后续用这个清单验证一致性。
官方 MiniMax-H3 GitHub 仓库(MiniMax-AI/MiniMax-H3)提供的是模型权重、提示词指南和参考代码,和这些第三方 ComfyUI 节点插件不是同一个来源,不要混淆
插件更新前先备份整个 custom_nodes 目录。不要同时装多个优化插件(Cache、CK、Sage、Sol 等)然后统一评估收益,一次只加一个,单独测完再决定保留。