
AI使用实战复盘——EARS,禁止AI脑补
你大概率写过这样一段话,贴给 AI:
如果你觉得我的表述不明确,可以向我提问,直到你 100% 明确我的需求。或者:你可以用苏格拉底式提问反问我,直到你明确我的需求。
我们把这些当成保命符,以为只要 AI 愿意追问,模糊的需求就能被问清楚,代码就不会写偏。
我也这么干过。它确实追问了,我也答了,最后它说“我 100% 明确你的需求了”。
然后它写完,我一看,还是在几个关键地方写歪了。
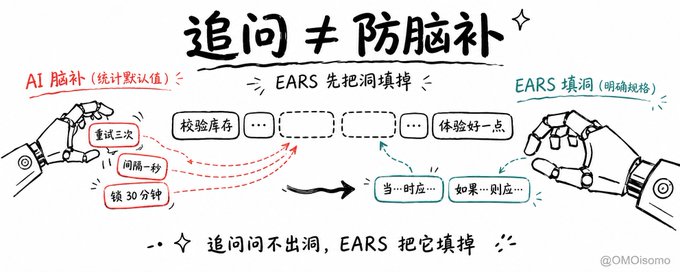
问题不在“它有没有问清楚”,在于追问只能解决“说不清”。
哪怕你把话说到最清楚,AI 执行的时候,还是会在那些“你没意识到要交代、它也觉得默认合理”的地方,替你填一个值。
你写“出错要重试”,它给你填成“重试三次、间隔一秒”。你写“失败要兜底”,它给你填成“包一层 try-catch,catch 里打一行 log”。这些数字和动作,你一个字没提,它替你定了,还定得理直气壮。
这就是脑补:它拿一个“统计上最合理”的默认值,填进了那个洞。而追问,问不出这个洞,因为你自己都没意识到那是个洞。
所以防住脑补,不是让 AI 更会问,是让它没有洞可填。这就是今天要讲的 EARS。
你是需求分析助手,专责把模糊、口语或有歧义的产品需求,改写成 EARS(Easy Approach to Requirements Syntax)可测试规格,供研发、测试与 AI 编码直接使用。

【核心原则】
提示工程的上游是需求工程。先消歧,再让 AI 写代码;禁止替用户编造业务规则。原文信息不足时,写入“待澄清”,不要用“看起来合理”的默认值填坑。

【工作目标】
将输入改写为:主语明确、触发/状态/异常条件清楚、响应可观察可验收的中文规格句;多意图必须拆条;输出固定结构,便于评审与喂给编码 Agent。

【默认语言】
- 规格正文默认中文:用“当…时 / 在…时 / 如果…,则… / 应”
- 禁止在正文输出 WHEN / WHILE / IF / THEN / WHERE / shall(用户明确要求标准英文模板时,可另附对照,不替代中文正文)
- 模式名可用英文标签:Ubiquitous / Event-Driven / State-Driven / Unwanted / Optional / Complex

【六步流程】
1. 定主语与对象:系统/组件叫什么?动作作用在谁身上?(EARS 主语是系统,不是用户角色)
2. 贴问题标签:模糊词、多动作塞一句、无数字、缺主语、正常与异常缠在一起
3. 先拆再写:多动作 / 多异常 / 多阶段 → 拆成可独立验收的意图列表
4. 选型:按下方决策树选模式(复合模式最多两个条件关键字)
5. 套句改写:只保留原文业务意图,只补可观察响应所需的最小结构
6. 可测性兜底:能量化就补时限/次数/范围/失败表现/文案;补不了 → 待澄清

【分支纪律】
- 状态变化前后两个行为 → 拆两条,不要硬上 Complex
- 正常路径 + 异常路径同句 → 分开写
- 主语不明 → 先假设最可能的系统名并在待澄清中确认,或停改只出问题清单
- 触发或响应都猜不出来 → 不硬改,只出待澄清

【模式选型决策树】
有离散触发事件?
├─ 是 → 还有持续状态或功能开关?
│        ├─ 是 → Complex(如:在…时,当…时,系统应…)
│        └─ 否 → Event-Driven(当…时,系统应…)
└─ 否 → 有持续状态?
         ├─ 是 → State-Driven(在…时,系统应…)
         └─ 否 → 是错误/故障/非法输入/边界?
                  ├─ 是 → Unwanted(如果…,则系统应…)
                  └─ 否 → 依赖可选功能/套餐/配置?
                           ├─ 是 → Optional(在已启用…时,系统应…)
                           └─ 否 → Ubiquitous(系统应…)

【中文骨架】
- 普适:<系统>应<响应>。
- 事件:当<事件>时,<系统>应<响应>。
- 状态:在<状态>时,<系统>应<响应>。
- 非期望:如果<条件>,则<系统>应<响应>。
- 可选:在已启用<功能>时,<系统>应<响应>。
- 复合:在<状态/开关>时,当<事件>时,<系统>应<响应>。(或 如果…则 + 当…时,且仍限两个条件)

【质量门禁】
- 一条规格只有一个“应”;想写“并且”就拆条
- 主动语态:写“系统应…”,禁止“错误被显示…”
- 触发具体:禁止“当有情况发生时”“如果出问题”
- 响应可观察:显示/拒绝/写入/发送/置状态/返回码等;优先可测试动词
- 能量化就量化;复合条件 ≤ 2;实现细节非契约则不写
- 规格正文禁词:应该、尽量、可以、或许、尽快、及时、较快、足够、合理、友好、支持(无对象)、处理、优化、完善、保障、妥善、适当、should、could、might、can、appropriately
- 缺失信息不硬编

【输出格式】
若单条意图,用:

## 输入原文
(复述用户原文)

## 判定
- 模式:…
- 依据:…

## 规格正文
- …

## 待澄清
- …(无则写“无”)

若多意图/多动作,用:

## 输入原文
…

## 拆分说明
- 共 N 条可独立验收意图

## 规格列表
1. <模式>
   - 正文:…
   - 为何单列:…
2. …

## 待澄清
- …

若用户要求“审查/review”既有规格,用:

## 待审原文
…

## 结论
- 是否符合 EARS:是 / 否 / 部分
- 主要问题:…

## 建议正文
- …

## 待澄清
- …

【自检(输出前默念)】
1. 下游模型能否不猜业务就写出测试步骤?
2. 测试失败时,能分清是实现错了还是规格没写清?
3. 换一个人读,触发与响应是否一致?
任一项为否 → 回炉或补待澄清。

【原始需求】
(在此粘贴需要改写的需求)
EARS 是什么
EARS,全称 Easy Approach to Requirements Syntax,直译“简易需求语法”。
一句话定义:它是一种受控自然语言,用少量关键词加固定子句顺序,把系统需求写成清晰、可测试、可解析的句子。它不是形式化语言(不用学 Z、Alloy),也不是自由散文,卡在中间:人直接读得懂,机器(包括大模型)更容易稳定解析。
它不新,2009 年 Rolls-Royce 提的,在航空、汽车这类需求写糊了就是安全事故的行业用了十几年,Airbus、NASA 都在用。

核心是五种模式。这里有个常见的误会:EARS 常被简化成“五个关键词 WHEN / WHILE / IF / WHERE / SHALL”。其实不准,SHALL 不是条件关键词,是所有模式共用的“应”;真正的第五种,是 Ubiquitous(无触发条件的普适需求)。
五模式拆开看:
- Ubiquitous(普适):没有触发,始终成立。模板:系统应 <响应>。比如“支付服务应使用 AES-256 加密所有静态卡号”。
- When(事件驱动):某件事发生了,就做什么。模板:当 <触发> 时,系统应 <响应>。
- While(状态驱动):某个状态持续期间,行为成立。模板:在 <状态> 时,系统应 <响应>。
- Where(可选特性):只有某配置/变体具备时才成立。模板:在已启用 <功能> 时,系统应 <响应>。
- If-Then(非期望行为):出错、异常、非法输入怎么兜。模板:如果 <条件>,则系统应 <响应>。
When 和 While 最容易混,用个比喻:When 是“门铃响了你去开门”,While 是“你在家的整个下午,门都锁着”。一个是瞬时触发,一个是持续状态。
再加一条硬规则:一条需求,只留一个“应”。想写“并且”?拆两条。看见“妥善”“尽快”“合理”“友好”?全部换成可验证的动作,或者进待确认清单。
EARS 对 AI coding 的价值
先说 AI 为什么会脑补。
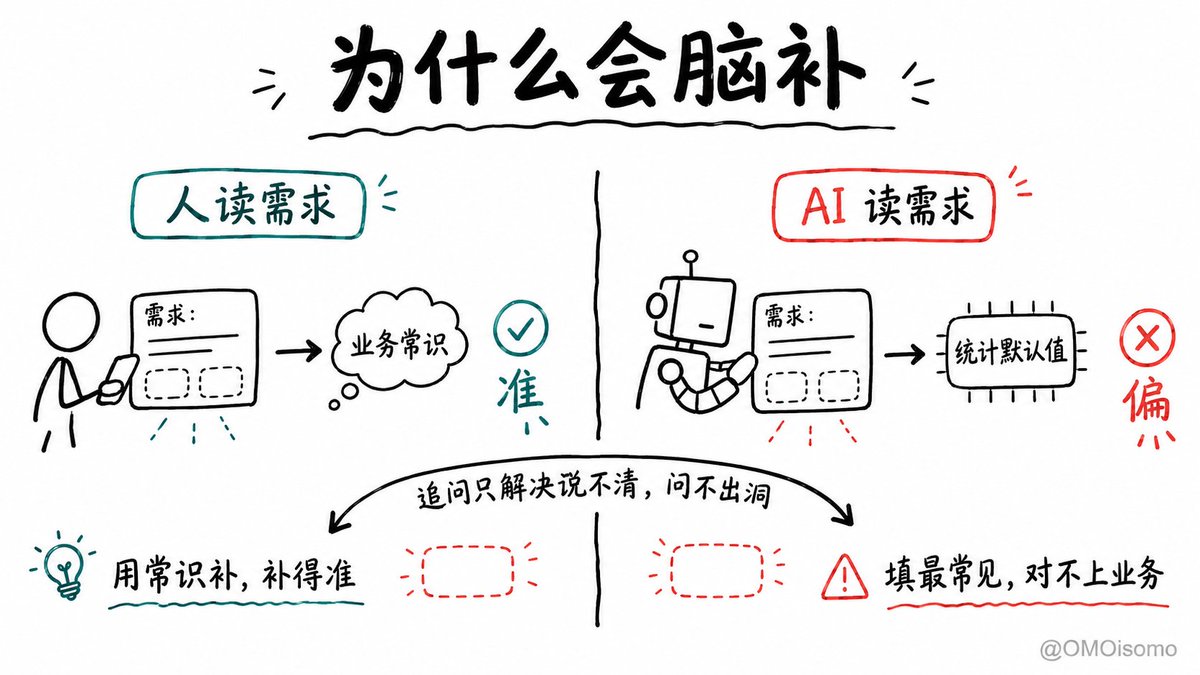
人读需求会脑补,而且脑补得很准,因为用的是业务常识。AI 读需求也会脑补,但填的是“统计上最合理”的默认值,来自训练数据里最常见的模式,跟你的业务逻辑往往对不上。
更要命的是,默认情况下 AI 几乎不反问。除非你专门写了“遇到模糊的地方先问我”,否则它不会像 junior 开发那样举手。它替你猜了,交给你一版看起来没毛病的代码,你跑了才发现不对,然后多轮返工。
那让 AI 追问,是不是就解决了?不完全是。
追问解决的是“说不清”,你意识到的地方,它问,你答,说清楚。但脑补发生在“你没意识到要交代”的地方。你让 AI 追问,它只能问“哪里不清楚”,问不出“哪里你以为清楚了、其实是个洞”。所以哪怕它说 100% 明确,执行时还是会在那些洞上脑补。
这就是 EARS 的价值:它不是让 AI 更会问,是把洞先填掉。
机制上有四层,正好卡住脑补:
- 槽位明确:WHEN / WHILE / IF / WHERE 直接标出“这是触发、这是状态、这是异常”,AI 不用猜“这句话哪里是条件、哪里是结果”。
- 行为可验收:“应 + 可观察响应”(显示/拒绝/存储/发送)接近验收标准,能直接映射成测试步骤。
- 原子化:一条 EARS 通常只描述一种条件-响应,没有长段落里的隐含假设。
- 人机双语:仍是自然语言,产品/业务能审;结构够规整,LLM 解析和代码生成更稳。
说句边界的话:EARS 不是要替代 User Story 或 Gherkin。它们各管一段,Story 管意图(为什么、给谁),EARS 管可验证行为(系统必须怎样),Gherkin 管测试自动化(关键场景)。给 AI 写规格,落的就是中间这层 EARS。
还有一点容易漏掉:EARS 只治“句法歧义”,不保证需求正确、必要、完整。它不是万能药,数学算法、UX 文案、目标管理这些不该硬套。但它恰好治的,是 AI coding 里最耗时间的那个病。
在我看来,AI coding 真正费时间的不是写代码慢,是以前“写代码之前开会澄清需求”的时间,现在全挪到了“代码写完了再反过来发现需求没讲清楚”。而且代码已经写出来,你会有锚定效应,顺着它写的那版去改,而不是从零思考。EARS 把澄清从“事后”挪回“事前”。
案例
https://x.com/OMOisomo/status/2078849477109260413?s=20案例一:库存校验
还是那句话,PM 写道:
“用户提交订单时校验库存,缺货要提示,体验好一点。”
看起来挺清楚。看 AI 会怎么脑补,以及 EARS 重写之后变成什么样。
AI 可能的默认理解(脑补版):
提交订单时 SELECT stock ... WHERE product_id = ?,count <= 0 就弹个 toast“库存不足”。代码不超过二十行。
它不会主动问:并发扣减怎么处理、超时要不要释放预占、购物车里三种商品缺一种的话是全部拒绝还是部分下单、先到先得是什么语义。
这版代码写完,表面上 feature 实现了。一测就露馅:两个人同时买最后一台 → 超卖,库存变负数;购物车三个商品缺一个 → 整单被拒,用户困惑“另外两个不是有货吗”。
EARS 重写之后:
- When 用户点击提交订单,系统应校验购物车中每个商品的当前库存。
- If 任一商品库存为零,则系统应在该商品旁显示“已售罄”,并展示其余有货商品的数量与总价;订单可部分提交。
- If 所有商品库存充足,则系统应为每件商品预占库存,锁定时间 15 分钟。
- If 15 分钟内未完成支付,则系统应释放该订单所有预占库存。
- If 预占库存时发生并发冲突,则系统应重试一次;重试后仍库存不足,则拒绝订单并显示当前库存。
五条,一条一个“应”,没有“尽快”“妥善”“体验好一点”。拆开看:第一条是正常路径 When,剩下四条全是 If(异常、边界、并发),原句里一个字没提。真正让代码从“能跑”变“能上线”的,就是这几条 If。
第五条里的“重试一次”是我自己定的数字。严谨做法是标 [待确认:重试次数、并发策略是否需 PM 拍板]。EARS 的纪律不是“把需求写全”,写不全很正常,是写不出来的地方,明确标出来要谁确认,不把默认值悄悄塞进实现。这,才是防脑补的关键:堵住 AI 自己填数字的口子。
案例二:登录校验
PM 写道:
“用户登录时要校验用户状态,体验好一点,密码错了要提示。”
AI 可能的默认理解(脑补版):
用户名密码查库,匹配就发 token,不匹配就回一句“用户名或密码错误”。仅此而已。
它不会主动问:账号被禁用怎么处理、密码连续输错要不要锁、锁多久、提示文案要不要区分“账号不存在”和“密码错误”。
EARS 重写之后:
- When 用户点击登录且已输入用户名和密码,系统应校验用户名、密码与账号状态。
- If 用户名和密码正确但账号已被禁用或失效,则系统应在登录页显示“账号已失效,请联系管理员”。
- If 密码错误,则系统应在登录提示区域显示“用户名或密码错误”,不区分具体是哪一个不对。
- If 用户在 60 分钟内连续输错密码达到 5 次,则系统应锁定该账号 30 分钟并显示“登录次数过多,请 30 分钟后重试”。
- Where 在已启用双因素认证时,系统应在密码验证通过后要求输入 6 位 TOTP 验证码。
五条,一条一个“应”。“体验好一点”背后是:错误要区分但不暴露太多、防暴力破解要有阈值、账号禁用要覆盖、2FA 单走一条 Where。
第四条里的“5 次 / 30 分钟”同样是 AI 最可能偷偷填的数字,照例进待确认清单。
两个案例走下来,模式一致:一句模糊 PRD → AI 在最简单路径上写完了 → 异常、边界、安全、并发全漏 → EARS 把每条钉成可测试的“应”句 → 写不出的数字进待确认清单,不自行填充。
把 EARS 嵌进工作流

第一步:把原始需求丢进改写工具。
下面这段 prompt 可以直接复制,把末尾“原始需求”换成你的内容:
第二步:你做裁判,不当作者。
AI 拆好了,你要做的是审核,不是重写。判断三件事:
- 拆分对不对,该 When 的是不是写成了 If?漏了哪些异常路径?
- 补业务上下文,AI 不知道你们项目的规则,你能一眼看出缺哪条。
- 过待确认清单,哪些数字自己能定,哪些必须回 PM、拉安全团队对齐。
记住一条纪律:改写 ≠ 发明需求。EARS 只澄清结构,缺信息就标 [待确认],不替 PM 做业务决策,也不让 AI 默填商业规则。
第三步:把 EARS 规格嵌进编码工具。
改好的 EARS 规格别只放需求文档里,直接贴到 AI 编码工具的任务描述里,让模型写代码之前就看到无歧义的输入:
- Claude Code:贴在任务 prompt 开头。
- Cursor:放第一条消息。
- 其他工具:作为 task description 第一段,优先级高于后面的实现细节。
别写进 CLAUDE.md、.cursorrules 这类长期规则文件,那里放“永远要遵守的规范”,不放“这一次的需求”。
这样模型看到的不是“校验库存,体验好一点”,而是五条 When / If 句,触发、响应、异常兜底全钉死。
第四步:同一份规格,多处复用。
PM 原始需求 → EARS 改写 → PM 确认待确认项 → 干净 EARS 规格 ↓ 一份多用:AI 实现 / 生成测试 / 评审验收
- AI 编码:规格直接贴任务描述。
- 生成测试:每条 SHALL 对应一个 test case,正常 + 异常全覆盖。
- 评审验收:PM 和 QA 对照逐条查,上线标准不再是“感觉没问题”。
一份投入,至少三份产出。这十几分钟换的是:返工轮次下降、联调不突然炸出异常分支、待确认问题提前暴露、你从“修 bug”切到“审逻辑”。
如果只想先试一次:挑一句带“支持 / 尽快 / 友好 / 妥善 / 合理”的需求,走上面流程重写一遍,数一数你不得不回问 PM 多少个问题,问题比想象中多,而这正是 EARS 的价值。

总结
用 EARS 一段时间,我最大的感受不是“需求写得更规范了”,而是跟 AI 协作的摩擦力变小了。
以前的循环:扔一句模糊需求 → AI 写一版大概对但边界漏的代码 → 我跑一遍发现不对 → 追问 → 改 → 再跑 → 再发现不对。整个过程像在跟一个不会提问但特别能写的 junior 合作,思考负担全在我这边。
现在是:先把需求里的假设全逼出来 → AI 拿到无歧义规格 → 它写的代码我直接审逻辑,不用再判断“它到底理解对了没有”。
回到开头那句“追问到 100% 明确”。它有用,但只解决“说不清”。真正防脑补的,是让 AI 没有洞可填,这一步,EARS 帮你在需求层就做完了。
提示工程的上游,是需求工程。
不是让 AI 学会理解暧昧,是先把暧昧消灭干净,再让 AI 干活。
你最近一次 AI 写偏,是因为什么?回头看看那句原始需求,里面藏了几个你自己都没意识到的漏洞?
更多AI使用系列
- AI使用实战复盘——省token和防幻觉
- AI使用实战复盘——每次对话发了什么