
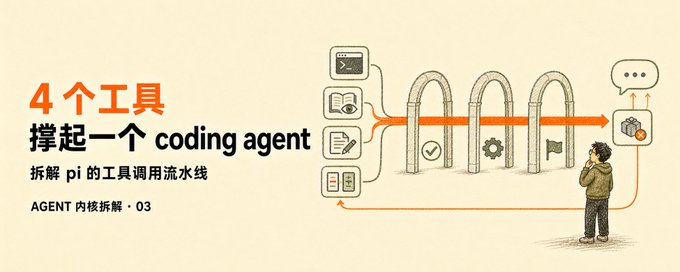
4 个工具撑起一个 coding agent
【Agent 内核拆解】系列文章第 3 篇。这个系列我会对照三个开源 coding agent,分别是 OpenAI codex(101k star)、xAI grok-build(23k star)和 earendil pi(78k star),一层层拆它们的内核,最后带你从零写一个自己的。
你在 Claude Code 里说"读一下 config.json",模型不会自己去读文件。它输出一段结构化的请求,大概长这样。
export async function withFileMutationQueue<T>(
    env: ExecutionEnv, path: string, fn: () => Promise<T>,
): Promise<T> {
    ...
    await currentQueue;              // 等前一个改同一文件的操作
    try { return await fn(); }
    finally {
        releaseNext();
        if (state.queues.get(key) === chainedQueue) state.queues.delete(key);
    }
}
系统拿到这段 JSON,找到名叫 read 的工具,执行它,把文件内容包装成一条 tool_result 消息塞回对话历史。模型在下一轮看到文件内容,继续往下走。
这就是工具调用。模型没有手,它只能输出"我要用哪个工具、参数是什么",系统替它执行,再把结果告诉它。第 1 篇讲的 while 循环里,每一轮的"执行工具"就是在做这件事。
打开 pi 的内核文件 agent-loop.ts,一共 792 行。第 375 行开始一直到文件结尾全是处理工具调用的代码,418 行,占了一半多。模型调用那边只有一个 stream() 函数,工具这边却占了一多半的代码量。原因很简单,模型调用只是发请求和解析响应,工具调用才是真的去改文件、跑命令。
pi 只内置了 4 个工具
模型能调什么工具,取决于系统注册了什么。pi 在packages/agent/src/harness/tools/ 下只注册了 4 个:
- bash:执行 shell 命令
- read读文件,也能读图片
- write写文件,自动建目录
- edit多处替换 + diff
代码加起来总共471 行,读文件、写文件、改文件、跑命令,一个 coding agent 的基本操作靠这 4 个就够了。搜索、MCP 扩展之类的能力走另一套扩展注册,不在内核里。
模型每一轮对话看到的工具列表,就是这 4 个的名字、描述和参数 schema。模型根据这些信息决定调哪个工具、传什么参数。传得对不对,交给流水线去验。
一次调用经过什么
模型输出了一个 tool_use,说要调 edit 工具改一个文件。系统怎么处理?
pi 把处理过程拆成三步。每一步的失败方式不一样,所以分开写成三个函数。
async function executePreparedToolCall(prepared, signal, emit) {
    const updateEvents = [];
    let acceptingUpdates = true;

    try {
        const result = await prepared.tool.execute(
            prepared.toolCall.id, prepared.args, signal,
            (partialResult) => {
                if (!acceptingUpdates) return;
                updateEvents.push(Promise.resolve(emit({ type: "tool_execution_update", ... })));
            },
        );
        acceptingUpdates = false;
        await Promise.all(updateEvents);
        return { result, isError: false };
    } catch (error) {
        acceptingUpdates = false;
        await Promise.all(updateEvents);
        return { result: createErrorToolResult(error.message), isError: true };
    } finally {
        acceptingUpdates = false;
    }
}
第一步,准备
agent-loop.ts:600,65 行。按顺序做四件事,任何一步出问题,工具不会被执行,直接返回一条错误结果给模型。
① 兼容层 prepareArguments。 4 个内置工具里只有 edit 用了这个钩子(harness/tools/edit.ts:48)。模型经常把 edits 数组序列化成 JSON 字符串,或者用旧版 schema 的顶层 oldText/newText 字段,这一步在校验之前把形状捏对。
② schema 校验。 在 ai/src/utils/validation.ts:278。先做类型强转(字符串 "3" 转数字 3),然后检查。失败时抛出的错误信息长这样。
function shouldTerminateToolBatch(finalizedCalls) {
    return finalizedCalls.length > 0
        && finalizedCalls.every(f => f.result.terminate === true);
}
错误列表后面跟着模型传过来的原始参数。为什么要回显?因为这条报错最终会作为 tool_result 返回给模型。模型看到自己传了什么、哪里错了,通常一次就能改对。校验报错是写给模型看的,所以要把模型自己传的参数带上。
③ beforeToolCall 权限钩子。 返回 { block: true, reason } 就能拦下这次调用。你在用 Claude Code 时看到的"是否允许运行此命令"就是这个钩子。拦截理由作为错误结果返回给模型,模型通常会换个安全的做法。
④ 检查中断信号。
准备阶段是串行的,即使整批工具调用最终会并行执行,准备阶段也一个一个按模型给出的顺序来。原因是权限钩子需要按顺序看到每一次调用,不能乱序。
第二步,执行
agent-loop.ts:666,42 行。工具真正跑起来了。
agent-loop.ts:709,46 行。afterToolCall 钩子可以改写工具的执行结果。
result = {
    ...result,
    content: afterResult.content ?? result.content,
    details: afterResult.details ?? result.details,
    usage: afterResult.usage ?? result.usage,
    terminate: afterResult.terminate ?? result.terminate,
};
isError = afterResult.isError ?? isError;
acceptingUpdates 是给 onUpdate 回调加的闸门,如果execute 返回之后再调 onUpdate 就被忽略。4 个内置工具里只有 bash 用了 onUpdate(harness/tools/bash.ts:92),100ms 节流往 UI 推 shell 输出。闸门防的是定时器忘了清理,在后续调用期间产生脏事件。
await Promise.all(updateEvents) 出现了两次,try 里一次 catch 里一次。emit 可能是异步的(比如推 UI),不等它完成就往下走,事件顺序会乱。异常路径也一样需要等。
最关键的是那个 catch。工具抛出的异常在这里被接住,变成一条 isError: true 的结果返回给模型。
上一篇讲的是"调用模型的函数永远不抛异常"。这一篇的规矩正好反过来。pi 在 types.ts:388 的工具接口注释里写了一句。
Execute the tool call. Throw on failure instead of encoding errors in content.
工具失败必须抛异常。
两条规矩方向相反,原因是错误的接收方不同。模型调用失败,接收方是程序,程序处理不了网络故障,只能优雅退出。工具执行失败,接收方是模型,模型读懂"文件不存在"之后会自己 ls 排查。第 1 篇实测到的"读不存在的文件 → agent 自己 ls → 回来提问",机制就在这个 catch 里。三篇到这里连成一条线。
第三步,收尾
https://github.com/yanhua1010/build-your-own-coding-agent没有深合并,每个字段要么用钩子返回的值,要么用原来的值。钩子自己抛异常也被 catch 住变成错误结果。收尾阶段的任何失败都不被允许影响主循环。
三步走完,结果被包装成一条 tool_result 消息塞进对话历史。模型在下一轮看到这条消息,决定接下来做什么。执行成功就继续下一步操作,isError: true 就尝试自我修正。
还有一种情况发生在三步之前。如果模型的响应本身被截断了(stopReason === "length"),参数可能只写了一半,所有工具调用直接作废。报错信息告诉模型"重发一次带完整参数",模型收到之后通常会照做。
模型一次调了多个工具怎么办
模型可以在一轮输出里同时调多个工具。比如同时读两个文件,或者 edit 一个文件的同时 bash 跑一条命令。
pi 的处理方式是并行执行(agent-loop.ts:489),但代码里同时存在三个顺序。

实现上的一个技巧是往同一个数组里放了两种东西。准备阶段直接出错的,放结果对象。准备通过的,放一个还没启动的函数。最后统一展开。

并发在 Promise.all 这一行才真正发生。它按数组下标返回结果,不管谁先跑完,写进对话历史的顺序永远和模型给出的顺序一致。重放同一段历史一定得到同一个结果。
用配套仓库里的 demo-order.mjs 可以直观地看到这个效果,不需要 API key。
完成顺序 call_2(1s) → call_3(2s) → call_1(3s) 消息顺序 call_1 → call_2 → call_3
两个 edit 同时改同一个文件
edit 和 write 都没有声明串行模式。它们敢并行,是因为各自的 execute 函数里都调了 withFileMutationQueue(harness/tools/file-mutation-queue.ts,56 行)。
{
  "type": "tool_use",
  "name": "read",
  "input": { "path": "config.json" }
}锁的粒度在单个文件的规范路径上,而不在工具本身。改 a.ts 和改 b.ts 照样并行,只有两次调用打到同一个文件才排队。getMutationQueueKey 用 env.canonicalPath 解开 symlink,所以 ./src/a.ts、/abs/src/a.ts 和一个指向它的软链接落到同一把锁上。
这 56 行解决的是真实事故。模型一次发两个 edit 改同一个文件,两个并行跑起来,第二个读到的是第一个写入之前的内容,改完覆盖回去,第一个的修改就没了。
一个 sequential 拖累一批
一批调用里只要有一个工具声明了 executionMode: "sequential",整批降级为串行,包括那些本来可以并行的工具。pi 的 4 个内置工具都没有声明 sequential。典型需要 sequential 的是向用户提问的工具(examples/extensions/question.ts:50),两个问题同时弹出来会抢终端。
terminate 全票才停
async function prepareToolCall(...) {
    const tool = currentContext.tools?.find(t => t.name === toolCall.name);
    if (!tool) {
        return { kind: "immediate", result: createErrorToolResult("..."), isError: true };
    }
    try {
        const preparedToolCall = prepareToolCallArguments(tool, toolCall);     // ① 兼容
        const validatedArgs = validateToolArguments(tool, preparedToolCall);   // ② 校验
        if (config.beforeToolCall) {                                           // ③ 权限
            const beforeResult = await config.beforeToolCall({...}, signal);
            if (beforeResult?.block) {
                return { kind: "immediate", result: createErrorToolResult(beforeResult.reason), isError: true };
            }
        }
        if (signal?.aborted) { ... }                                           // ④ 中断
        return { kind: "prepared", toolCall, tool, args: validatedArgs };
    } catch (error) {
        return { kind: "immediate", result: createErrorToolResult(error.message), isError: true };
    }
}
every 而不是 some。模型同时调了一个"任务完成"工具和一个 bash,用 some 的话 bash 的结果会被丢掉。用 every 意味着只要还有一个普通工具在跑,循环就继续,让模型看到全部结果再决定下一步。
自己写一遍
配套代码在文末仓库的 steps/03,在上一篇的基础上新增了 5 个文件。
tool-runner.mjs 三段式流水线 + 并行执行 tools.mjs 工具定义 validate.mjs 参数校验 mutation-queue.mjs 按文件排队 demo-order.mjs 并行顺序演示
event-stream.mjs、providers.mjs、api/ 和上一篇完全一样,没改一个字。
工具增加到 5 个,包括 read_file、write_file、edit_file、bash 和 ask_user。前 4 个对应 pi 的 4 个内置工具,ask_user 声明了 executionMode: "sequential",可以验证"一个拖累一批"的效果。
有几个场景建议自己跑一遍。
故意打错文件名。 比如让 agent "读一下 confg.json"。工具抛出的 ENOENT 带着完整路径原样喂回模型,模型看到之后通常会自己 ls 一遍找到正确的文件名再重读。机制就在 tool-runner.mjs 的 execute 那个 catch 里。
让 agent 执行 rm -rf。 模型的命令会被 agent.mjs 里的正则拦截,拦截理由作为工具结果返回给模型,模型通常会换一个安全的做法重试。设置 PERMISSION=ask 可以让每条 bash 都先问你一次 y/N。
跑 demo-order.mjs。 不需要 API key,模拟三个耗时不同的工具调用,终端上能直接看到完成顺序和消息顺序的区别。
同时改同一个文件。 让 agent "在 notes.md 末尾追加三行不同的内容"。没有 mutation-queue.mjs 的话三条修改只有一条能留下来,有了按文件排队就不会丢。
test.mjs 有 34 个离线用例,覆盖参数校验、文件排队、三段式各阶段的失败路径、并行的三个顺序、onUpdate 生命周期、terminate 的 every 语义和截断作废。
接下来讲什么
前三篇把 agent 的三层结构都拆过了一遍,while 循环是骨架,模型调用和工具执行是两只手。mini-agent 走到这一步已经能干活了。
后面的文章讲的是"能干活"和"能上线"之间的差距。
- 第 4 篇,上下文压缩与会话持久化。 对话越来越长,token 会爆,关掉再打开历史也没了。pi 的 compaction 有 1287 行,session 有 1204 行,合起来解决的就是这两个问题
- 第 5 篇,权限与安全。 agent 凭什么敢执行命令,sandbox、路径隔离、beforeToolCall 怎么配合
研读笔记、图解和上面提到的 mini-agent 代码都放在下面这个仓库,每篇文章对应一步可以直接运行的代码,接 DeepSeek 或 GLM 的 API 就能跑。
https://github.com/yanhua1010/build-your-own-coding-agent
想第一时间看更新,关注 --> @yanhua1010
const errorMessage =
    `Validation failed for tool "${toolCall.name}":\n${errors}\n\n` +
    `Received arguments:\n${JSON.stringify(toolCall.arguments, null, 2)}`;
本文引用的 pi 源码遵循 MIT License,版权归 earendil-works 所有。