
「保姆级教程」第一次玩 DGX Spark:本地跑通 124B 大模型,准备、部署、量化、测速、Agent 接入全记录
8月上半月的开源大模型好生热闹,趁着周末闲下来我简单整理了一下,各家大厂中厂都在蓄力发力,同时也对闭源模型产生了不小的冲击。
年前公司就在讨论购买AI给研发用的问题,然后年后没多久又在讨论另一个问题,就是到底要不要自己部署内部大模型。最后领导们最终拍板给我们这个小部门搞了一台福利机,一个小盒子,就是DGX Spark,有一种买前生产力,买后爱奇艺的感觉。
公司这台机器一直是一个运维的同事在管理和维护,自己也只是偶尔看一下,从来没操作过。于是大周末的我萌生了一个想法,自己远程到公司的服务器来部署个大模型玩一玩。
本文目录如下,可进行选看
- 1、为什么是 DGX Spark
- 2、来看看 DGX Spark
- 3、在 DGX Spark 部署什么大模型
- 4、在 DGX Spark 上怎么部署大模型
- 5、如何下载大模型
- 6、开始执行
- 7、开始测速
- 8、对接Claude Code感受一下速度
- 9、总结
一、为什么是 DGX Spark
因为公司开始使用 AI 之后,很快就会遇到几个非常现实的问题:
数据是否适合上传到外部平台?
模型能否在企业内部稳定运行?
响应速度和调用成本是否可控?
在正式部署以前,应该怎样用真实资料完成验证?
如果所有跟AI有关的都依赖外部API或者云端,开发启动确实也很方便,但随着数据量、调用次数和隐私要求增加,成本与管理边界也会变得越来越复杂。但是纯本地部署则需要考虑算力、模型适配、运维和后续扩展。
因此,我们更看重的是一种可组合的方式:需要快速调用时使用外部API或者云端能力,涉及内部资料、持续推理和部署验证的时候,在本地建立一套可控制、可测试的环境。
DGX Spark 正好位于这两种方式之间。
二、来看看 DGX Spark
DGX Spark 是英伟达在 2025 年推出的桌面级个人 AI 超算,它把数据中心级的 Blackwell 架构,压缩进了 15×15×5 厘米、1.2 公斤的小盒子(下图笔记本右侧)里,让开发者在本地就能跑大模型,而不必依赖云算力。
这里是英伟达官网购买链接,不是广告,也没广告费,你也可以直接在:https://marketplace.nvidia.com/en-us/enterprise/personal-ai-supercomputers/dgx-spark

我简单的把截图的配置再翻译一遍。
它的核心是一颗GB10 Grace Blackwell 超级芯片:
CPU:20 核 ARM(10 核 Cortex-X925 + 10 核 Cortex-A725)
GPU:Blackwell 架构,6144 个 CUDA 核心
内存:128GB LPDDR5X统一内存(CPU 和 GPU 共享,这一点很关键)
带宽:273 GB/s
算力:FP4 精度下约 1 PFLOPS(1000 TOPS)
存储:1TB 或 4TB NVMe SSD功耗:约 140W(外接 240W 电源)
系统:DGX OS(基于 Ubuntu 24.04)
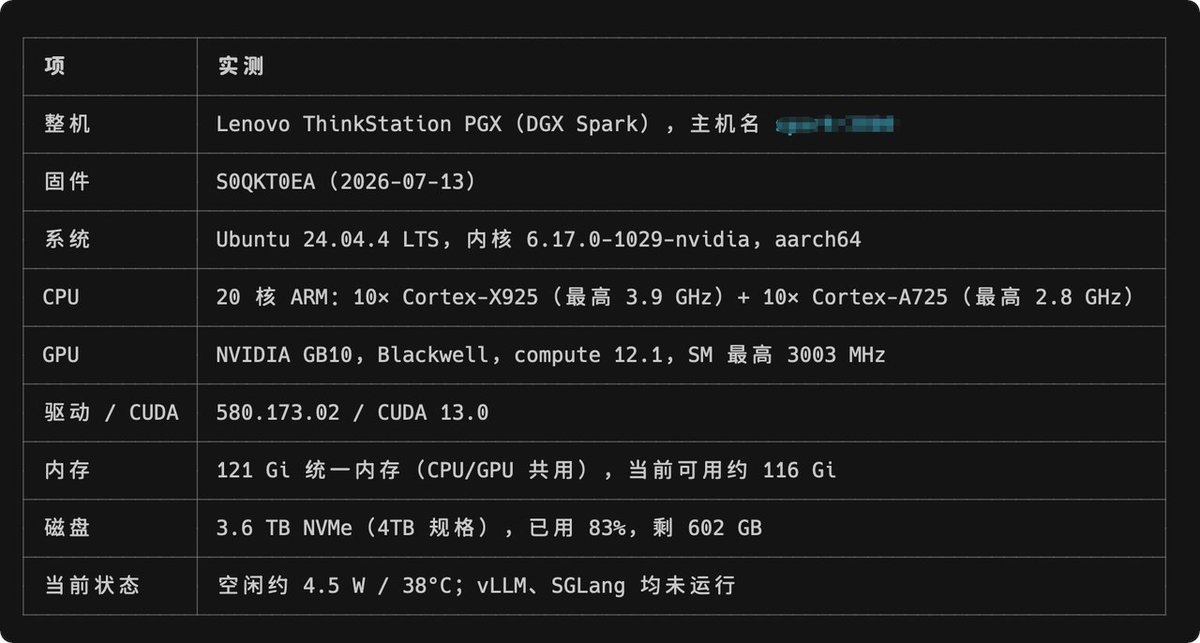
我直接让我的Claude Code 远程连上 这个小盒子后实地的查看了一下它的配置参数

从优点看,属于谁看谁迷糊的香;从缺点看,属于望而却步的贵。所以,这个比较适合中小企业内部搞事情(DGX Spark 最多支持 4 个级联,就可以跑更加牛掰的模型了),让老板掏钱,员工使用。当然,对于手头不缺钱的极客们,估计也不是啥大问题。
这里有个注意事项:DGX Spark 上适合跑稀疏模型,不太适合跑稠密模型
那到底什么样的模型是稠密模型,什么样的模型是稀疏模型?以及这哥俩到底差别在哪里呢?
一句话就能判断:模型每处理一个 token,是不是把全部参数都用上了。 稠密模型就是全部都用上;而稀疏模型是只挑一小撮专家出来干活,其余的躺着不动。
看着两个模型:Qwen-3.8-27B和Qwen3.8-2.4T-A95B。27B = 270 亿参数,2.4T = 2.4 万亿参数。
关键点就在于2.4T后面的 “A95B”:2.4T 总参数 / 95B(970亿)激活
稠密模型 Dense(Qwen-3.8-27B):每生成一个 token,网络的全部权重都要参与计算。27B 就是实打实的 27B 全跑一遍。
稀疏模型 MoE(Qwen3.8-2.4T-A95B):模型内部有 512 个「专家」小模块,每处理一个 token,只叫醒其中 10 个来干活,另外有 1 个专家是常驻的、每次都参与。所以虽然模型总共 2.4 万亿参数,实际每个 token 只用到约 950 亿——剩下的都在睡觉。
三、在 DGX Spark 部署什么大模型
上面刚好学习了稠密模型和稀疏模型。
我查阅资料发现:NVIDIA 官方称单台可运行最高约 200B 参数级模型。 但对于 LLM 解码,除了算力之外,模型权重需要持续从内存中读取,所以大 Dense 模型越大,每生成一个 token 要扫过的权重越多;而 MoE 每个 token 只计算少数专家,计算量通常低得多。NVIDIA 的推理栈也专门支持 MoE kernel 和 Expert Parallelism。
想把 这 128GB 的统一内存和本地 Agent 推理效率发挥到更高,我个人暂时更倾向于总参数能装下的 MoE 稀疏模型。
alias cc-dspark-fp4="claude --dangerously-skip-permissions --settings ~/.claude/settings.dspark-fp4.json"Qwen3.8-2.4T、DeepSeek-V4-Pro、GLM-5.3这几个根本不用考虑,Muse和Qwen3.8-27B 刚好都是Dense 稠密模型,从发挥内存极致角度,暂时可以不考虑了。
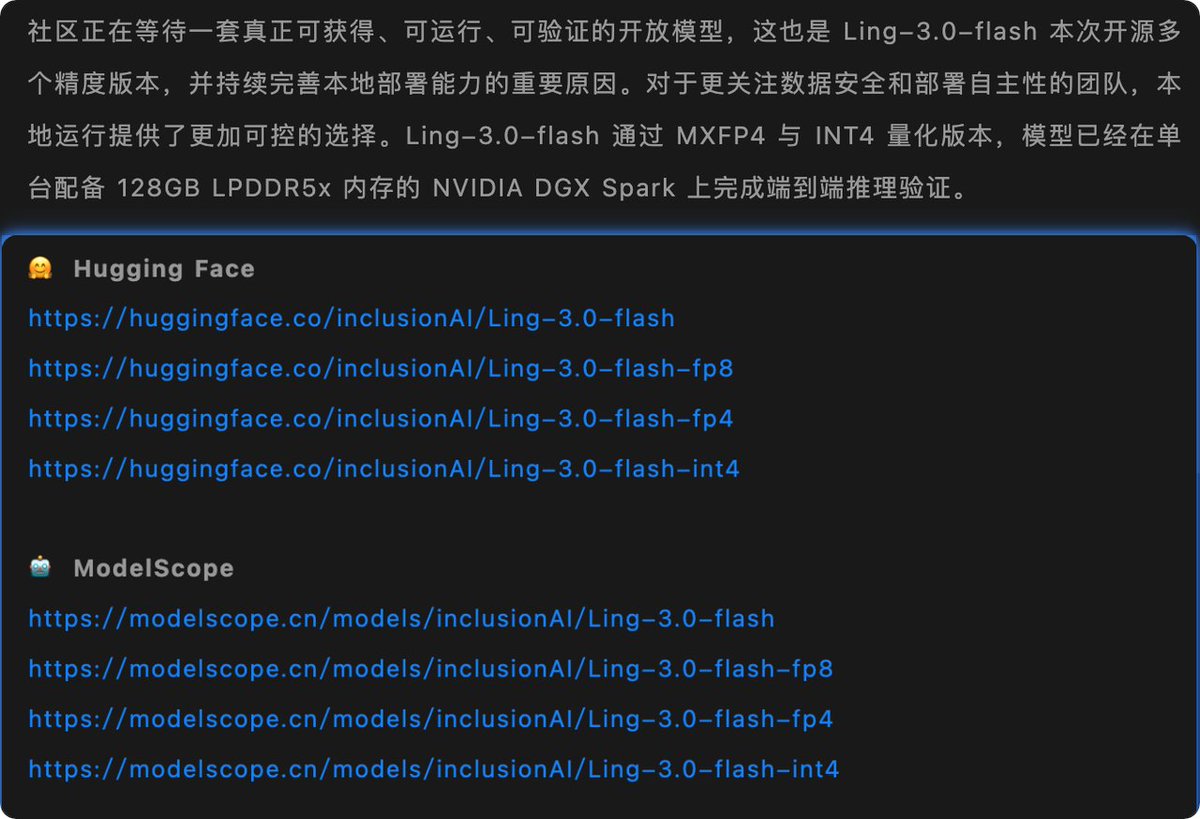
通过排除法,决定来试试这个蚂蚁百灵:Ling-3.0-flash。经过一番搜索,我发现官网的文章中也特意进行了说明

针对 DGX Spark 有特意的验证,啥也不说了,那就直接拿它来验证走一波。
看到链接后的Ling-3.0-flash下面还有 fp8、fp4、int4 这几个到底是啥玩意,下面一张图简单的来看一下。
1、准备 Python 3.12 以及虚拟环境 (uv)
2、安装 vLLM 官方 ARM64 CUDA 13.0 预编译包
3、下载 Ling-3.0-flash INT4 模型权重
4、启动 vLLM HTTP 推理服务(这里有很多参数需要配置,比如开MTP加速、启用工具调用、最大Token等等参数)
5、服务开启后,可让Claude Code 直接先在服务器上进行验证服务和接口调用
6、然后开启大模型测评了
所以下面选择的大模型都确定好了,刚好看到一个github仓库
https://github.com/inclusionAI/ling-cookbook

最终我在 DGX Spark上成功运行了这两个,一开始我是没发现这个仓库的,直接使用vLLM把INT4 跑起来了,其他几个好像遇到配置问题折腾了一番也不太行。
后来在一个群里发现了这个仓库,就又去尝试了一下。没想到真的成功了。
这里我使用本地的 Claude Code,然后远程到DGX Spark让它执行就完事了,让AI打辅助来部署大模型还是很容易的,但是真的遇到硬问题,也是脑壳痛,AI也搞不定。
四、在 DGX Spark 上怎么部署大模型
上一节的ling-cookbook 虽然给了指引,我还是在这里详细剖解一下如何在 DGX Spark 上部署大模型。以前我在我的破 Mac 上都是Ollama 一把梭。
为什么选Ollama,就是因为 Ollama 上手门槛极低,敲一条命令就能拉起大模型,日常本地测试、快速验证想法真的特别方便(新手入门首选这点我深有体会)。
但它也有自己的设计局限,调度逻辑偏顺序执行,没有专门为高并发做批处理优化,显存管理也做得比较粗放。一旦并发请求多起来,等待队列很快就会积压,响应延迟直接从毫秒级涨到秒级,情况严重的时候还会出现OOM内存溢出。这也不能算它的缺点,只能说是产品本身的设计边界,主打轻便就牺牲了高并发能力。
vLLM大概是2023年伯克利团队推出来的,实际落地感受下来(差距真的挺明显),同等硬件配置下,vLLM的吞吐量能翻几倍甚至十几倍,延迟波动也更小,整体服务稳定性靠谱很多。而且它原生兼容OpenAI接口规范,支持流式输出、多模型调度,正式上线的部署成本也不算高。
最终的结论是:对于 DGX Spark 这种级别的设备,使用 vLLM 才能对得起这颗 GB10 芯片。如果你追求极致的 tokens/s 和长文本处理能力,vLLM 是比较好的选择。
vLLM开源项目地址:https://github.com/vllm-project/vllm
vLLM官网地址:https://vllm.ai
vLLM官网有详细的使用说明指引,进入vLLM官网首页就能看到安装vLLM的指令但是需要进行选择相关的配置
有时候vLLM可能满足不了你,那么SGLang或许是更好的选择,这里就简单延伸一下。SGLang 性能选手,图快,吞吐经常压 vLLM 一头,但上手相对vLLM更难一点,但是在有AI辅助的情况下,其实也就是稍微多花一点时间。
SGLang同样是开源项目:https://github.com/sgl-project/sglang
官网地址:sglang.io 社区力量同样庞大
既然工具已经选择了,下一步就是下载并部署大模型了。
这里强调一点:如果你也部署Ling-3.0-flash 相关的量化模型,有些时候遇到问题可以需要到蚂蚁开源根据地 https://github.com/inclusionAI比如蚂蚁百灵针对vLLM进行修复了bug,但是vLLM官方可能没来得及合并,那么这时候你可能就需要来这里进行查找一下
五、如何下载大模型
Hugging Face国际主流,它有自带的hf
ModelScope 阿里运营,国内直连
下载 Hugging Face上的模型这里我就直接还用的官网自带的开源工具
https://github.com/huggingface/huggingface_hub
这里github首页就有比较清晰的hf命令行指引

ModelScope 同理也有类似 hf的命令行工具
开源项目地址:https://github.com/modelscope/modelscope
官网命令行工具使用指南 https://modelscope.cn/docs/models/download
这里下载了两个:https://huggingface.co/inclusionAI/Ling-3.0-flash-int4https://huggingface.co/inclusionAI/Ling-3.0-flash-fp4
六、开始执行
比如现在想部署Ling-3.0-flash-int4
https://github.com/inclusionAI/ling-cookbook/blob/main/guide/local-deploy/ling-3.0-flash/dgx-spark-vllm-int4.ipynb
直接先让Claude Code、或者Codex等Agent 先远程到小盒子服务器,然后将这个链接直接丢给Agent 叫他们继续安装,有错误,你看看怎么出力就好了。
另外一种就是根据自己的思路来安装,我前面几节也简单的进行了比较详细的说明,这里整体进行梳理一遍
七、开始测速
先来看一个MTP 推理加速到底是个什么玩意?

于是我就叫的Claude Code 直接分别在小盒子服务端上,以及我本机客户端分别进行单用户20轮的请求轮跑,来验证推理速度。
先来看看Ling-3.0-flash-fp4
下面左侧是开启了MTP加速的,右侧是未开启MTP加速的。加速不是特别理想,应该跟我配置或多或少有点关系。
再来看一下Ling-3.0-flash-int4,我这个开启了MTP,比Ling-3.0-flash-fp4没开启MTP还要慢。
本来还想测试一下Ling-3.0-flash-int4 不带MTP加速的,这么慢根本不用测了,不过我开启了MTP,好像看到别人有38token/s 还是慢了一点,可能哪里的配置有点小问题,有时间再研究一下。
暂时直接选择Ling-3.0-flash-fp4 并且要开启MTP推理加速。
八、对接Claude Code感受一下速度
由于周末我是在家里远程公司的小盒子,所以比较方便的做法我直接叫AI帮我做的隧道转发服务器AI api端口的服务

其实这里如果你是局域网访问就比较容易了,或者使用tailscale等内网穿透的工具,这里公司电脑上没装别的工具,所以我这里选择隧道转发也是比较方便的一种做法。
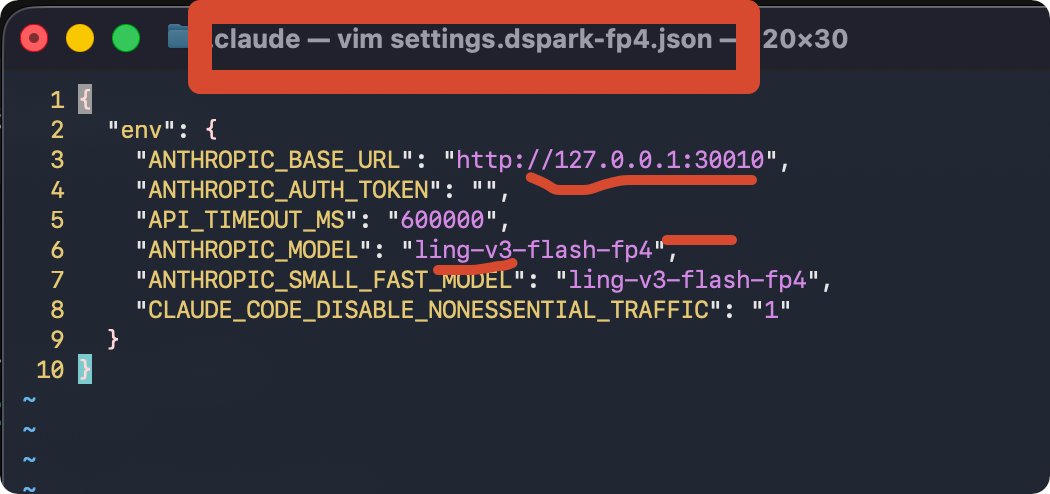
然后在.claude 文件夹下新建一个settings.dspark-fp4.json

再在.zshrc全局文件中添加命令短别名
https://sglang.io/然后来感受一下 Ling-3.0-flash-fp4 的输出速度,完全没有加速视频

九、总结
Ling-3.0-flash 采用 124B 总参数、5.1B 激活参数的 MoE 架构。它保留了千亿参数模型的知识与能力容量,但在生成每个 Token 时,只激活其中约 5.1B 参数,从而降低单次推理的计算开销。
这让 Ling-3.0-flash 不只是一款“跑得快”的模型,也能够真正进入不同规模的业务系统。开发者既可以直接调用模型,也可以自由验证、部署和定制模型能力,将 Ling-3.0-flash 接入自己的业务系统、开发工具链和 Agent 工作流。
目前看接入到公司某些工作或者开发流程中还是非常可行的,速度没的说,能力也不错,下一步就针对Agent 工作流进行优化,来验证一下效果看看。
最后这个周末收获满满,惊喜满满。一定要有AI First 理念。能让AI帮你处理的就不要去操心了,但是我觉得很多东西有必要搞清楚原理,就比如本地部署大模型,了解整个部署过程,才能更好的找到各种各样的问题,你觉得呢?