
从单机到双机:小白靠 AI 助手跑通 124B 大模型的完整记录
我,一个非计算机出身的普通用户。 全程没有自己写过一行正经代码,所有命令、脚本、排错都靠 AI 助手完成,我只负责决策、验证和记录。 这篇既是给同样「非科班但想玩大模型」的人看的 step-by-step,也是给有技术基础的人 5 分钟扫完的评测笔记。
写在前面:为什么这篇值得你看
干了什么:一个没学过编程的人,用两台 NVIDIA DGX Spark,成功把蚂蚁百灵 124B 参数的 Ling-3.0-flash 跑了起来,还做了单机 FP4 vs 双机 FP8 的完整评测,最后把服务通过公网 API 开放了出去。
这篇记录里你会得到:
- 如果小白线:每步都能拿起来用的命令,以及「为什么要做这步」的人话解释
- 技术线:真实的性能数字、架构原理、9 个踩坑,有基础的人直接跳 TL;DR 和评测章节
- AI 协作线:非科班是怎么靠 AI 助手干完这一切的——不是「AI 生成了就完事」,而是「AI 干活、我验证、坑记下来」
0. “太长不看版”(给没时间的人)
核心结论(重要,先看):
- 解码速度别开双机——长上下文下双机只比单机快 5%~30%,还要付跨机通信延迟
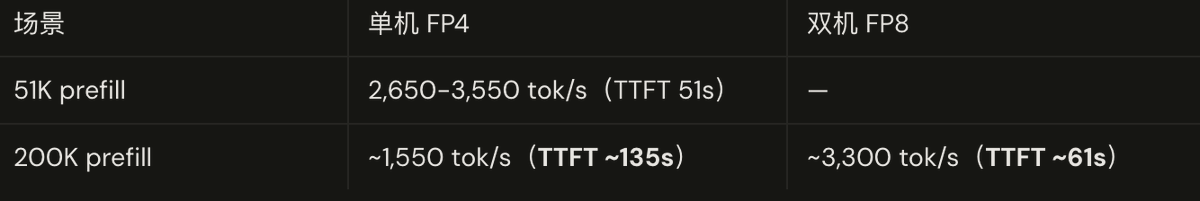
- 长输入预填充(prefill)才是双机的价值——200K 长文本 TTFT 从 135s 砍到 61s,2.2 倍
- 上下文长度是硬约束——单机 FP4 实际安全上限 ~240K,超了内存先爆;要 1M 级上下文只能上双机(或等 FP4 双机方案)
1. 背景:Ling-3.0-flash 是什么?为什么部署它这么折腾?
1.1 这模型有多能打
Ling-3.0-flash 是蚂蚁集团百灵团队 2026 年 7 月开源的模型。几个关键数字:

MoE(混合专家)是什么?
一句话:普通模型是「全科医生」,什么问题都自己扛;MoE 模型是「医院」,512 个专科医生,每次来病人(token)只喊 8 个最对口的专家会诊,其余 504 个休息。所以它总参数 1240 亿(医院很大),但每个字只付 51 亿的工资(5.1B 激活)
——这就是 MoE 又快又便宜的秘密。
1.2 为什么这么折腾?
按理说 124B 的模型,官方应该有开箱即用的部署方案。但 Ling-3.0-flash 有两个「新」:
- 架构太新:用了 KDA + MLA 混合注意力(5:1 交替)+ 512 专家 MoE,这个 bailing_hybrid 架构太新,主流推理框架(llama.cpp 等)我做的时候还跟上。不过现在已经更新,llamacpp已经支持了:https://github.com/ggml-org/llama.cpp/pull/26608(以上内容来自官方)
- 官方文档有坑:官方推荐的 Docker 镜像不适配 DGX Spark 的 GPU(GB10,sm_121 架构),启动必报 AssertionError: Hidden size mismatch——我们用 AI 助手查了半天,最后在社区 cookbook 里找到正解:必须用 SGLang 的一个未合入上游的 PR(#33561)从源码编译
这也是为什么这篇记录值得写:官方的路走不通,社区的坑要自己趟。
当然官方内容及 cookbook 预计也会持续更新,部署门槛有望持续下降。
2. 原理速通(3 分钟,给想「看得飞快」的人)
技术线读者扫这一节就够了。每个概念:一句结论 + 一句人话 + 一句精确表述。
2.1 量化:为什么同一个模型有 249GB、128GB、70GB 三个版本
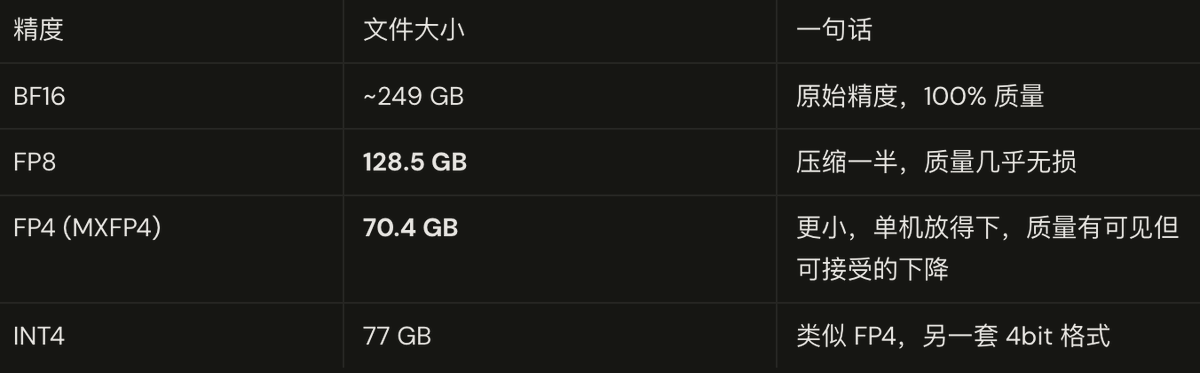
权重存储精度不同。精度越低文件越小、越快,但质量略降:
结论:能放得下是硬道理。 128GB 内存的单机跑不了 128.5GB 的 FP8(权重 + KV 缓存 + 系统会撑爆),但 70GB 的 FP4 绰绰有余。
2.2 张量并行 TP:一台放不下,两台拼一台
把模型按层「竖着切开」,每台机器扛一半权重,每生成一个 token 两台机器要做多次 all-reduce / all-gather 通信。
结论:TP 是「两台机器合体成一台 256GB 的机器」,代价是每 token 都要跨机通信。
2.3 主从 vs 对等:两台机器谁听谁的?
这是多机部署最容易搞错的概念。数据面完全对等,控制面 rank 0 是调度员。
- 数据面(计算):完全对等。 模型切两半,少了任何一台都算不出结果。类比:两个人抬桌子,没有「主抬人」。
- 控制面(调度):rank 0 是前台 + 指挥。 它接收 HTTP 请求、分发任务、聚合结果、对外暴露 API。类比:指挥并不比首席小提琴手更重要,但他负责起拍。
- 为什么先启动 worker(rank 1)再启动 master(rank 0)? 因为 rank 0 是集合点(rendezvous),它先启动会空等对端超时。小弟先站好位,老大再进场点名。
2.4 RoCE:高速互联是什么
RoCE(RDMA over Converged Ethernet)让网卡绕过 CPU 直接读写对方内存。我的两台机器用 RoCE 200G 互联,rsync 传 128GB 模型只要 ~5 分钟(400-540 MB/s)。没有它,通信延迟会拖死性能。
2.5 KDA + MLA:为什么这个模型长上下文「便宜」
Ling-3.0-flash 的 42 层里,只有 7 层是传统 softmax attention,另外 35 层是线性注意力(Mamba 系)。每 token 的 KV 缓存只有 ~8KB(对比传统模型动辄几十上百 KB)。
结论:长上下文解码退化温和——51K 上下文解码速度几乎零退化,218K 才掉 20%。这是它「长文本很能打」的架构底子。
3. 第一幕:单节点 FP4 —— 先用最低成本跑起来
本章结论:单机 + FP4 是验证「这个模型我能跑起来」的最低成本路径。70GB 权重 + SGLang 一个未合入的 PR,8.5 分钟启动,38 tok/s,跑通全部功能验证。
3.0 AI 协作是怎么开始的
我干的第一件事不是敲命令,而是给 AI 助手一个完整、自包含的任务描述:目标(部署单节点 Ling-3.0-flash,OpenAI 兼容 API)、硬件事实(不要重复探测)、已就绪资产(模型已下载、源码已编译,禁止重新下载)、已知坑(直接规避)。AI 负责执行,我负责盯验证清单。
��非科班方法论 #1:给 AI 的任务描述要「自包含」——它没有你的记忆,环境事实、资产路径、禁做的事都要写进去。宁可多写,不要让它重复探测。
3.1 硬件确认(30 秒)

我们的环境:DGX Spark ×2,GB10(sm_121,compute capability 12.1),121GB 统一内存,CUDA 13.0,Ubuntu 24.04 aarch64。这是 NVIDIA 的桌面级 AI 工作站——CPU 和 GPU 共用 128GB 内存,nvidia-smi 查不到显存(返回 N/A),要用 torch.cuda.get_device_properties(0).total_memory(~130GB)。
3.2 模型下载(国内路径)
机器在国内网络环境,HuggingFace 直连不通,走 ModelScope:

💡 AI 协作方法论 #2:下载这种机械重复的活,直接让 AI 写循环脚本 + 校验清单(index.json 完整性、分片数量、大小),跑完让它汇报,我抽查。
3.3 编译 SGLang(全项目最大的坑)
官方 Docker 镜像不能用的原因前面说过(sm_121 不适配)。正解是编译 SGLang PR #33561(分支 ling3-flash-dspark,commit 01ab993a6,版本号 sglang 0.5.6.post3.dev8945+g01ab993a6)。国内环境编译要点:

这个编译环节的坑能单独写一篇:缺 python3.12-dev 导致 Python.h 找不到、apt 也走坏代理要先注释掉、pip install ... | tail 会把真实退出码吞掉(这个 bug 曾让我们以为编译成功过)……完整清单在第七章。
3.4 启动单节点服务

关键参数解读(AI 给我解释,我复述给你):

启动时间线:加载 70GB 权重 371s(内存 65.6GB)→ CUDA graph 编译 101s → 总计 ~8.5 分钟。就绪标志:日志出现 The server is fired up and ready to roll!。
3.5 功能验证(4 项全过)

结果:17*23 → 391(思考链完整:17*20+17*3=340+51)、工具调用 JSON 正确、关思考生效。单机 FP4 跑通了。
3.6 第一组性能数字
- 短上下文:TTFT 0.14s,decode ~38 tok/s(单并发,含思考)
- 思考默认开启(reasoning_content 返回),可用 chat_template_kwargs: {"enable_thinking": false} 关闭
⚠️ 坑预警:如果模型输出变成 //////,不是服务坏了,是 GGUF/量化文件有问题(这个坑之前在其他机器上踩过,见第七章)。
4. 第二幕:双节点 FP8 —— 为什么要折腾第二台
本章结论:FP8(128.5GB)单机放不下,双节点 TP=2 每台只扛 64GB。数据面完全对等、控制面 rank 0 调度;先启动 worker,再启动 master。这是「两台机器合体」的正确姿势。
4.1 动机:不是炫技,是放不下
单机 FP4 已经跑通了,为什么还要双机?两个理由:
- 质量:FP8 比 FP4 更接近原始精度,评测需要对比两种方案的质量差异
- 容量:256K 上下文 + 更高精度的权重,单机内存是硬墙(后面评测章节有完整数据)
4.2 双机部署流水线
双节点和单节点的大流程相同,差异在四件事:
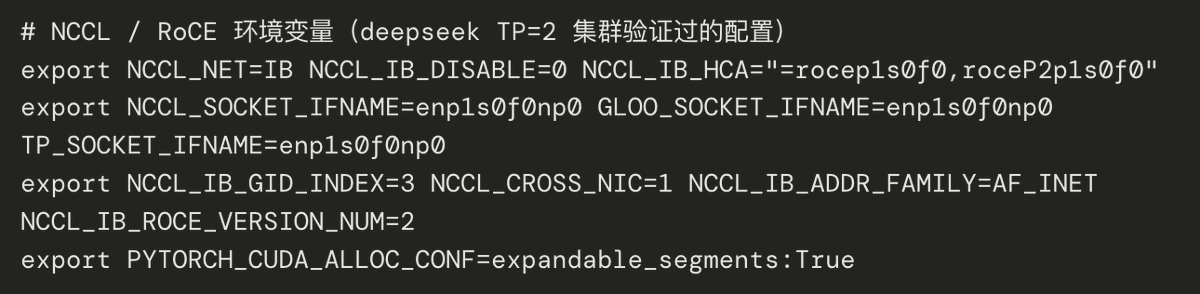
① 模型换 FP8(128.5GB,24 分片 → 每台都要有完整模型目录) ② 编译好的 SGLang 也要两台一致(两台机器可互换,角色由启动参数 --node-rank 决定) ③ RoCE 同步(rsync over RoCE,128GB ~5 分钟):

④ 启动顺序:worker 先,master 后(rank 0 是集合点,小弟先站好位,老大再进场):

4.3 验证
同样的验证清单(health → 17*23=391 → 工具调用 → 关思考)全过。日志特征:Detected fp8 checkpoint、Load weight end ... mem usage=60.27 GB(≈总量/TP)、CustomAllreduce is disabled ... spans across nodes(跨节点,正常)。
双机 FP8 性能(单并发):~40 tok/s 短上下文,每台内存 ~95/121GB,加载 ~2.5min/台(总计 ~8min 就绪)。
💡 AI 协作方法论 #3:双机部署最容易翻车的是「角色理解」。让 AI 给我讲清楚「数据面对等、控制面主从」之后,我理解了为什么 worker 要先启动,再也不用背命令——这是「理解原理」对非科班的最大价值:不用记,能推导。
5. 让全世界调用:OpenAI 兼容 API + 公网穿透
本章结论:SGLang 原生支持 --api-key 鉴权(不需要额外网关),配 frp 穿透后就是一个带 Key 的公网 OpenAI 兼容接口。无 Key 访问 /v1/* 返回 401,带 Key 返回 200。
5.1 架构
- 对外暴露的只有 frp 端口;master 本地 8000 直连公网不通(防火墙)
- /health 无需鉴权(方便探活),/v1/* 全部要求 Authorization: Bearer <key>
- Admin Key 额外管理接口(如 /flush_cache)
5.2 验证(全走公网入口)

5.3 调用示例

运维要点:两台DGX分主从,重启有顺序要求——worker 先、master 后。
6. 评测:单机 FP4 vs 双机 FP8,数字说话
租机器的时候特意租了双节点机器,就想看看刚好能装下的情况下性能差异有多大。 数据来自长上下文实测(同一套 prompt,--max-running-requests 1,CUDA graph decode)。
6.1 解码吞吐(生成速度)
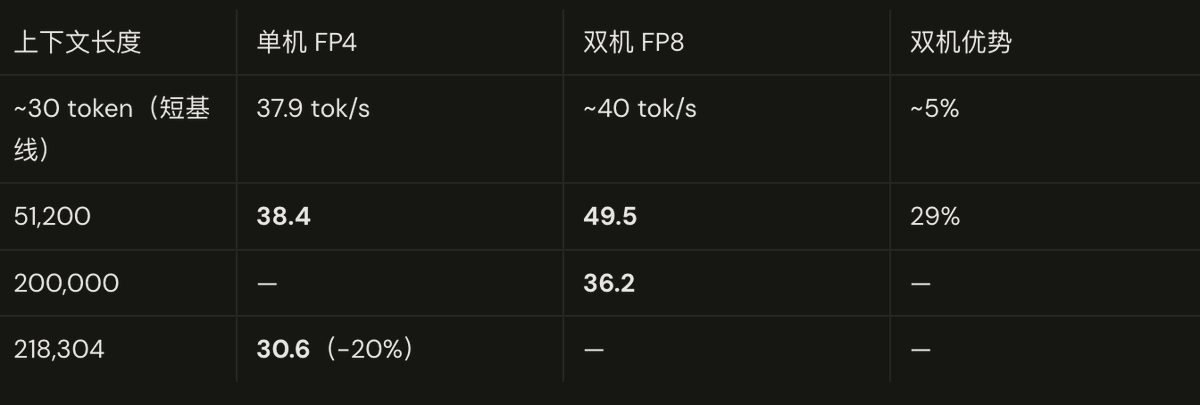
http://github.com/inclusionAI/ling-cookbook解读:单机 FP4 长上下文解码退化非常温和(51K 零退化,218K 才 −20%)——这是 KDA+MLA 混合注意力的功劳(每 token KV 仅 ~8KB)。双机优势随上下文增长(5% → 20-30%),但要付跨机 all-reduce 延迟。
结论 ①:为解码速度开双机不划算。 单并发下双机只快 5%~30%,而你要多养一台机器。
6.2 预填充吞吐(读长文的速度)
结论 ②:长输入 prefill 是双机最实打实的优势(约 2.2 倍)。 如果你要做「把 20 万字文档喂给模型」这种活,双机把等待时间从 2 分钟砍到 1 分钟。
6.3 内存墙与上下文天花板

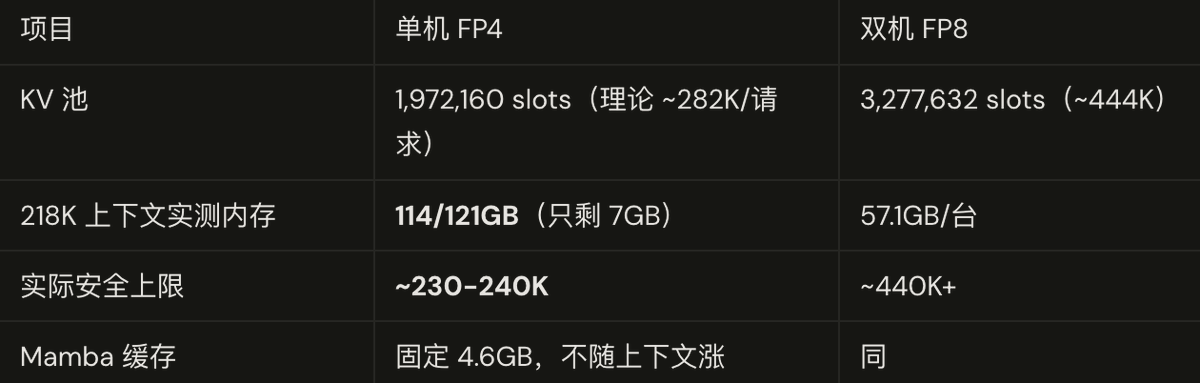
结论 ③:上下文长度是硬约束,不是速度。 单机 FP4 在 ~240K 先撞内存墙(比 KV 池理论值 282K 更早)。>250K 的上下文只有双机能跑。 要 1M 级?终极方案是 FP4 双机(35GB 权重/台 → KV 池 ~888K)。
6.4 评测综合结论
- 日常对话/短任务:单机 FP4 足够,38 tok/s 体验很好,成本最低
- 长文档阅读/长输入处理:双机 FP8 的 prefill 优势明显(2.2×)
- >250K 超长上下文:只能双机(或未来的 FP4 双机)
- 质量:FP8 更接近原始精度,评测场景建议双机做基准,单机做性价比
7. 踩坑清单(每个都付过代价)
在意技术细节的读者重点看这里。所有坑都是真实踩过、验证过解法的,按类分组。
编译阶段(一次一个坑,每个都烧掉一个编译周期)
运行期
评测方法里的坑
8. 结语:折腾 124B 大模型的感想
这套流程我做了什么、AI 做了什么

给小白的建议
- 让 AI 干脏活,但你必须理解「为什么」——还是需要理解主从/对等、量化档位、内存墙这些概念,AI 给的每个参数你都能问出「这行是干嘛的」,部署就从「黑盒/玄学」变成「工程」
- 验证一切——AI 说「部署成功」不算数,验证清单(health 200、17*23=391、工具调用 JSON)过了才算
- 坑是最大的资产——每个坑记下来(症状→根因→解法),第二次部署 2 小时变 20 分钟
延伸方向(有基础的人可以继续)
- vLLM 路线:官方 fork + 预编译 wheel(VLLM_USE_PRECOMPILED=1),INT4 单机方案
- 投机解码:--speculative-algorithm NEXTN(模型自带 MTP 层,不需要 draft 模型),降延迟
- 吞吐调优:--max-running-requests 从 1 提到 64,多并发下吞吐大幅提升
- 终极容量:FP4 双机 = 35GB 权重/台 → KV 池 ~888K,接近 1M 上下文
- LLM 能力边界:Ling-3.0-flash 用 12.4% 的参数对齐 1T 旗舰——小模型 + 好架构 + 量化,正在把「本地 124B」变成个人开发者的现实选项
技术细节可参考 github.com/inclusionAI/ling-cookbook 的 dgx-spark 部署指南。