
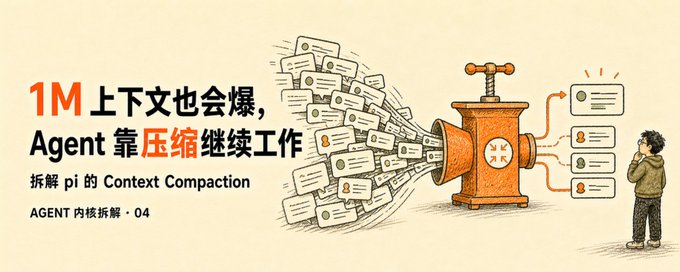
【Agent 内核拆解】系列文章第 4 篇:Pi 上下文压缩的那些事
这个系列我会对照三个开源 coding agent,分别是 OpenAI codex(101k star)、xAI grok-build(23k star)和 earendil pi(78k star),一层层拆它们的内核,最后带你从零写一个自己的。
前三篇拆完了 agent 的三层结构,while 循环、模型调用、工具执行。mini-agent 到这一步已经能干活了。
用一段时间就会遇到一个问题:你让 agent 在一个项目里连续工作,读了十几个文件,改了七八处代码,来回对话几十轮。每一轮请求都要把之前所有消息原文发给模型,对话历史不断增长。
现在主流旗舰模型的 context window 已经到了 1M token(Claude Opus 4.8、GPT-5.6、Gemini 3.x),但窗口再大也是有限的,一个复杂项目连续工作几个小时照样能填满。
接近上限时 API 直接报错,agent 停转。模型没有能力自己清理历史,它每次调用只能看到系统塞给它的那段 context,不知道窗口快满了。
pi 的解决办法叫 compaction。旧对话用 LLM 总结成一段摘要,最近几千 token 原文保留,用摘要替代更早的历史。
https://earendil.com/posts/compaction-in-pi/什么时候压缩
pi 在每轮对话结束后检查 context 占了多少 token,判断条件就一行。
## Goal
## Constraints & Preferences
## Progress (Done / In Progress / Blocked)
## Key Decisions
## Next Steps
## Critical Context
reserveTokens 默认 16384。1M 窗口的模型,context 超过大约 983k 时触发。
还有一种更紧急的情况,API 已经返回了 context overflow 错误。pi 在 overflow.ts 里维护了大约 25 种正则,覆盖了主流 provider 的报错格式(Anthropic 的 "prompt is too long"、OpenAI 的 "exceeds the context window"、Google / xAI / Groq 各有各的写法)。
有的 provider 不报错而是静默截断输入,pi 通过检查 usage 里的 input tokens 是否超过 context window 来检测。
The conversation history before this point was compacted
into the following summary:

<summary>
## Goal
重构 auth 模块 + 添加 OAuth 登录
## Progress
### Done
- [x] 基础 auth 重构完成,测试通过
### In Progress
- [ ] OAuth 集成

<read-files>
src/auth.ts
src/routes.ts
</read-files>

<modified-files>
src/auth.ts
</modified-files>
</summary>
两种情况的处理方式不同:阈值触发后压缩完就停下来,等用户发下一条消息,因为上一轮回复用户已经看到了;溢出触发后多做两步,先删掉那条失败的 assistant message(保留在历史里,但不带进 context),然后压缩完自动重试用户的请求。
用户看到的效果是 agent 卡了一下继续工作。溢出恢复只尝试一次,压缩后还溢出就放弃,告诉用户换个更大 context 的模型。
token 估算的做法也值得提一下。pi 优先用 provider 报回来的真实 usage(每条 assistant message 自带),对 usage 之后新增的消息用字符数除以 4 做粗估。
虽然不是那么精确,但够用。估低了无非晚触发一点,后面溢出检测能兜底。估高了反而触发太频繁,每次压缩都要额外花一次 LLM 调用的钱。
保留多少,怎么切
触发之后第一步是找切割点。pi 从消息列表末尾往前扫,累加每条消息的估算 token 数,累计到"保留最近消息"的阈值(默认 20000 token)就停下来。
切割要落在合法的消息边界上。用户消息、助手消息的起始位置都算合法。工具结果不算,因为它必须紧跟助手的工具调用,拆开会让模型看到一个没有结果的调用。
切割点之前的消息进入摘要,之后的消息保持原文。大约保留最近 5 到 20 轮对话。
摘要怎么生成
pi 把要压缩的消息序列化成纯文本,格式很简单。
https://github.com/yanhua1010/build-your-own-coding-agent然后送给 LLM,要求按一个固定的结构化格式输出摘要。
function shouldCompact(contextTokens, contextWindow, settings) {
  return contextTokens > contextWindow - settings.reserveTokens;
}系统提示词明确告诉模型"你是一个 context summarization assistant",只输出摘要,不要继续对话。这一步是让模型换一个角色工作,防止它把摘要当成对话的一部分继续回复。
如果之前已经做过一次压缩(有旧摘要),pi 把旧摘要包在 <previous-summary> 标签里一起发给模型,让它在旧摘要基础上增量更新,保留旧信息、添加新进展、把完成的条目从 In Progress 挪到 Done。
摘要完成后,pi 在末尾追加两个 XML 标签 <read-files> 和 <modified-files>,列出被压缩区间内所有的文件路径。这些信息从 assistant 的 toolCall 参数里直接提取(read/write/edit 工具的 path),不靠模型记忆。
下一次压缩时继承上一次的文件列表再累加新的,这个设计让模型在压缩之后仍然知道"之前读过、改过哪些文件",要用的时候 read 一下就行。
压缩之后 context 长什么样
压缩后 context 里旧对话消失了,取而代之的是一条用户消息。

最近的消息原文紧跟在后面,模型看到这条 summary,知道工作进度和文件列表,可以根据摘要继续工作。
pi 还对外开放了扩展钩子 session_before_compact,扩展可以取消压缩或者用自定义逻辑替代默认行为。它自带的一个示例用 Gemini Flash 做摘要,比主对话模型便宜。
自己写一遍
配套代码在文末仓库的 steps/04,在上一篇基础上新增了 compaction 相关的模块。
几个建议自己跑的场景。
设一个小窗口。 把 CONTEXT_WINDOW 设成 8192(8k),让 agent 做几轮对话就会触发压缩。可以观察压缩前后 context 的变化。
跑 demo-compaction.mjs。 不需要 API key,用预置的长对话历史模拟压缩过程,能看到切割点的选择、保留了哪些消息、摘要的格式。
让 agent 连续读很多文件。 指向一个有几十个源文件的目录,让 agent 逐个读取并总结。到快满时观察摘要里的 <read-files> 和 <modified-files> 列表。
接下来讲什么
这一篇加上前三篇,把 coding agent 从"能跑"推到了"能持续工作"。
下一篇讲权限与安全:agent 凭什么敢替你执行 shell 命令?sandbox、路径隔离、beforeToolCall 是怎么配合的。
研读笔记、图解和配套代码都放在下面这个仓库,每篇文章对应一步可以直接运行的代码,接 DeepSeek 或 GLM 的 API 就能跑。
https://github.com/yanhua1010/build-your-own-coding-agent
想第一时间看更新,关注我 --> @yanhua1010
本文引用的 pi 源码遵循 MIT License,版权归 earendil-works 所有。
参考文章:https://earendil.com/posts/compaction-in-pi/