
16G显卡部署7.9B Ling3模型,本地API流畅实测
最近体验了一下刚开源的 Ling-3.0-tiny。它是一款总参数量 7.9B、每个 Token 仅激活约 1.3B 参数的原生混合推理模型,同时提供 BF16、FP8 和 INT4 三个版本。
相比单纯追求参数规模,我更关心的是:这种激活参数很小的模型,能不能在消费级显卡上真正跑起来,并通过本地 API 接入自己的应用。因此这次我选择 INT4 版本,在 Windows 11 + RTX 5060 Ti 16GB 上完成了一次本地部署。
下面记录完整过程。目标很简单:把模型服务启动起来,并实际调用一次 OpenAI 兼容接口。
本次实测环境
本次实测环境
- 推荐 16GB 或以上显存
- windows 11
本文实测配置为 Windows 11、RTX 5060 Ti 16GB 显卡和 32GB 内存。不同驱动、CUDA、WSL 与 vLLM 版本可能会影响实际结果。
```Plain Text
pip install uv

uv venv ~/my_ling_env

source ~/my_ling_env/bin/activate

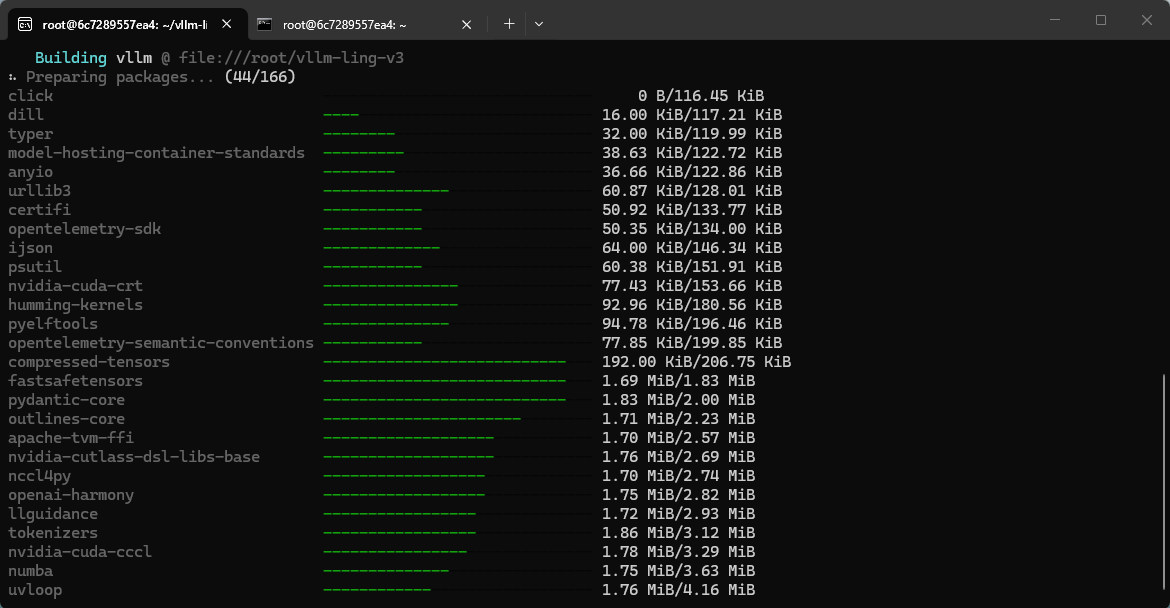
git clone -b ling_3_0 https://github.com/inclusionAI/vllm-ling-v3.git

cd vllm-ling-v3

VLLM_USE_PRECOMPILED=1 uv pip install --editable . --torch-backend=auto
```
一、准备 Windows 本地环境
1. 安装 WSL
打开 Terminal:输入 wsl --install 并回车,系统会自动启用所需功能、下载内核并安装 Ubuntu 发行版
curl -LsSf https://hf.co/cli/install.sh | bash命令执行完毕后,根据提示重启计算机使配置生效
检查安装情况
```Plain Text
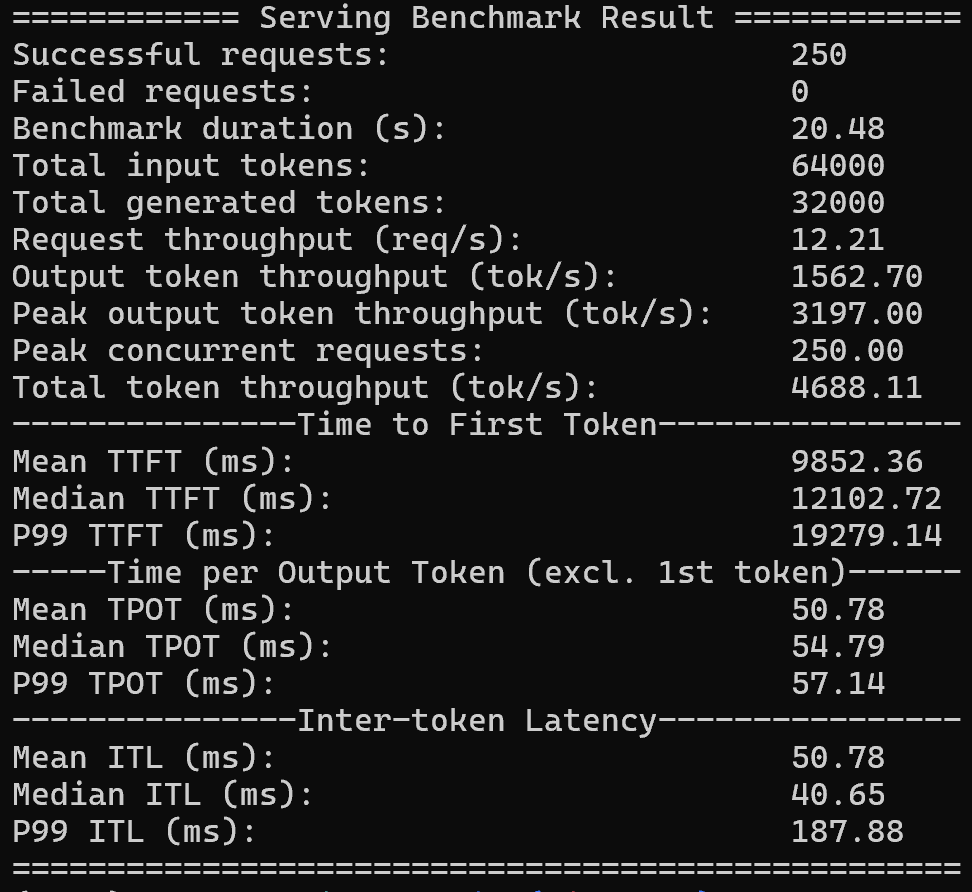
指标        数值
成功请求数        250
失败请求数        0
压测时长        20.48 s
总输入 Token        64,000
总生成 Token        32,000
单请求平均输入        256 tokens
单请求平均输出        128 tokens

指标        数值
请求吞吐量        12.21 req/s
输出 Token 吞吐量        1,562.70 tok/s
峰值输出 Token 吞吐量        3,197.00 tok/s
峰值并发请求数        250
总 Token 吞吐量(输入 + 输出)        4,688.11 tok/s
```
2. 安装 Python
Ubuntu 通常已经带 Python 3
先检查:
```Plain Text
python3 --version
```
例如可能显示:
安装完整的常用 Python 开发组件:
hf download inclusionAI/Ling-3.0-tiny-int4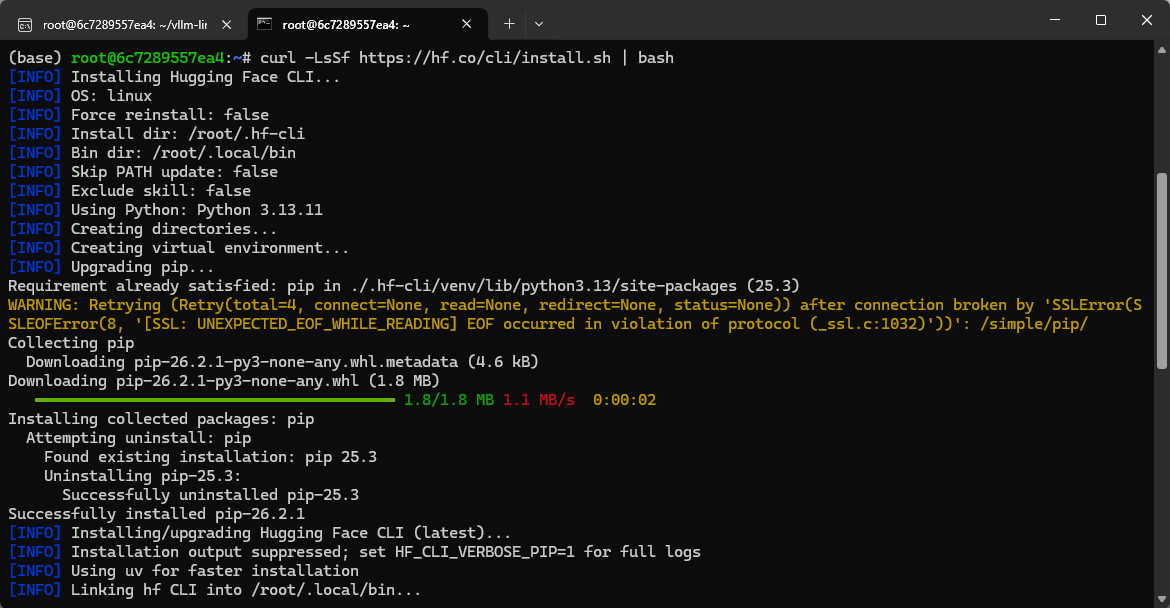
二、下载 Ling-3.0-tiny INT4
先安装 Hugging Face CLI,用它从 Hugging Face 下载模型权重。
1. 安装 Hugging Face CLI
安装完成后,可以运行 hf --help 检查命令是否可用。
2. 下载 INT4 模型
这次使用的是 inclusionAI/Ling-3.0-tiny-int4。INT4 版本占用更低,更适合在 16GB 消费级显卡上尝试本地部署。
```Plain Text
Python 3.12.x
```
三、安装并启动 Ling-3.0-tiny
1.创建环境并安装官方适配版 vLLM


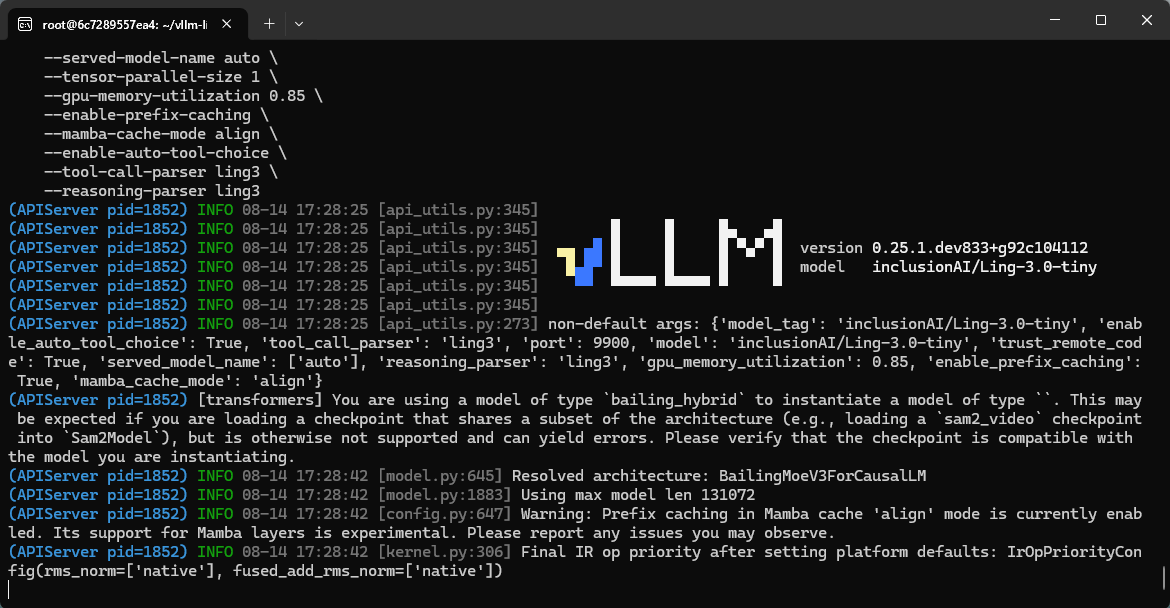
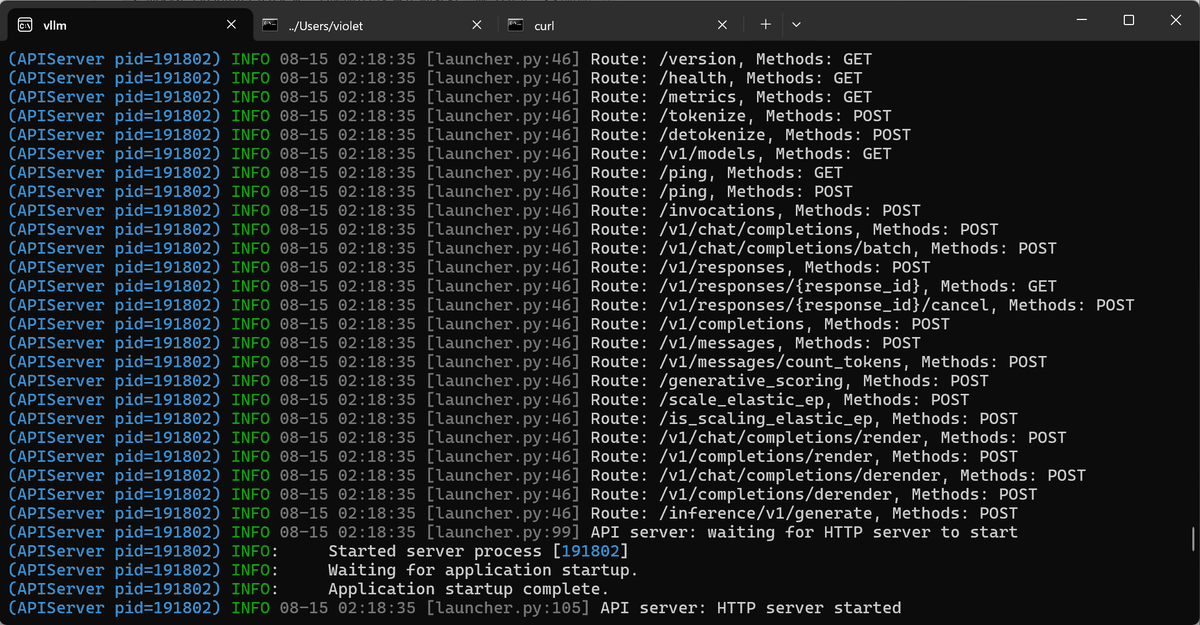
2. 启动本地 API 服务
```Plain Text
sudo apt install python3 python3-pip python3-venv -y
```
wsl --installcurl -s http://127.0.0.1:9900/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{"model": "auto",
"messages": [{"role": "user", "content": "请介绍一下你是什么模型,并用三句话说明你的特点。"}],
"chat_template_kwargs": {"enable_thinking": true},
"stream": true,
"temperature": 1.0,
"top_k": 20,
"top_p": 0.95
}'四、实际测试:调用本地 API
另开一个 Terminal:
vllm serve inclusionAI/Ling-3.0-tiny-int4 \
    --port 9900 \
    --trust-remote-code \
    --served-model-name auto \
    --tensor-parallel-size 1 \
    --gpu-memory-utilization 0.85 \
    --enable-prefix-caching \
    --mamba-cache-mode align \
    --enable-auto-tool-choice \
    --tool-call-parser ling3 \
    --reasoning-parser ling3
如果终端持续返回模型生成的 JSON 内容,就说明 Ling-3.0-tiny 已经在本地运行,并通过 OpenAI 兼容接口完成了一次真实调用。
五、本地体验结论
这次部署最直观的感受是:轻量模型已经不只是“能塞进本地设备”,而是可以提供一套能够直接调用的 API 服务。Ling-3.0-tiny 每个 Token 激活约 1.3B 参数,INT4 版本在我的 RTX 5060 Ti 16GB 上成功启动,也完成了带 thinking 配置的对话请求,并进行了输入输出的测速如下
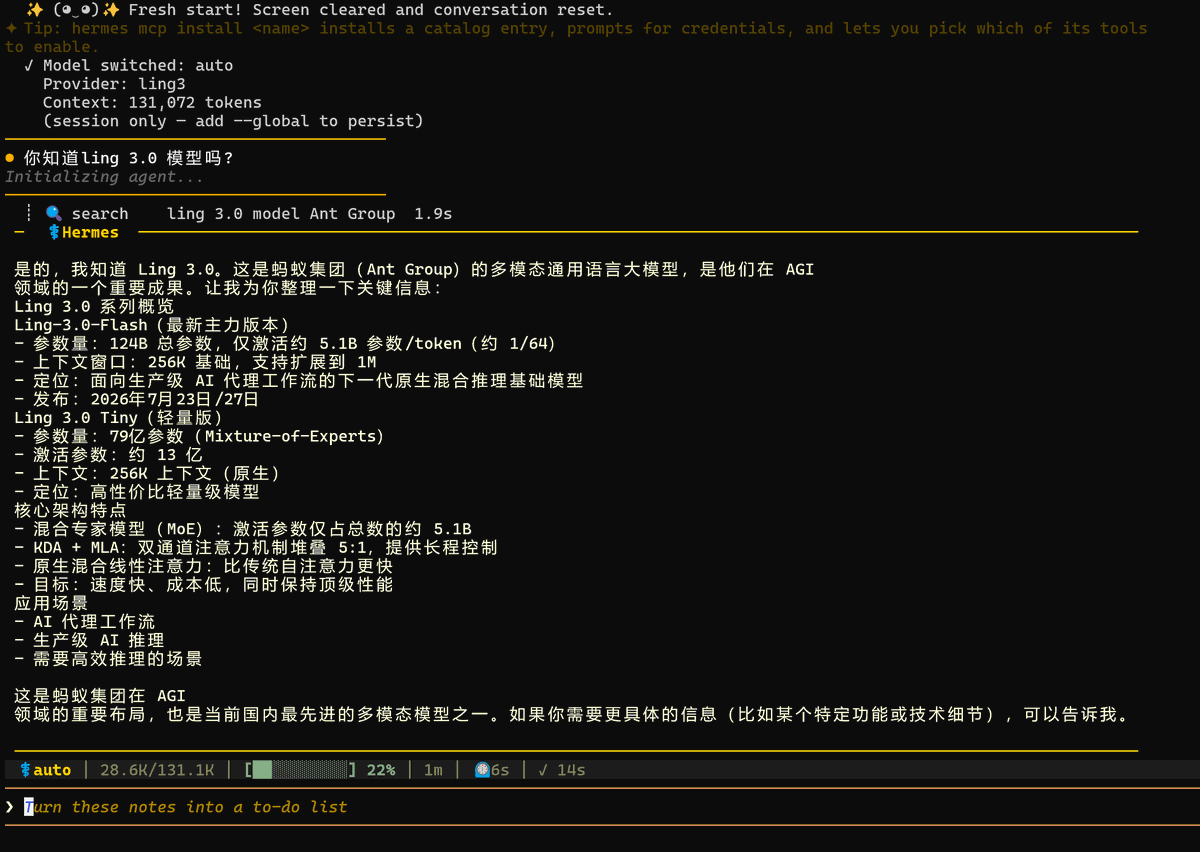
用hermes接入
wsl --status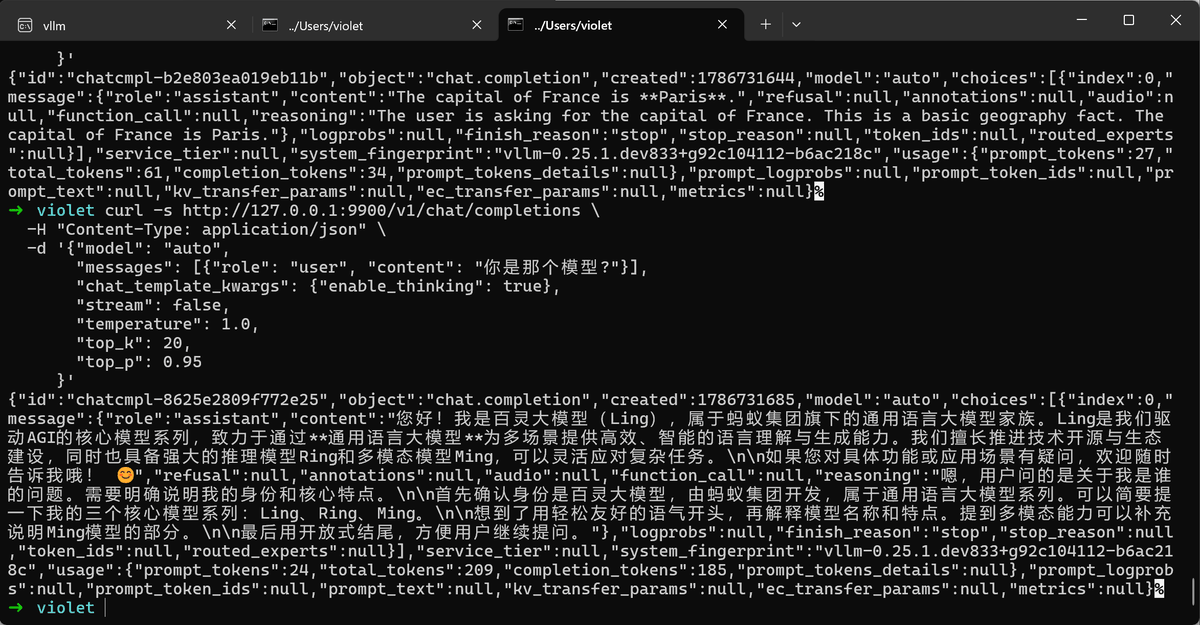

它当然不能代替所有大型云端模型,但对于本地知识处理、代码辅助、隐私敏感任务,以及想自己搭建轻量 Agent 的开发者来说,这种低激活参数、可本地部署的模型很值得体验。
模型地址:Ling-3.0-tiny-int4 on Hugging Face
一句话总结:一张 16GB 消费级显卡,就能把 Ling-3.0-tiny 的 INT4 版本跑起来,并通过 OpenAI 兼容接口接入自己的应用。