
AIPC:选 DGX Spark 还是 AMD 395?
一台是英伟达的 DGX Spark,国行已涨到 3.5 万;一台是 AMD 395 芯片的小主机,也涨到接近 2 万。都能在桌面上跑大模型,有啥区别?

第 1 章 这俩到底是什么东西
2026 年上半年,桌上跑 AI 这件事突然冒出来两个明星产品,天天被人拿来比。要看懂后面的对比,先得知道它俩各是什么来路。
1.1 DGX Spark:英伟达把机房搬上桌
DGX Spark 是英伟达出的一台小盒子,官方叫它「桌面 AI 超级计算机」。
用大白话讲,英伟达平时卖给大公司机房的那种 AI 芯片,缩小塞进一个巴掌大的盒子,摆你桌上。
它里面装的是一颗叫 GB10 的芯片,英伟达自己起名叫 Grace Blackwell。 这颗芯片把 20 核的 CPU 和一块显卡焊在一起,配了 128GB 内存。
价格一路在涨,目前京东已经来到了 36000。
卖点主要是一句话:让你在自己桌上,用跟机房同一套技术跑大模型。
1.2 AMD 395:一颗芯片顶一台主机
另一台的核心是 AMD 的一颗芯片,全名 Ryzen AI Max+ 395,江湖外号 Strix Halo。
它不是一台固定的机器,而是一颗芯片,被装进各家厂商的迷你主机里卖。 国外常见的是惠普 Z2 Mini、Framework 桌面机,国内常见的是零刻 GTR9 Pro、极摩客 EVO-X2 这些。
这颗芯片里塞了 16 核 CPU 和一块不小的集成显卡(叫 Radeon 8060S),同样配到 128GB 内存。
随着内存的全面涨价,目前价格也逼近了 2 万元。
它与 DGX Spark 完全不同。 DGX Spark 是「机房技术下放」,AMD 395 是「笔记本芯片往上顶」,一颗本来给高端笔记本用的芯片,做大做强,做到能跑大模型。
1.3 它俩为什么被摆在一起比
两台机器出身不同,却总被拿来对比,因为它们干的是同一件事,而且用了同一招。
这一招叫统一内存。
普通电脑里,内存和显存是分开的两块。 显卡干活只能用显存,而显存通常不大,8GB、16GB 就到头了,装不下大模型。
统一内存就是把这堵墙拆了,让 CPU 和显卡共用同一大块内存。
每秒出字上限 = 内存带宽 ÷ 模型占的空间DGX Spark 和 AMD 395 都用了这招,都配 128GB,都能把一个 70B 的大模型整个装进去。 这是消费级显卡想都不敢想的。
苹果的 Mac 也是这么干的,M 系列芯片一直用统一内存,所以买 Mac 内存能大就大。
第 2 章 这两台机器都能干什么
很多人纠结买哪台,其实还没搞清楚买回来能干嘛。
2.1 能干的事
问题一:你要跑的,是不是别人已经打包好的现成模型?

├─ 是(装个软件,点一下下载,开聊)
│   │
│   └─ 问题二:你会不会经常一次扔进去几万字的资料?
│       ├─ 会 ──────────────────────► DGX Spark
│       └─ 不会 ────────────────────► AMD 395
│
└─ 否(要自己微调、改底层、复现论文)
    │
    └─ 问题三:你写的代码,之后要不要部署到英伟达的服务器上?
        ├─ 要 ──────────────────────► DGX Spark
        └─ 不要 ────────────────────► 先看 6.3,你可能两台都不该买
你的数据不出门。 合同、病历、财务表、没发表的稿子,扔进本地模型,不会有任何一份传到别人的服务器上。这是云端 AI 给不了的。
没有月租,没有次数限制。买断之后想跑多少跑多少,半夜挂着让它处理一万份文件也不多花一分钱。
2.2 能跑多大的模型
两台的内存都是 128GB,其中大约 96GB 能给显卡当显存用,这是它俩共同的核心卖点。
对比一下就知道这个数字什么概念:

**花 RTX 5090 的钱甚至更少,拿到三倍的「显存」,这就是这个品类存在的全部理由。
2.3 两台都干不了的事
这一节比上一节重要,因为它决定你是不是根本不该买。
一、画图和生成视频,基本告别。
本地跑图片和视频生成,软件生态几乎全绑在英伟达那套叫 CUDA 的东西上,而且吃的是显卡算力,不是内存容量。
AMD 这台跑得磕磕绊绊,插件和模型很多直接用不了。 DGX Spark 虽然是英伟达自己的,但它用的是手机那一族的芯片架构,很多现成软件也装不上。
想在本地画图,你该买的是一张英伟达独立显卡,不是这两台里的任何一台。
二、稠密模型跑得很难受。
大模型分两种干活方式:
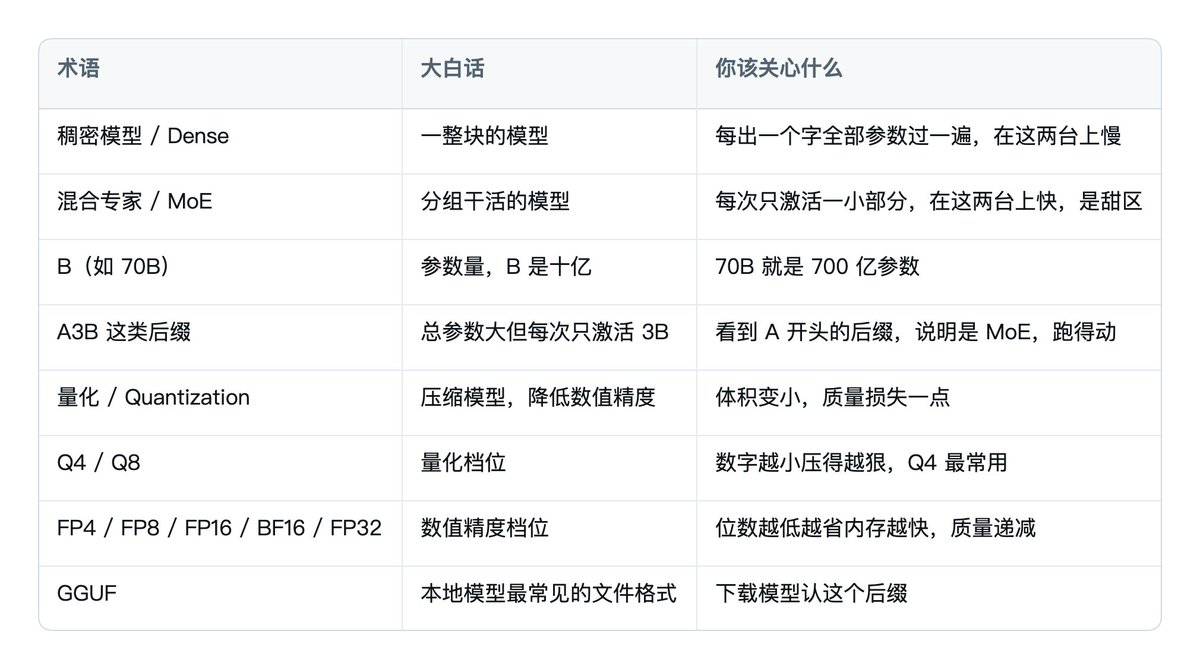
MoE 这个词你在模型名里会经常见到。Qwen 那个 A3B 后缀就是这个意思:总参数很大,但每次只激活 3B,所以跑得动。
有测评机构(LMSYS)实测 DGX Spark 跑 Llama 3.1 70B,出字速度只有 每秒 2.7 个字。你读字的速度比它吐字快好几倍,全程干等。
很多人买这两台的唯一理由就是「能跑 70B」,能跑,和能用,这是两件事。
反过来,1200 亿参数的 GPT-OSS 120B 因为是分组干活的,反而能跑到每秒 38 个字。为什么参数更多反而更快。
所以这两台机器真正的甜区,是「分组干活」的模型,不是参数量写着最大的模型。
三、它们跑不出云端旗舰模型的水平。
本地能跑的模型,跟你在网上用的那些最强的模型,中间还是有差距。 买这个是为了数据安全、断网可用、不限次数,不是为了更聪明。
期待值放对,你才不会失望。

第 3 章 差别到底在哪
看评测最容易犯的错,是只盯着「每秒多少字」这一个数。
你会发现有人说这两台差不多,有人说贵的那台快五倍,两种说法都能找到评测支持。 它们其实都对,只是在说不同的事。
3.1 AI 干活分两步
AI 回答你一个问题,中间干的是两件完全不同的活。
第一步叫读题:把你发过去的所有文字,包括提问、贴进去的资料、之前的聊天记录,一次性全部读完理解完。评测里写作 prefill 或者 prompt processing,中文译作预填充。
第二步叫出字:理解完了,开始一个字一个字往外吐。评测里写作 decode 或者 token generation,中文译作解码。
用你的实际体感对一下就清楚了:
你按下回车,光标在那闪着什么都没出来的那几秒,机器在读题。 开始往外蹦字了,机器在出字。
DGX Spark:273 GB/s ÷ 40GB ≈ 每秒 6.8 次
AMD 395:  256 GB/s ÷ 40GB = 每秒 6.4 次
为什么这两步吃的东西不一样?
读题的时候,你给的所有字是一次性摆在那的,机器可以同时算一大片,谁算得快谁赢,这是拼算力。
出字的时候没这个便宜可占。 每吐一个字,显卡都必须把整个模型从头到尾完整读一遍,读完才知道下一个字是什么。 吐一百个字就要读一百遍。 这时候拼的不是算得多快,而是数据从内存搬到显卡有多快,也就是带宽。
用大白话讲,读题像用水泵抽水,看泵的功率; 出字像用吸管喝水,看管子有多粗。 泵再强,吸管细,一样喝得慢。
3.2 出字速度:两台几乎一样
因为出一个字就要把整个模型完整读一遍,所以出字速度有一个谁都突破不了的上限:
举个例子。一个 70B 的模型(700 亿参数,B 就是十亿),做过量化之后大约占 40GB。
量化就是把模型压缩一遍,把每个参数的数值精度降低,体积随之变小,质量损失一点点。 你下载模型时看到的 Q4、Q8 就是量化档位,数字越小压得越狠。 Q4 是目前公认质量和体积最平衡的一档,本篇的计算都按它来。
实际跑不满,打个六到七折,两台都是每秒四五个字的水平。
这个算式里藏着本篇最反直觉的结论:
这两台机器的带宽只差 6%,所以它们的出字速度也只差 6% 左右。 多花两万块,一个字都不会多出。
带宽这道墙有多硬,看一眼横向对照就明白了:

三张二手 3090 的总价比 DGX Spark 便宜,出字快三倍多。
这不是因为 3090 多先进,是内存种类不同。表里的 GDDR6X 是显卡专用显存,为带宽而生;LPDDR5X 是笔记本用的低功耗内存,为省电和容量而生。这两台小主机为了塞下 128GB 只能选后者,容量换来了,带宽就得让。
顺便说一个单位上的事:评测里的单位是 token(词元),不是「字」。 token 是模型处理文字的最小单位,一个汉字大约算 1 到 2 个 token,一个英文单词大约 1.3 个。 本篇为了好懂一律说成「字」,你看评测时心里换算一下就行。
3.3 读题速度:差五到六倍
带宽这一项两台打平,那多花的两万块花在哪了?花在读题上。
读题吃算力,而这两台机器的显卡完全不是一个级别。 有一个流传很广的类比,我觉得是最准确的一句总结:
DGX Spark,约等于一张省电版的 RTX 5070,配了 128GB 内存。
AMD 395,约等于一张 RX 7600 XT,配了 128GB 内存。
实测数字,第一组跑 GPT-OSS 120B,用 llama.cpp:

第二组跑 30B 级别的模型:

两组测试同一个结论,跟上面那个公式推出来的也完全对得上:
读题差五到六倍,出字差一成多。
还有一条更关键的:你给的资料越长,Spark 的优势越大。
这里要引入一个你一定会碰到的词:上下文(context)。 指的是模型一次能看见的全部文字,包括你的提问、贴进去的资料和之前的对话。 评测里用 2K、32K、128K 标注,单位是 token,32K 大约是三四万汉字。
短提问(2K 上下文)的时候两台的出字速度几乎一样。 上下文拉到 32K,Spark 的领先幅度会再扩大一倍以上。
3.4 这个差别翻译成你的日常

这张表是全篇最重要的一张。 最后一章那张「你该买哪台」的决策表,本质上就是把它换了个说法。
3.5 参数对照

表里有两行需要翻译。
ARM 架构和 x86 架构。 你现在这台 Windows 电脑用的是 x86,全世界的软件都是给它编译的。 DGX Spark 用的是 ARM,跟手机、跟苹果 M 系列芯片同族。 这意味着一部分软件没有现成能装的版本,要自己编译,甚至根本装不上。
CUDA、ROCm 和 Vulkan。 这三个是让显卡干 AI 活的软件底座。 CUDA 是英伟达的,一家独大; ROCm 是 AMD 对标 CUDA 的那一套; Vulkan 是跨厂商的通用方案,谁家显卡都能用,但优化不如前两个专。 AMD 这台上 ROCm 和 Vulkan 都能跑,各有各的快。
差别摊开了,下面分别说两台各自的好和坏。

第 4 章 DGX Spark 的优点和缺点
4.1 优点一:读题快五到六倍
这是它唯一一个硬性的性能优势,但含金量很高。
因为你越是把 AI 当生产工具用,就越会往里塞大段资料。 读整个项目的代码、读几十份文档、让它连着自动跑一长串任务,这些场景全部卡在读题上。
日常聊天感受不到这个差距,在工作场景里,这个差距就是「等三秒」和「等二十秒」的区别,一天下来很要命。
4.2 优点二:软件不用等
英伟达那套让显卡干 AI 活的软件底座叫 CUDA。
它值钱的地方不在技术,在于全世界的 AI 教程、代码库、论文附带的脚本,默认都是给它写的。
你在网上看到一份「三行命令跑通某模型」的教程,那三行命令背后大概率就是 CUDA。 换成 AMD 的机器,这三行不一定能用,你得自己找替代方案,或者等社区适配。
DGX Spark 卖的就是这个「不用等」。它开箱预装好 Docker(一种把软件连环境一起打包的工具,装 AI 软件时能省掉大量配置),英伟达官方给了一整套现成的操作手册,Ollama、LM Studio、vLLM、SGLang 这些主流推理引擎在它发售当天就全部适配好了。
但这件事有个很重要的反面,我必须说清楚:
如果你只是想跑现成的模型,你这辈子碰不到 CUDA。
装个 LM Studio 或者 Ollama,点几下下载模型,开聊。 这套流程在 AMD 那台上一样顺,你根本不会知道底下用的是哪套东西。
所以它的价值,取决于你是「用模型的人」还是「折腾模型的人」:
最后一行是它真正的产品定位。它是卖给那些要往几十万美元一台的英伟达服务器上部署代码的开发者,让他们在桌上用同一套工具先跑通。
4.3 优点三:两台能连起来,跑一台装不下的模型
DGX Spark 背后有两个 QSFP 光口,标称 200Gb,背后是一颗 ConnectX-7 网卡。 拿一根线把两台机器直连,就能当一台用,术语叫组集群。
这是AMD 那台完全做不到的事。 光讲参数没感觉,讲一个 2026 年下半年社区玩疯了的例子。
这个模型一台装不下
2026 年 7 月 31 日,DeepSeek 开源了 DeepSeek-V4-Flash-0731,免费商用。
总参数 2840 亿,但每出一个字只激活其中 130 亿。所以它在这种带宽受限的小机器上是跑得动的,它的上下文能到 131 万 token,免费商用。
问题出在装不装得下。官方 FP8 精度的原版权重约 149GB,分成 46 个文件。
而一台 DGX Spark 只有 128GB,实际可用还要再少一点。
差的这二十来个 GB,就是那两个光口全部的意义。两台连起来 256GB,用张量并行(Tensor Parallel,简称 TP,就是把模型横着切两半各放一台)装下 149GB 之后,还剩一大截放上下文缓存。
社区实测跑出来什么样
数字跨度大,是因为推理引擎版本、上下文长度、有没有开投机解码都不一样:

表里有两个词要解释。
投机解码(speculative decoding):让一个小模型先草拟几个字,大模型一次性批量验证,猜对了就白赚,猜错了推翻重来。这是目前提升出字速度最有效的软件手段之一,能到 1.5 倍以上。这个模型自带的那个模块叫 DSpark,跟 DGX Spark 没有任何关系,纯属撞名。
并发:多少个人同时向它提问。单流是一个人用,16 路并发是 16 个人同时用,后者的总吞吐远高于单流,因为读题那一步可以批量做。
最后一行值得单独说。有人的光口线缆不兼容,退而求其次用机器自带的万兆网口连,照样跑起来了。所以那两个光口不是「能不能跑」的问题,是「快多少」的问题,大约差一倍。
三条必须讲的代价
一、标称 200Gb,真正能用上的差得远。
走普通 TCP 协议实测只有 106Gb。改用 RDMA(一种绕过 CPU 和操作系统、直接把数据写进对方内存的传输方式,这里用的是它的以太网版本 RoCE v2),裸带宽能压到 197Gb。
但跑起模型来,两台之间真正的有效通信带宽只有约 10 GB/s。因为模型每算完一层就要同步一次数据,这一步走的是 NCCL 集合通信,实测能跑满的部分远低于裸带宽。
根因是每个光口后面只挂了 PCIe 5.0 的 x4 通道,物理上就喂不满。插一个口就已经到平台上限,第二个口是给你换拓扑用的,不是加带宽的。
二、读题依然是老大难,而且更慢了。
出字速度上去了,读题没有。实测 32K 上下文冷启动要等 53 秒;128K 要等约 250 秒;512K 要等 334 秒。这个指标叫首字延迟(TTFT),衡量你按下回车到第一个字冒出来的时间。
也就是说你扔一份长文档进去,先泡杯茶。 加上容器启动到能对外服务要六到九分钟,这不是一台你想用就用的机器。
三、价格直接翻倍。
两台原厂约 9500 美元,国行要六到八万。 省钱的办法是买华硕、技嘉那些同芯片的版本,能便宜三分之一。
所以这个优点对谁成立

准确的说法是:它解锁的是一个 AMD 那台根本进不去的档位,但门槛是六万块和一份几千字的配置文档。
4.4 缺点:四条真实的翻车记录
下面这些全部来自真实用户的公开记录,不是我编的。
翻车一:软件装不上,因为它是 ARM 架构。
有位开发者拿到机器后想装 PyTorch(最主流的 AI 开发框架),发现 2.7 版本有编译好的 ARM 安装包,2.8 版本找不到。 很多现成的教程和库默认你是 x86 电脑,在这台机器上直接卡住。
本质是:CUDA 生态确实成熟,但「CUDA 加 ARM 加最新的 Blackwell 架构」这个组合是全新的,成熟度要另算。官方给的解法是全程用他们提供的 Docker 容器,别自己装。
翻车二:FP16 推理算出来是空白,而且报错骗人。
有位工程师连着微调了五个模型,每次加载评估都输出空白,甚至报 inf/nan 数值溢出错误。他花了 15 个小时怀疑自己的训练代码写错了。
最后发现训练全是好的,问题出在推理时用了 FP16 这一档精度,这台新硬件在 FP16 上有数值稳定性问题。换成 BF16(跟训练时一致的那档)或者放到 CPU 上用 FP32 算,输出完全正常。
本质是:新硬件的毛病不会明说,它伪装成你自己的 bug。经验法则是训练和推理用同一档精度,在这台机器上就统一用 BF16。
翻车三:长时间训练会把整机拖死。
同一位工程师的第六次实验,跑到 7.5 小时、进度 88% 的时候,整台机器冻死。键盘没反应,SSH 连不上,只能硬重启,进度全丢。
原因是显存碎片化:长时间训练反复申请释放内存,剩余空间被切得七零八落,最后凑不出一块连续的来。之后他被迫加了一堆保护措施:每 50 步清一次缓存、每次训练不超过 2.5 小时就主动存档退出、全程盯着显存占用。
本质是:这台机器不适合「晚上挂着跑一夜」。你得盯着它。
翻车四:系统只承诺两年更新。
英伟达给这台机器配的是 DGX OS(基于 Ubuntu 魔改),官方文档里写明只保证两年更新。普通 Ubuntu 长期支持版是五年,加钱能到十年十五年。
而且这是唯一官方支持的发行版。有人试过装别的,但内核还是得用英伟达的。
本质是:一台三万块的设备,官方只给两年软件保障,而英伟达在老硬件的长期支持上记录并不好看。
4.5 缺点:不跑模型的时候,它不好用
这条容易被忽略,但对一台放在你家书桌上的设备很重要。
DGX Spark 不跑模型的时候,是一台 ARM 架构的 Linux 机器。你熟悉的那些 Windows 软件,大部分装不上。它不是一台你能当日常电脑使的机器。
另外还有一条实测:约翰·卡马克(做《毁灭战士》那位,现在转做 AI)测出这台机器最高只吃到 100W 电,不到标称 240W 的一半,性能也大约只有标称的一半,而且这样都已经烫得厉害,还有人报告长时间跑会自动重启。
第 5 章 AMD 395 的优点和缺点
5.1 优点一:便宜一半,出字却不慢
这是它最硬的一条。
一万三对三万五,差价两万多。而第 3 章已经算清楚了,出字速度只差一成多。
如果你的用法是日常聊天、翻译、写东西,一次给它几百字,那么这两万块钱买不到任何你能感知到的东西。
5.2 优点二:不跑模型的时候,它是台正常电脑
这条比很多人想的重要。
AMD 395 这台,你不跑模型的时候,就是一台完整的高性能 Windows 电脑。 办公、剪片、打游戏都行,那颗集成显卡的性能大致在 RTX 4060 移动版这个档。
也就是说,你花一万三买的不只是一台 AI 机器,还是一台能顶替你现有主机的电脑。 DGX Spark 做不到这一点。
5.3 优点三:省电、安静、随便折腾

想 24 小时挂着当家里的 AI 服务器,AMD 这台的电费和心理负担都小。
5.4 缺点一:读题慢五到六倍
这是它的硬伤,而且软件优化补不上,因为差在显卡算力上。
具体后果:你扔一份几万字的资料进去,AMD 这台要等的时间是 Spark 的五六倍。偶尔用一次能忍,天天这么用会疯。
AMD 这边也在追。他们那套对标 CUDA 的软件叫 ROCm,成熟之后读题速度比走 Vulkan 通用方案快了约 20%。但追近了不等于追上,五倍的差距还在。
5.5 缺点二:软件永远慢半年
这颗芯片 2025 年初就发布了,但 AMD 直到当年 9 月底的 ROCm 7.0.2 才给出预览级别的支持。有测评机构原计划测它的 AI 性能,因为软件没到位,整块内容只能砍掉延后。
本质是:AMD 的硬件经常先到,软件慢半年到一年。
你买的时候要问一句「现在软件到位了吗」,而不是看发布会。
5.6 缺点三:有些活得你自己挑方案
AMD 这边跑模型有两套后端可选:ROCm 和 Vulkan。 ROCm 读题快 20%,Vulkan 在长上下文(32K 以上)时出字快 1.8 倍。没有一个全面胜出。
也就是说买了这台,你多了一道功课:同一台机器装两套后端,各跑一遍,看自己的活儿哪个快。选错了白丢一半性能。
这种事在 DGX Spark 上不存在,CUDA 一条路走到黑。
5.7 缺点四:高级玩法门槛很高
想拿两台 AMD 395 组集群跑更大的模型,看看社区那份公开指南要求你干什么:
自己买 100GbE 网卡(Framework 主板的 PCIe 插槽只有 x4,还得配转接卡)、装指定内核版本的 Fedora 43、进 BIOS 把核显显存改成最小的 512MB、往内核启动参数里加 iommu=pt、pci=realloc 这类四五条配置、再给 RCCL(AMD 那套对标 NCCL 的集合通信库)打一个自己改的补丁,最后用 vLLM 加 Ray 把两台编排起来。
Spark 那边是插上一根线。
本质是:AMD 这边高级玩法的门槛不在钱,在时间和折腾能力。
5.8 两台的优缺点对照
一句话总结这张表:
Spark 买的是读题速度和省心,AMD 买的是价格和通用性。

第 6 章 你该买哪台
6.1 三个问题定生死
不用看跑分,回答三个问题就够了。

问题一分的是「用模型的人」和「折腾模型的人」。 问题二分的是「读题吃紧」还是「出字吃紧」。 问题三分的是「这台机器是生产工具」还是「玩具」。
6.2 决策表
6.3 你可能两台都不该买
这一节可能比上面那张表更值钱。
情况一:你只跑 32B 以下的模型。
那你根本不需要 128GB。一张二手 RTX 3090 有 24GB 显存,四五千块,跑 32B 全速,出字速度是这两台小主机的好几倍,还能顺带画图。
用 128GB 的机器跑 14B 的模型,等于开卡车送外卖。
情况二:你要的是极致的出字速度,预算又够。
看 Mac Studio 的大内存版本。它的内存带宽是这两台的三倍,出字速度也是三倍。代价是同容量下价格更贵,画图生态一样弱。
情况三:你想在本地画图、生成视频。
这两台都不行,原因第 2 章讲过。你该买的是一张英伟达独立显卡。
情况四:你到现在还没在自己现有的电脑上跑过任何一个本地模型。
这条最重要。
先在你现在这台电脑上装个 LM Studio 或者 Ollama,下载一个 8B 的小模型,用满两个星期。确认自己真的会用、真的常用,再考虑掏钱。
8B 的模型不寒酸,翻译、总结、日常问答都够体面。而先买设备再培养习惯,是 99% 小白浪费钱的开始。
情况五:你只是想试试这类大内存机器是什么感觉。
租。云上按小时租,几块钱一小时,跑一天不到一顿饭钱。花两百块租满一个月,比花三万块买回来吃灰划算得多。
6.4 确实要买,怎么买
买 Spark,优先考虑品牌厂商版本,不一定要英伟达原厂。
戴尔、华硕、技嘉、微星都出了同芯片的版本。有测评者实测戴尔那版比原厂贵一点,但解决了几个真实痛点:电源从 240W 加到 280W 留了余量、散热改成前后直吹不容易过热降速、还有一个原厂居然没给的电源指示灯。
买 AMD,钱花在内存和保修上,别为 AI 小芯片多花。
128GB 版本是唯一值得买的档位,96GB 和 64GB 省下的钱,会让你少跑好几档模型。至于宣传里那颗专门算 AI 的小芯片,跑大模型时基本用不上,别为它加价。
厂商方面,国内一线的几家(零刻、极摩客、天钡这些)配置差不多,主要看保修和散热设计。这类机器满载发热大,散热做得糙的会降速。

模型相关
https://x.com/@ai_xiaomu硬件相关

软件相关

写在最后
如果你读到这里啥都没记住,那记住下面这句话就行:
出字看带宽,读题看算力,容量决定你能不能跑,带宽决定你能不能忍。
打开你的电脑,用 LM Studio装一个 8B 的小模型,记录下你每次用它干什么,一次输入多少个字,用一段时间,你就知道自己要买什么,或者你其实压根不用买。
黄小木|T11级工程师|内容为Codex创作,若有侵权请指出|持续分享 AI 信息、副业赚钱、程序员转型OPC心得|X:@ai_xiaomu