
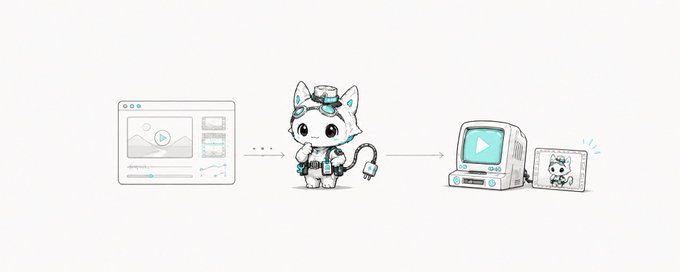
如何让 AI 替你学习并制作一个动画视频?
一套从参考拆解、原创改写,到 H3 生成成片的完整工作流
如果你已经有了自己的 IP 形象、品牌角色或者原创人物,想让它真正动起来,却不会写分镜、设计动作,也不知道怎样使用视频模型
这篇教程就是写给你的💡
最近,我刚好用这套方法完成了一次实验:
我把视觉设计能力很强的好朋友塔塔 @TATALAB_AI 公开分享的 AI 动画教程 https://mp.weixin.qq.com/s/mX_O91d0c0mw5HxTY-eJ5w 和成片一起交给 Codex。让AI先替我学习整套制作方法;然后换成我的原创 IP「哎呀」,重新设计了一个“修理电脑”的故事,再通过小云雀调用 MiniMax H3 生成动画。
最后,我做出了一支属于「哎呀」的新作品!
过程并没有想象中顺利:
第一版里,哎呀修电脑靠的是古法——直接bang bang bang地敲
第二版已经进化成了魔法——举着扳手晃几下,电脑自动修好了(插头尾巴还多长出来一条,笑死)
但是经过一轮又一轮修改以后,它终于从“对着电脑施法”,变成一只会认真检查问题、使用工具和零件维修电脑的小工程师。
把整个过程重新复盘以后,我发现,这套方法不只适合做动画。
只要你看到一份喜欢的内容,却不知道它是怎么做出来的,都可以先让 AI 替你学习、拆解,再把其中可以复用的方法转化成自己的新作品。
看完这篇,你会得到:
- 一份参考资料准备清单;
- 一套让 AI 学习教程的提示词;
- 一张可复用的创作方法卡;
- 一套原创改写流程;
- 一份导演脚本模板;
- 一组修改 AI 视频的方法;
- 一张发布前的原创性检查清单。
注意!这里说的学习,不是让 AI 直接复制别人的作品。
我真正想分享给大家学习的思路是:
- 这个作品为什么成立?
- 它用了什么创意结构?
- 角色、镜头和动作是怎样设计的?
- 作者做了哪些选择?
- 哪些属于原作者独特的表达?
- 哪些方法可以迁移到自己的主题?
接下来,我会用「哎呀修电脑」的完整过程,把这套方法一步一步讲清楚。
01|先找到一份真正值得学习的参考
很多人使用参考时,只会保存一张图片或者一段视频,然后对 AI 说:
“帮我做一个类似的。”
这句话其实非常模糊。
“类似”到底指什么?
是类似的选题、故事结构、视觉风格、镜头节奏,还是直接把原作品里的角色换成你自己的角色?
如果没有说清楚,AI 最容易做的事情就是模仿表面结果。
它会复刻相似的颜色、构图、动作和节奏,最后生成一个“看起来很像,但又没有原版好”的作品。
所以,我更建议大家尽量寻找一份相对完整的参考资料。
一份适合交给 AI 学习的“参考包”,最好包含:
- 最终作品;
- 作者公开分享的创作教程;
- 角色或场景参考;
- 使用的工具和模型;
- 作者提到的修改过程;
- 你最想学习的具体部分;
- 你明确不希望复制的部分。
这一次,我提供给 Codex 的就是塔塔的文章和对应动画。
塔塔的原文: https://mp.weixin.qq.com/s/mX_O91d0c0mw5HxTY-eJ5w
我喜欢这支动画,不只是因为它很可爱。
更重要的是,塔塔在文章里讲清楚了怎样拆解参考、准备角色素材、选择生成模型,以及如何通过不同节点和多轮修改完成视频。
这些才是真正值得 AI 学习的部分。
02|第一轮:只让 AI 学习,不要急着生成
拿到参考以后,先不要让 AI 立即模仿或者创作。
因为如果你一边要求它分析,一边要求它生成,AI 很容易跳过真正的研究,直接开始“照着感觉写”。
第一轮的目标只有一个:
理解这个作品究竟是怎么被做出来的。
你可以把下面这段提示词和参考资料一起交给 AI:
我会提供一篇公开的创作教程和对应作品。请先不要模仿,也不要生成新作品。请作为一名创作研究员,拆解这份内容背后可以复用的制作方法。请分别分析:
创意来源与核心机制; 内容和故事结构; 角色进入故事的方式; 每个镜头承担的任务; 角色动作和情绪如何变化; 前期需要准备的素材; 使用的工具和模型; 从创意到成片的完整流程; 生成过程中出现了哪些问题; 作者使用了哪些修改方法; 声音、音乐和后期发挥了什么作用; 最终作品为什么能够成立。请区分两类内容:A. 可以被其他创作者学习和迁移的方法;B. 属于原作者、不能直接复制的角色、故事、台词、镜头和具体表达。
这一轮结束以后,不要马上进入下一步。
先检查 AI 的分析是不是准确。
- 它只把文章缩短、复述了一遍?
- 有没有把“使用了什么工具”误认为真正的创作方法?
- 有没有把原作品中的标志性角色、镜头和画面,当成可以直接套用的模板?
如果它只告诉你原作品“做了什么”,却没有解释“为什么这样做”,那还不算真正学会。
03|第二轮:把具体案例整理成“创作方法卡”
第一次拆解以后,AI 的回答里通常还会保留大量属于原作品的具体信息。
如果直接在这个基础上生成,它依然很容易照猫画虎。
所以第二轮,我们需要继续抽象:
把“这条作品是怎么做的”,整理成一套“不依赖这条作品也能成立的方法”。
可以继续给 AI 下面这段提示词:
请把刚才的分析整理成一份不依赖原作品的“创作方法卡”。不要保留原作品中的角色、故事、台词、具体镜头、构图和视觉元素,只保留可以迁移到其他主题的方法。方法卡需要包含: 这套方法适合什么类型的内容; 核心创意机制; 通用故事结构; 角色设计原则; 镜头与动作设计原则; 前期素材清单; 推荐的制作步骤; 生成模型的选择依据; 常见失败类型; 修改和质量检查方法。请特别说明:哪些部分可以复用,哪些部分必须根据新的角色和主题重新设计。
完成这一步以后,我们得到的就不再是“怎样复刻塔塔的动画”,而是一套更加通用的方法:
- 怎样选择参考;
- 怎样拆解创意;
- 怎样准备角色素材;
- 怎样设计镜头和动作;
- 怎样选择生成方式;
- 怎样把第一版一点点修改成完整作品。
参考内容开始从一个具体结果,变成一套可以迁移的创作知识。
04|第三轮:加入只属于自己的创作变量
接下来,才轮到我们提出自己的新创意。
我没有让 Codex 把塔塔动画里的角色直接换成「哎呀」,而是重新提供了五个属于我的创作变量。
第一,原创角色。
「哎呀」是一只住在电脑里的机械猫,也是我为 Codex 设计的小小工程师。
第二,新的角色任务。
哎呀不去重复原作品中的故事,而是解决一个与自身设定有关的问题:修理一台坏掉的电脑。
第三,自己的角色资产。
我提供了哎呀的正面、侧面、背面三视图,以及护目镜、机械结构、工具和插头尾巴等固定设定。
第四,新的故事结构。
电脑发生故障,哎呀过来检查,思考问题,开始维修,最后确认电脑修好并开心欢呼。
第五,新的表达目标。
我希望它像一支可爱的日常动画,而不是一条纯粹展示模型能力的技术视频。
如果你也想基于一套方法设计自己的内容,可以使用下面这段提示词:
现在请使用刚才总结的创作方法,为我的原创角色设计一个全新的作品。不要沿用参考作品中的具体角色、故事、台词、动作、镜头和视觉表达。我的角色是:________。它生活在:________。它的核心设定是:________。这次需要完成的任务是:________。我希望观众最终感受到:________。我可以提供的原创素材包括:________。请先提出三个差异明显的创意方向。每个方向需要包含: 一句话创意; 故事起点; 角色遇到的问题; 核心动作; 情绪变化; 结尾结果; 需要准备的素材; 它与参考作品的区别。注意:先比较创意方向,不要立即生成。
这一轮的重点是比较和选择,而不是把所有喜欢的元素都塞进一个方案。
很多内容最后变得又复杂、又没有重点,就是因为我们舍不得删掉任何一个“好像还不错”的想法。
先选一条最清晰、最符合角色设定的方向,再继续往下做。
05|第四轮:把创意翻译成导演脚本
选定故事以后,还不能直接把一句“哎呀修电脑”交给视频模型。
因为模型确实知道什么叫“修电脑”,但它未必知道你脑子里的哎呀应该怎样修。
这一点,我已经通过前两版的失败深刻理解了。
所以在正式生成以前,我先让 Codex 把故事整理成可以直接执行的导演脚本。
可以使用下面这段提示词:
请把刚才选定的创意方向,整理成一份可以交给视频生成模型执行的导演脚本。请按照时间顺序拆分镜头。每个镜头需要写清楚: 镜头时长; 景别与机位; 角色所在的位置; 身体朝向; 具体动作; 使用的道具; 表情与情绪; 镜头需要表现的故事信息; 前后镜头怎样衔接; 必须避免的问题。角色动作必须能够被直接执行。不要只使用“可爱、自然、高级、有趣、认真”等模糊形容词,请把这些感觉翻译成身体动作、表情、位置和节奏。
完成脚本以后,再让 AI 整理一份生成前检查表:
- 需要哪些角色图;
- 需要哪些场景图;
- 哪些角色设定必须保持一致;
- 哪些道具必须真正发挥作用;
- 哪些地方容易发生穿模;
- 预计生成几个片段;
- 每个片段预计消耗多少积分。
因为生成视频会消耗积分,所以我还让 Codex 在执行以前,先把故事脚本、角色动作和积分预估发给我确认。
确认没有问题以后,再让它通过小云雀调用 MiniMax H3 正式生成——这里你们可以使用任何自己想用的工具或模型。
06|第五轮:把“不对劲”翻译成导演指令
第一版出来的时候,其实已经能看出哎呀在修电脑了。
但 AI 对“修电脑”的理解非常朴素。
它让哎呀对着电脑用力敲了几下。
然后电脑就修好了。。。???
我说这不行啊!
我们不能使用这种暴力古法修电脑,还是要让它认真检查一下问题。
于是又生成了第二版。
第二版确实不敲了。。。但是哎呀把扳手举起来晃了几下,电脑就自动恢复了正常。
现在不是古法了,是魔法啊 !
与此同时,尾巴又还出现了穿模,结尾甚至多长出来一条。
这时候我发现,很多人修改 AI 内容时经常说的几句话,其实都没有什么用:
“这个动作不对。”
“这里不够可爱。”
“感觉不够自然。”
“修电脑的感觉不真实。”
这些都是人的感受,却不是模型可以直接执行的指令。
AI 不知道“不够可爱”具体应该改变眼睛、嘴巴、眉毛、身体姿态,还是动作节奏。所以,我们需要把“不对劲”翻译成具体信息。
不要说:
“它修电脑的动作不对。”
要说:
扳手必须真实接触电脑内部的零件,并通过拧紧、调整或拆卸产生实际作用。不能只是举起扳手晃动,也不能通过敲击电脑完成维修。
不要说:
“它思考的时候不够可爱。”
要说:
让哎呀站在电脑侧面,身体微微转向电脑,一只手摸下巴或挠头,头部轻微倾斜。表情需要呈现疑惑和认真,但不能过度皱眉,也不能显得生气。
不要说:
“尾巴穿模了。”
要说:
哎呀的尾巴是一根固定的插头尾巴。尾巴接入电脑以后,角色身后不能再次生成新的尾巴,整个镜头中尾巴的数量必须始终保持为一条。
修改 AI 内容时,可以用下面这个模板:
当前问题是:________。这个问题具体出现在:________。当前画面错误地表现成了:________。正确的动作应该是:________。角色的位置、身体方向和道具关系应该是:________。希望呈现的情绪是:________。必须避免:________。修改时只调整上述问题,其余已经正确的角色设定、画面结构和动作保持不变。
这种指令,我平时天天跟插画师、设计师沟通,已经被训练得炉火纯青了(笑
“不高级”“不可爱”“感觉不对”,对任何创作者来说都很难执行。
只有把感受翻译成具体指令:位置、动作、比例、节奏和因果关系,修改才会真正发生。
07|不要忽略角色的情绪反应
这一次,我还专门调整了结尾的情绪。
最初电脑修好以后,哎呀立刻开始欢呼。
但我总觉得哪里不太对。
后来我意识到,真实的情绪通常不会这么快发生!!电脑恢复正常以后,哎呀应该先停顿一下,看着电确认问题真的解决了,再突然反应过来,开始欢呼。
就是这样一个短短的停顿,让角色突然拥有了一点活人感。
很多 AI 内容看起来“不对”,未必是画面不够精致。
可能只是角色没有真实的观察、犹豫、确认和反应——完成了动作,却没有经历合理的情绪转折。
如果你也在制作角色动画,可以检查下面几个问题:
- 角色是否看见了问题?
- 它有没有对问题产生反应?
- 它为什么决定做下一个动作?
- 动作完成以后,它是否确认了结果?
- 情绪变化之前,有没有合理的停顿?
- 动作、表情和故事因果是否一致?
模型很容易生成动作,但是真正让一个角色变得可爱、可信、像在生活的,往往是动作之间那些很短的观察和反应。
https://mp.weixin.qq.com/s/mX_O91d0c0mw5HxTY-eJ5w08|正片完成以后,再补完整的内容包装
核心动画确认以后,我又继续补充了几个部分:
- 动画片式的片头;
- 日语动画式念白;
- 可爱的 BGM;
- 电脑提示音、机械声和工具音;
- 片头与正片之间的衔接;
- 横向封面和标题构图。
我最开始觉得正片已经做完了,剩下的只是装饰。
但实际做完以后,我发现这些部分承担的是完全不同的任务:
正片负责讲清故事;
片头负责建立作品感;
音乐和音效负责补充情绪;
封面负责让观众愿意点开;
统一的颜色和角色设定,则负责把它变成属于「哎呀」的内容资产。
所以,一支完整的 IP 动画至少可以分成五层:
- 故事:角色遇到了什么问题;
- 动作:角色具体怎样解决;
- 情绪:角色如何观察和反应;
- 声音:观众应该感受到什么氛围;
- 包装:怎样让作品具有统一的辨识度。
视频模型生成的只是其中一部分,真正可交付的完整内容,仍然需要作为创作者的我们继续做选择、判断。
09|发布以前,检查它是在学习还是复制
让 AI 学习参考,并不意味着我们可以无限接近原作品。
尤其是准备公开发布或者用于商业项目时,必须主动检查:最后的内容究竟产生了多少新的表达。
发布以前,我建议回答下面几个问题:
- 是否替换了原作品的角色和故事?
- 是否拥有一个新的创作主题?
- 是否加入了自己的真实经历、内容资产和判断?
- 是否避免复刻具有明显辨识度的台词、镜头和画面?
- 即使不展示参考作品,这条内容是否仍然能够独立成立?
- 观众能否看出它与创作者本人、品牌或原创 IP 的关系?
- 作品是否表达了一个参考内容中不存在的新问题?
- AI 学到的是制作方法,还是只完成了一次元素替换?
我这次最终保留下来的,是塔塔教程中关于分析参考、准备素材、选择模型和多轮修改的工作方法。
但角色换成了我的原创 IP「哎呀」;
故事换成了与角色设定相关的“修理电脑”;
具体动作、表情、道具逻辑、片头、声音和封面,也重新根据自己的内容需求进行了设计。
我们找的参考内容给了 AI 一张地图,但最终往哪里走,还是应该由创作者自己决定。
写在最后
我现在越来越喜欢把文章、教程、案例和作品一起交给 AI,让它先替我学习。
因为很多时候我们并不是完全没有能力做一件事,而是不知道应该从哪里开始、怎样拆分、以及最终需要完成哪些步骤。
一份真正优秀的参考,可以帮助我们看见别人已经走通的路径,AI 则可以把这条路径继续翻译成更容易理解和执行的方法。
但它不会自动替你决定:
- 什么值得学习;
- 什么不应该复制;
- 什么适合自己的角色和观众;
- 哪个结果虽然看起来很精致,却根本不是你想表达的东西。
模型正在快速降低生成的门槛,但与此同时,它也在不断放大人的学习能力、审美、创意、判断和表达能力。
所以我觉得未来最重要的能力是:
- 看见一个好作品以后,能够理解它为什么成立;
- 提取其中可以被迁移的方法;
- 再加入自己的经历、角色、问题和判断;
- 最后做出一个即使离开参考,也依然能够独立存在的作品。
这一次,我让 Codex 学习了一篇公开教程,再通过 MiniMax H3,为「哎呀」制作了一支修电脑的小动画。
第一版是古法,第二版是魔法,好在经过一轮又一轮修改以后,它终于开始认真修电脑了。
以后我也会继续拿更多真实的创意和内容任务来测试 AI:
看看它到底能学会什么、交付到什么程度,以及我们怎样才能把一个模糊的想法,一点一点变成真正属于自己的东西。
———
我是 @小晚不在 🙋
目前 base 杭州,专注于品牌内容增长、IP打造和 AI 时代创作者工作方式研究。
过去几年主要负责情绪消费品牌、IP及内容增长项目操盘,同时实践个人 IP 增长。单月小红书涨粉1w+,单条爆款内容获赞藏20w+。
平时会在 X 分享品牌、IP、AI与内容增长方法论。
目前有一个自媒体内容创作长期答疑社群,也提供品牌和个人自媒体策略咨询,帮助已经在做内容的品牌和创作者,找到真正值得被放大的核心资产,建立清晰的内容定位、表达体系与长期增长路径。
参考教程来自塔塔@TATALAB_AI 的公开分享,感谢她提供的创作思路!她还一直在创作非常有趣的视觉作品、分享教程,希望对这块感兴趣的朋友多多关注她!!
所有内容仅为个人创作实践与方法分享 🙇 感谢阅读!