
卧槽,兄弟们16GB 无独显本地部署 Ling-3.0-tiny:实测 21.7 token/s,比 64GB 的机器快 4 倍,好好地看。

先看两组数字
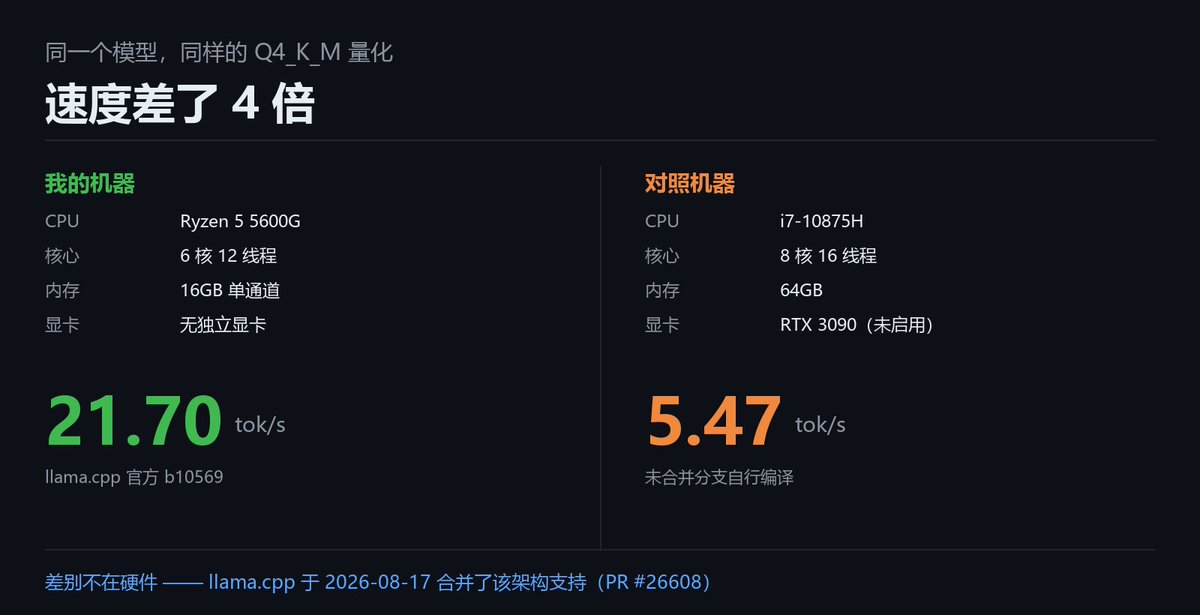
上周有个朋友帮我测了 Ling-3.0-tiny 这个模型,他的机器是这样的:
i7-10875H,8 核 16 线程,64GB 内存,还插着一块 RTX 3090。
跑出来的生成速度:5.47 tok/s。
大概每秒吐两个多汉字。他在报告里的结论是:CPU 速度偏慢,要做生产服务还是得上 GPU 或者更优的后端。
看着挺合理。我本来准备照这个写了。
然后我在自己机器上跑了一遍,我这台是这样的:
Ryzen 5 5600G,6 核 12 线程,16GB 内存,没有独立显卡,而且只插了一根内存条,是单通道。
单通道意味着内存带宽只有双通道的一半,而本地跑模型,最卡的就是内存带宽。
换句话说,我这台在纸面上样样不如他:核心更少、内存是他的四分之一、没有显卡、带宽还打了对折。
结果:21.70 tok/s。
快了将近 4 倍。
我第一反应是自己测错了
这是我这台机器上 llama-bench 的原始输出,没有整理过:
# 测速度(-t 填你的物理核心数)
llama-bench.exe -m Ling-3.0-tiny-Q4_K_M.gguf -p 512 -n 128 -t 6 -r 3

# 起服务
llama-server.exe -m Ling-3.0-tiny-Q4_K_M.gguf -c 32768 -t 6 --host 127.0.0.1 --port 8099
这不合常理,所以我把两边的条件一项项对了一遍。
量化格式:都是 Q4KM。(说明一下,两个文件不是同一份转换——他那份 4,817,378,944 字节,我这份 4,823,895,104 字节,差 6.5MB,来自不同的转换者。同一种量化,不同来源。)
测试工具:都是 llama-bench,都是预热后重复 3 次,都取物理核心数作为线程数。
都是纯 CPU,他那块 3090 全程没启用。
对到第四项的时候,我看到了。
他用的是从一个还没合并的分支自己编译的版本,我用的是官方发布的正式版。
因为在他测试的那天8 月 15 号,llama.cpp 主线还不认识这个模型。Ling-3.0 用了一种比较新的架构,主流推理框架都还没跟上,想跑就得自己从开发分支编译。
两天后,8 月 17 号,这个支持被合并进了主线。
我 8 月 22 号下载官方 Windows 版,直接就能加载,一行代码都不用编译。
慢着,会不会就是 CPU 的差别?
这是最该被质疑的一点,我自己也怀疑过。
Ryzen 5 5600G 是 Zen 3 架构的桌面处理器,65W;i7-10875H 是笔记本的移动芯片,45W,还会被机身散热压着降频,桌面芯片确实占便宜。
但这解释不了 4 倍,而且我这台还是单通道。
本地跑模型时,限制速度的主要是内存带宽,不是 CPU 主频。我这根单条 DDR4-3200,理论带宽大约 25.6 GB/s;一台双通道的机器是它的两倍。我在带宽只有一半的情况下快了 4 倍架构和散热的差异带不来这个量级。
还有个更硬的旁证:我们两台机器的内存占用几乎一模一样。
|  | 输出 tokens | 耗时 | JSON 是否合法 | 字段准确率 |
| :--- | ---: | ---: | :--- | :--- |
| 关闭思考 | 87 | **34.5s** | ✅ | 6/6 |
| 开启思考 | 563 | 60.9s | ✅ | 6/6 |
差距不到 20MB,也就是千分之三。
同一个模型在两台完全不同的机器上占的内存几乎完全一致,说明测量本身是可靠的、可复现的。既然内存能对得这么准,速度却差 4 倍,那差异就不在测量方法上,只能在软件版本上。
如果你觉得我错了,有个很干脆的验证办法:让他在那台 3090 笔记本上装官方新版本,用同样的命令重跑一次。 速度上去了,我是对的;还是 5.47,那说明是硬件差异,这篇文章的核心结论就得推翻。
我很想看到这个结果。
36 层 × 2(K和V)× 8 头 × 128 维 × 2 字节 = 147,456 字节/token = 144 KiB所以,本地模型跑得慢,先别急着怪机器
这是我这次最想说的一句话:
你以为在测模型,其实在测你的推理引擎版本。
新模型刚发布的那段时间,各家推理框架的支持都在赶工。这时候你测出来的速度,很大程度上取决于你手上那份代码是哪天的。
慢,可能是模型的问题,可能是你机器的问题——但也很可能只是因为你的 llama.cpp 是上周的。
这条不只对 Ling 成立。任何一个刚发布的新架构模型,都值得先问一句:我用的引擎,支持这个模型多久了?
21.70 tok/s 到底是什么体验
得说清楚,这个数字比官方公布的低。
官方给的是:FP8 精度下,M4 Pro 的 MacBook 约 86–90 tok/s,DGX Spark 约 100–105 tok/s,8K 上下文峰值内存约 8.34 GiB。(来源:Hugging Face 模型卡 inclusionAI/Ling-3.0-tiny,2026-08-22 核对)
我这边是 Q4 量化跑在一台单通道、没有独显的 AMD 台式机上,21.70 tok/s。量化不同、硬件不同,这两组数不能直接比。
那 21.70 tok/s 是个什么概念?我实测了三段中文长文来换算。
先说明一点:21.70 是 `llama-bench` 的纯基准数字,走 API 实际用的时候是 18.65 tok/s——中间差的是服务端和模板的开销。这个更接近你真实的体感。
按我这三段实测统计,这个模型平均 1 个 token 约等于 1.5 个汉字(733 个汉字 / 482 tokens),所以实际速度大约是每秒 28 个汉字。
一般人认真阅读中文是每秒 5 到 8 个字,快速浏览大约每秒 17 个字。28 字/秒,比你读得快。
具体到场景:
这个速度能干的事
- 日常问答、写作、改稿。 它吐字比你读得快,体感是流畅的,不会出现盯着光标等的情况。
- 本地文档处理。 我喂了一份三千多 token 的合同类文档要它抽字段,整个任务 34.5 秒完成,字段全对。
- 本地 Agent 和工具调用。 这类任务模型只输出一小段 JSON,几秒钟的事。
- 中长篇生成。 按每秒 28 字算,两千字约 70 秒,五千字约 3 分钟。要等一会儿,但等得住。
- 任何数据不能出本机的场景。 合同、病历、内部日志、客户名单——这才是本地部署真正无可替代的理由。
这个速度干不了的事
- 对外提供服务, 单个请求就这个速度,多人同时用扛不住。我也没做并发测试。
- 代码补全这类要求毫秒级响应的场景。
- 一次生成上万字。 按这个速度要 6 分钟往上,不如拆开来做。
一句话:当个人助手完全够用,当生产服务不够。
| 上下文长度 | 我的机器 | 他的机器 |
| ---: | ---: | ---: |
| 32,768 | 7,425.9 MB | 7,406.1 MB |
| 65,536 | 7,642.4 MB | 7,623.6 MB |
| 131,072 | 8,077.1 MB | 8,058.5 MB |
顺手踩的三个坑,你可以直接绕过
坑一:默认是开着“思考”的,会把你的输出预算吃光。
Ling-3.0 支持思考模式,而且默认开启。我第一次让它抽 JSON 的时候给了 300 token 的输出预算,结果全被“首先,用户要求从文档中抽取信息……”这段内心独白吃掉了,JSON 一个字没输出就被截断。
那位朋友在他的测试里也栽在同一个地方——他给了 256 的预算,最后拿到的回复是空的。
解法是显式关掉:请求里加 "chat_template_kwargs": {"enable_thinking": false}。
关掉之后我做了个对照,同一份文档、同样的抽取要求:
| 线程数 | 读输入(pp512) | 生成(tg128) |
| ---: | ---: | ---: |
| 6 | 150.82 | **21.70** |
| 12 | **187.30** | 19.63 |
多花 6.5 倍的 token、多花 1.8 倍的时间,准确率一模一样。
我又找了三道有唯一标准答案的题(打折计算、9.11 和 9.8 比大小、两管注水),开关各跑一遍:
三道题两种模式全部答对。关思考平均 0.6 秒,开思考平均 8.1 秒,慢 13 倍。
所以我的建议是:抽取、分类、格式化这类任务直接关掉思考,把它留给真正需要多步推理的场景。
(说明:三道题样本量很小,只能说明“在这几道题上开思考没带来提升”,不足以下“思考模式没用”的普遍结论。)
坑二:Windows 上发中文请求会乱码。
在 Windows 命令行里用 curl 发带中文的 JSON,服务器会直接报 ill-formed UTF-8 byte 然后 500。因为命令行默认编码不是 UTF-8。
解法:别在命令行里直接拼 JSON,写个脚本明确按 UTF-8 编码发送。
坑三:线程不是开得越多越快。
我这台是 6 核 12 线程,两种配置都测了:
开满 12 线程,读输入快了 24%,但生成慢了 10%。
原因是这两件事性质不同:读输入可以一批批并行处理,线程多有好处;生成是一个字一个字往外蹦,线程多了反而是调度开销。
日常聊天用,设成物理核心数就行(我这台是 -t 6)。要批量处理长文档,再考虑开满。
另一个真发现:它的上下文几乎不吃内存
这一条跟软件版本无关,是模型架构本身带来的。
我把上下文一级一级开上去,131,072 token 的上下文——按实测的 1.5 字每 token 换算,大约二十万个汉字——在一台 16GB 内存的机器上开起来了,占 8.08 GB。
从 65,536 开到 131,072,上下文翻了一倍,内存只多了 435 MB。
算成每个 token 的成本:大约 6,955 字节,也就是 6.79 KiB。
作为对照,一个同尺寸的普通模型(Qwen3-8B)是什么水平?它有 36 层、8 个 KV 头、每头 128 维、半精度存储:
这个公式不是我拍的,我朋友的机器上 Qwen3-8B 开 32K 上下文时报过一个分配失败,日志里的数字是 4,831,838,208 字节。而 147,456 × 32,768 = 4,831,838,208——一字不差。
所以:144 KiB 对 6.79 KiB,差了 21 倍。
差别在架构:Ling-3.0-tiny 每 4 层里有 3 层用的是线性注意力,这种结构的内存开销基本不随上下文变长而增长。
这意味着什么?挑本地模型的时候,“多少 B、量化后几个 GB”是个不完整的问题。 权重占多少内存是固定的,但上下文吃多少内存,不同模型能差一个数量级。你会不会在开长上下文的时候爆内存,主要取决于后者。

你可以照着做
全程不需要编译,三步:
第一步,下载官方 llama.cpp。Windows CPU 版只有 17.7 MB:
去 github.com/ggml-org/llama.cpp/releases,下 llama-bXXXXX-bin-win-cpu-x64.zip。注意挑 2026 年 8 月 17 日之后发布的构建——那天之后的版本才包含对这个架构的支持。我用的是 b10569。
第二步,下载模型,4.49 GB:
Hugging Face 上搜 Ling-3.0-tiny-GGUF,下 Ling-3.0-tiny-Q4_K_M.gguf。
第三步,跑起来:
抽取类任务记得在请求里带上 "chat_template_kwargs": {"enable_thinking": false}。
内存提醒:跑之前把浏览器关掉。我这台 16GB 的机器,开 32K 上下文需要约 7.4 GB,开满 131K 需要约 8.1 GB。我实测的时候确实得先关掉 Chrome 才腾得出空间。
我没测的部分
写出来,免得你按我的结论做超出证据范围的决定:
- 131,072 上下文我只验证了“能开起来”和短生成,没有真的塞满跑一遍。 内存数字是刚启动时分配出来的。真要填满二十多万字,光读进去就得花很久。
- 没测多人并发。
- 中文字数换算基于三段共 733 字的样本,不同文体(代码、表格、纯散文)比值会有出入,我这三段实测在 1.46–1.62 之间。
- 没测 GPU, 我这台没有独显。
- 思考模式的对照只有三道题,样本太小,不足以下普遍结论。
- 那 4 倍的速度差,我归因于软件版本,但我没有在同一台机器上做新旧构建的对照实验。 这是我这个结论最薄弱的一环,也是最容易推翻我的地方。我给出的所有旁证,单通道带宽、内存占用高度一致,都是间接证据。
结论
Ling-3.0-tiny 在一台没有独显、单通道内存的普通台式机上,是真的能用。 每秒近 30 个汉字、13 万 token 上下文、8 GB 内存,做本地文档处理和个人助手够了。
但这篇文章我最想让你记住的不是这个模型,是那 4 倍。
同一个模型、同样的量化、同样的测试方法,仅仅因为推理引擎差了几天的版本,速度差了 4 倍。
下次你在本地跑模型觉得慢,在骂模型或者盘算加内存之前,先花两分钟看一眼:你的推理引擎,是什么时候的版本?
测试日期:2026-08-22
测试环境:Ryzen 5 5600G / 6 核 12 线程 / 16GB DDR4-3200 单通道 / 无独立显卡 / Windows 11 Pro
软件版本:llama.cpp 官方发行版 b10569-5a32f7b66(Windows CPU x64) 模型文件:Ling-3.0-tiny-Q4_K_M.gguf,4,823,895,104 字节
对照数据来源:由他人在 i7-10875H / 64GB / RTX 3090(未启用)机器上于 2026-08-15 使用未合并分支构建测得,模型文件为另一份 Q4KM 转换(4,817,378,944 字节)。其原始报告数据经我核对后引用,非我本人实测。
官方数据来源:Hugging Face 模型卡 inclusionAI/Ling-3.0-tiny,2026-08-22 核对 架构支持合并记录:ggml-org/llama.cpp PR #26608,2026-08-17 合并