
蚂蚁百灵开源 Ling-3.0 Tiny,本地模型又强了一步
蚂蚁集团旗下的百灵开源了 Ling-3.0 Tiny。这款模型面向本地部署,官方已经在 Apple Silicon MacBook 和 Mac mini 上验证过。手里有一台内存合适的 Mac,就能把百灵 3.0 真正跑在本机。
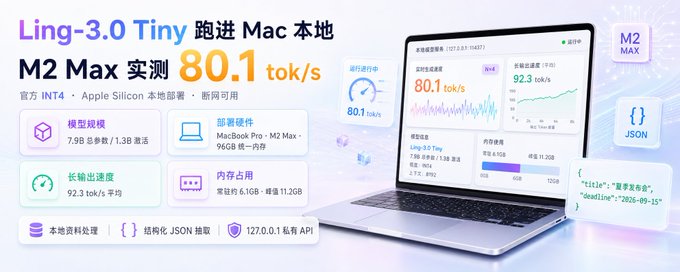
我把官方 INT4 权重部署到一台 M2 Max、96GB 统一内存的 MacBook Pro 上。连续跑了 15 次中文任务,平均生成速度为 80.1 tok/s。服务重新部署以后,又跑了三轮长输出,共生成 2676 tokens,平均速度达到 92.3 tok/s,最低 91.7,最高 92.8。
但我真正想用它做的,不只是跑几个中文人物。
我更想把这份速度用在本地数据处理和日常重复工作上。脚本先读取电脑里的资料,再把文本交给 Ling Tiny。它可以抽取指定字段、统一日期格式,也能按固定结构返回 JSON,继续写入表格或交给下一段程序。长文本测试里,我放入 320 条格式相近的档案,只在其中一条藏入批准码,Ling Tiny 准确找到了它,输出里没有多余解释。
跑通以后,我把 Ling Tiny 配置成随 macOS 登录自动启动。服务只允许这台 Mac 自己访问,提示词和生成结果都留在本机。模型下载完成后,断网照样能用,也不会产生云端模型的 token 账单,这样我就拥有了一个本地智能助手。
为什么从 Tiny 开始
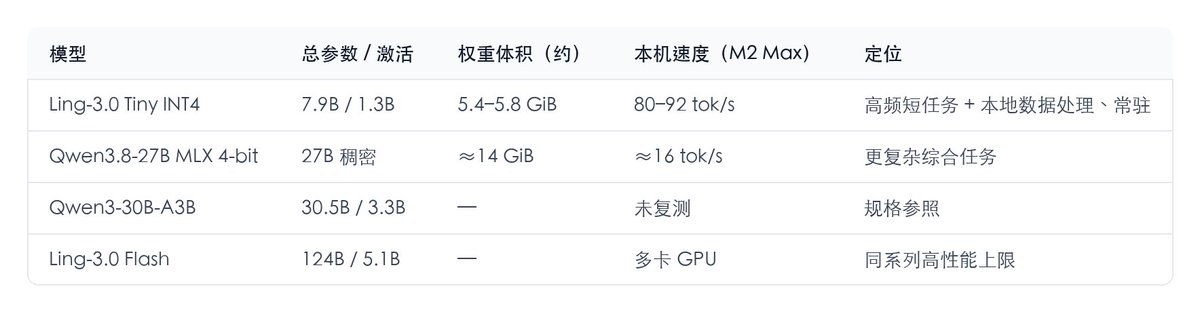
百灵 3.0 系列里还有更大的 Ling-3.0 Flash。Flash 有 124B 总参数,每个 token 约激活 5.1B 参数,官方公开部署方案面向多卡 GPU。它展示了这个系列在高性能硬件上的上限。
Tiny 走的是另一条路。它有 7.9B 总参数,每个 token 约激活 1.3B,官方明确验证过 Apple Silicon MacBook 和 Mac mini。对于手里已经有一台 Mac、想把开源模型变成日常工具的人,这一档更容易长期用起来。
Tiny 采用混合线性注意力 + 稀疏 MoE 架构。注意力层按 3:1 交替堆叠:每 4 层中 3 层是 Kimi Delta Attention(KDA,线性注意力,擅长长上下文与效率),1 层是 Multi-Head Latent Attention(MLA,全注意力,保留精确 token 交互能力)。前馈网络是 128 路由专家的稀疏 MoE,每 token 只激活 8 个路由专家 + 1 个共享专家。总参数决定模型能容纳多少知识,激活参数更接近每一步生成实际要算多少。7.9B 和 1.3B 同时存在,正好解释了它的体感——权重仍然保留了 7.9B 模型的规模,生成时却不用让全部参数一起参与每一步计算。
这也解释了一个容易混淆的地方。1.3B 激活不等于硬盘里只放 1.3B 参数。官方 INT4 源权重约 5.4GiB,导入 Ollama 后,本机模型目录报告约 5.82GiB。MoE 主要减少生成时的计算量,完整权重仍然要存进硬盘,也要进入统一内存。
这个参数的Tiny可以带来更好的体验。服务可以一直开着,收到任务马上回答。无论是写标题、改一段话,还是从本地文件里抽取字段、统一格式、返回 JSON,都不必先把一个二三十 B 的稠密模型从磁盘重新加载,也不用为了几十个字排队等云端接口。
https://huggingface.co/Qwen/Qwen3-30B-A3B这次用了什么硬件
- MacBook Pro
- Apple M2 Max
- 96GB 统一内存
- Ling-3.0 Tiny 官方 INT4
- 8192 tokens 上下文
- Ollama 实验性 MLX 分支
- 本地地址 127.0.0.1:11437
96GB 对 Tiny 很宽裕。它给我留下了足够空间,可以同时开浏览器、编辑器和其他本地服务。模型自身的占用远没有到 96GB。
短任务结束后,进程物理内存约为 6.1GB。放入 320 条档案做长文本检索后,进程约占 9.5GB,整轮测试峰值为 11.2GB。当前服务加载完成后,状态接口报告约 6.10GiB 常驻,8K 上下文已经生效。
这些数字看着有几套口径,各自回答不同的问题。模型文件大小告诉你要准备多少磁盘空间。API 报告的驻留量告诉你当前加载了多少模型和缓存。进程峰值更接近系统在重任务期间见过的最高占用。
结合这次 11.2GB 的峰值,16GB 机器适合先做短上下文试跑,24GB 可以作为更务实的起点,32GB 以上会从容许多。这是根据本机实测、再给 macOS 和其他应用留出空间后的建议,不是官方硬性门槛。8GB 机器即使勉强装下权重,也很难留下舒服的使用余量。
官方公开的 FP8 数字是:DGX Spark 约 100–105 tok/s,M4 Pro MacBook 约 86–90 tok/s(8K 上下文峰值内存约 8.34 GiB)。我这边 INT4 + M2 Max 已经能稳定跑到 90+,说明这条本地路径在这台机器上已经相当成熟。
从官方权重到本地 API
第一步是下载官方 INT4 权重。
hf download inclusionAI/Ling-3.0-tiny-int4 \ --local-dir ./Ling-3.0-tiny-int4
模型目录里包含 32 个 safetensors 分片、配置文件、分词器和聊天模板。下载完成只代表文件齐了,模型还没有成为一个可以调用的服务。
第二步是准备带 Ling MLX 支持的 Ollama 实验分支。当前这条路径还没有进入普通稳定版 Ollama,所以不能只执行一次 brew install ollama 再期待它自动识别 Ling Tiny。实验分支负责读取百灵的模型结构,并把计算交给 Apple Silicon 上的 MLX 后端。
本地 Modelfile 指向下载好的权重,同时把上下文和采样参数固定下来。
FROM /path/to/Ling-3.0-tiny-int4 PARAMETER num_ctx 8192 PARAMETER temperature 1.0 PARAMETER top_p 0.95 PARAMETER top_k 20
第三步是让服务在 macOS 登录后自动启动。模型在终端里可以正常运行,交给系统后台启动后却会直接退出,日志里只留下 Operation not permitted。
我把运行组件移到系统允许后台访问的位置,并补齐 MLX 所需的运行依赖。处理完以后,Ling Tiny 可以随系统登录自动启动。平时打开终端就能直接调用,不用每次重新加载模型。
第四步是固定端口。系统默认 Ollama 通常使用 11434,这套 Ling 服务改用 11437,避免和机器上其他模型抢同一个入口。服务只绑定 127.0.0.1,局域网设备不能直接访问。通过这条 API 发送的提示词和结果留在本机进程里。
项目现在保留了五个日常命令。
./scripts/start.sh ./scripts/status.sh ./scripts/chat.sh '写一个200字提纲,未知信息用【待补充】标记' ./scripts/benchmark.sh 3 ./scripts/stop.sh
start.sh 会加载当前用户的登录服务,再轮询版本接口。status.sh 会列出已安装模型、当前驻留量和上下文长度。stop.sh 只停止服务,不删除 5.8GiB 模型文件,下次启动不需要重新下载。
第一条请求怎样验收
服务能返回版本号,还不能证明模型可以完成生成。验收时还要发一条聊天请求。
curl http://127.0.0.1:11437/api/chat \ -H 'Content-Type: application/json' \ -d '{ "model": "ling-3.0-tiny-int4", "messages": [{"role": "user", "content": "只回复:pong"}], "think": false, "stream": false }'
终端返回了 pong。随后状态接口显示模型已经加载,常驻约 6.10GiB,上下文长度为 8192。权重下载、模型注册、服务监听、动态库加载和真实生成,至此全部通过。
我又让它写一句 30 字以内的欢迎语,只允许使用“百灵 Ling-3.0 Tiny 已在 Mac 本地运行”这项事实。它返回得很干净。
百灵 Ling-3.0 Tiny 已在本地 macOS 运行。
这种本地小模型还能做什么
1.3B 激活参数让 Tiny 很适合高频、边界清楚、需要快速返回的任务。除了写标题和摘要,它更适合长期帮你处理本地重复性工作。
1. 本地结构化数据处理(我实际在用的)
这是目前最有价值的部分。
- 字段抽取:从会议纪要、客户沟通记录、产品说明里,抽出「决议事项 / 负责人 / 截止日期」「客户名称 / 需求点 / 预算范围」等,强制返回 JSON,缺失字段必须是 null。
- 格式统一:把各种写法的日期、金额、编号统一成标准格式。
- 结构化输出:给一段自然语言,强制返回固定 Schema 的 JSON,方便后续程序直接使用。
- 中等规模检索:我准备了 320 条格式相近的档案,只在一条里写入批准码 LING-4827,模型准确找到并只返回代码,没有多余解释。
脚本流程很简单:读取本机文件 → 发给本地 API → 校验 JSON → 写入表格或进入下一步。因为模型常驻,连续处理几十上百条几乎感觉不到加载时间。
https://github.com/ollama/ollama/pull/176432. 本地知识库与笔记助手
https://huggingface.co/inclusionAI/Ling-3.0-tiny把 Obsidian、备忘录、本地文档文件夹当作知识源,让 Tiny 做:
- 根据问题检索并总结相关笔记
- 把零散记录整理成结构化卡片
- 从长笔记里提取关键观点或待办事项
- 按指定模板重写某一段内容
数据完全不出本机,适合处理带隐私的个人或工作笔记。
3. 轻量代码与文本辅助
- 解释一段本地代码在做什么
- 根据注释生成简单函数骨架
- 把杂乱的日志或报错信息整理成可读描述
- 批量把 Markdown / 纯文本转成更规范的格式
它不是用来替代大型编程模型的,但处理日常小片段时响应很快。
4. 会议与沟通记录处理
录完音转成文字后,直接丢给 Tiny:
- 提取决议、负责人和截止日期
- 生成简洁会议纪要
- 把口语化内容改成书面表达
- 按固定模板输出「背景 - 讨论 - 结论 - 待办」
5. 批量文件处理与自动化前置
配合脚本,它可以成为本地自动化流水线的一环:
- 批量清理导出的数据
- 给文件打标签或分类
- 把非结构化文本转成表格
- 作为本地 agent 的「大脑」,先理解内容再决定下一步操作
6. 隐私敏感场景
任何不想上传云端的内容——个人日记、内部文档、客户资料、未公开的产品信息——都可以在本机完成初步处理。断网也能继续工作。
我把温度设为 0 时,精确指令、JSON、信息抽取、事实边界、摘要和长文本检索 12 道任务全部通过。温度调到 1.0 后,六类关键任务各跑 5 次,30 次全部满足机械规则。说明在明确约束下,它的输出相当稳定。
开放式文案我仍会保留最后一次人工确认。提示词里明确写出允许使用的事实,未知信息统一标成 【待补充】,脚本再检查格式和禁用词。
与其他开源模型对比
https://huggingface.co/inclusionAI/Ling-3.0-tiny-int4在同一台 M2 Max 上,我还部署过 Qwen3.8-27B 的 MLX 4-bit。它是 27B 稠密模型,本地权重约 14GiB,日常生成约 16 tok/s。Ling Tiny 的官方 INT4 源权重约 5.4GiB,实测速度明显更快。
小模型接住高频短任务和结构化处理,大模型处理需要更多推理和知识覆盖的内容,两者可以同时存在于一台大内存 Mac 上。
它怎样进入实际工作流
接入方式很简单。服务提供了兼容 OpenAI 的接口,地址是 http://127.0.0.1:11437/v1。 Cursor、VS Code 插件、自己写的 Python 脚本,或者任何支持自定义 Base URL 的工具,只要把地址指过来,API Key 随便填一个非空字符串就能用。
我现在的日常用法大致是这样:
1. 资料进来 把会议记录、产品说明、客户沟通内容,或者本地文件夹里的一堆文本,直接丢给脚本。
2. 先让 Tiny 做结构化 脚本调用本地接口,要求它按固定格式返回 JSON。比如:
{ "title": "...", "owner": "...", "deadline": "2025-09-15", "price": null, "notes": "【待补充】" }
缺失的信息必须返回 null 或 【待补充】,不允许编造。
3. 人工快速确认 我只看结构化结果对不对。字段齐全就进入下一步,有问题就改提示词再跑一次,成本很低。
4. 需要成文时再扩写 确认过的结构化内容,再发给 Tiny 生成不同长度的初稿、标题或摘要。 程序会再检查一次字数、禁用词和格式。
5. 最后由人把关 事实核对和最终表达,还是我自己来。Tiny 负责又快又规范的中间环节,我负责判断和决策。
整条链路都在本机完成。服务只监听 127.0.0.1,提示词和生成结果不会离开这台电脑。断网也能继续处理已经下载好的资料。
上下文我固定在 8192。对日常写作和中等长度的资料处理已经够用,内存占用也更可控。官方虽然支持更长的上下文,但对常驻服务来说,先保证稳定和轻量更实际。
哪些 Mac 更适合
24GB 或 32GB 统一内存的 Apple Silicon Mac 可以认真考虑。短文本、标题、摘要和结构化抽取对内存压力较低。16GB 机器可以从较短上下文开始。8GB 更适合把这次文章当作技术参考。64GB 和 96GB 的机器可以同时保留 Tiny 与更大的本地模型。
磁盘建议预留十几 GiB,包含源权重、导入文件、构建产物和日志。
最后留下什么
现在运行 ./scripts/status.sh,能看到模型已加载、上下文为 8192。运行 ./scripts/chat.sh,提示词会送到本机 11437。系统下次登录时,服务会自动拉起。
Ling-3.0 Tiny 给这台 Mac 增加了一项很实用的能力。它用大约 5.4GiB 的官方 INT4 权重,在 M2 Max 上持续输出每秒八十多个 tokens,既能处理文案,也能稳定完成字段抽取、格式统一、JSON 输出、笔记整理和中等长度检索。部署过程里遇到的后台权限与 MLX 依赖已经处理完,留下的是一个可以重复启动、检查、调用和停止的本地服务。
它很适合做本地第一台常驻写作与数据处理引擎。复杂推理和深度知识仍然建议搭配更大模型或人工确认,但每天反复出现的第一稿和结构化工作,它可以稳稳接住。
模型与部署资料
- Ling-3.0 Tiny
- Ling-3.0 Tiny INT4
- Ling-3.0 Flash
- Qwen3-30B-A3B
- Ollama MLX 支持(实验分支 PR #17643)