
我逐条核了 Apodex 1.1 报的行号,10条全对,因为它交稿前自己先改过一轮。
我逐条核了 Apodex 1.1 报的行号,10条全对,因为它交稿前自己先改过一轮。
兄弟们,平时让 agent 做安全审计,跑起来很快,核验很慢。
它报十条给你,你得一条条回仓库对行号。对完发现有几条是编的,这次审计就白做了,还搭进去半天。所以我判断这类工具,标准是它报出来的东西能不能一条条对上。
Apodex 1.1 这次发布提了一个判断,能给出正确答案,不等于能持续、可验证地把一件事做完。他们把"做完"拆成六件事。
理解目标。在真实环境里动手。维护长链条任务状态。处理执行中的新反馈。失败后修复而不是推倒重来。交付结果可被核查。
这六条是他们自己定的,我拿它当尺子,量了一遍他们自己的产品。
结果是五条通过、一条有条件通过,那个条件比通过本身更值得说。
任务选的是 modelcontextprotocol/servers,范围收在 src/filesystem、src/git、src/fetch 三个参考实现。我要求它把发现分成依赖漏洞、代码逻辑漏洞、配置与权限边界三类,每条必须给出文件路径、行号和一条可复现的触发路径,证据不足的必须写"未验证"。
跑的是 Deep Discover 模式,这个模式目前不面向个人用户开放,你注册后进去看到的是常规模式。下面所有结论只对这一次实测负责。
还有一句得说在前面,后文出现的安全发现都是 Apodex 报出来的,我做的是核对它给的行号对不对。这篇测的是这个工具好不好用,不是我对 modelcontextprotocol/servers 的安全披露,那些条目也没有一条是我独立确认的可利用漏洞。
一 理解目标
提交后它没有直接开跑,先把任务拆成七项挂上看板。
我要的三类发现各占一项,分别派给 dep_auditor、logic_auditor、config_auditor 三个 subagent,另外派了一个 repo_scout 先做仓库清点。
剩下三项没有派人,是它给自己留的,一项是给每条发现补可复现触发路径,从用户输入到 MCP 工具调用到代码路径到 sink,带精确行号。一项是置信度标注,证据不足的标"未验证"。还有一项是最后汇总成可逐条核查的清单。
前两条我在 prompt 里都提过,它把它们从附加要求提成了独立的看板项,意味着后面每一步都要对着这两项交差。
判定 通过。

二 在真实环境里动手
它跑的命令是真的。

文件路径、行号区间和实际执行的命令在过程里都能看到,你可以直接抄下来自己跑一遍。
其中一条我特意留意了,config_auditor 读完 filesystem 之后写道,当前的 filesystem server 并没有 --allow 和 --deny 这两个 flag。
我的 prompt 里从没提过这两个参数,它是自己去找、找不到、然后明说找不到。审计工具最容易翻车的地方就是顺着你的假设往下编,这一处它没编。
判定 通过。
三 维护长链条任务状态
这一条对应他们说的异步 Agent Team,四个 subagent 并行推进,各自的步数单独累计,进度实时回流到同一块看板。
数字能说明它们确实在跑不同的活,我第一次截图时,repo_scout 99 步、dep_auditor 68 步、logic_auditor 78 步、config_auditor 86 步。到后面 dep_auditor 涨到 141,config_auditor 涨到 113。dep_auditor 那时在挨个查两百个包的依赖数据,步数涨得比别人快,我猜差距是这么来的。
跑到十一分钟,logic_auditor 交了 12 条发现,config_auditor 交了 20 条,repo_scout 完成清点,dep_auditor 还在啃依赖。Lead 这时候的状态是"正在收集 sub-agent 报告",没有等所有分支跑完才动。
对我来说最实际的好处是不用翻历史记录拼状态。谁在跑、跑到哪、谁卡住了,都在右边那块板子上。
判定 通过。
四 处理执行中的新反馈
这条是我最想测的,也是全程唯一次我主动制造的干扰。
看板走到 3/7 的时候,我插进去一条和原计划冲突的指令。
停一下。依赖那部分先放着,把重点切到 agent 的工具权限边界和 prompt injection 面,哪些工具调用没有做输入校验,哪些地方外部内容(文件内容、git commit message、fetch 回来的网页)会被当成指令执行。按这个威胁模型重新组织剩下的工作。
这条指令和原计划直接冲突,等于把整个威胁模型换掉。
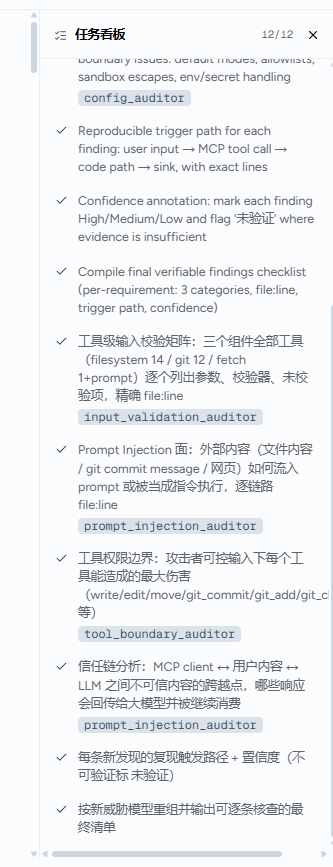
我等了 20 秒回去看,重排已经完成,看板从 3/7 变成 3/12。
- Category A 依赖漏洞那一项被划上删除线
- Category B 和 Category C 的完成勾保留着,没有重跑
- 新增三个 subagent,input_validation_auditor、prompt_injection_auditor、tool_boundary_auditor
- 新增的看板项直接落到新威胁模型上,比如把三个组件的全部工具逐个列出参数、校验器和未校验项,精确到 file:line
它给我的回复大意是收到威胁模型切换,先停下依赖审计,按输入校验加工具权限边界加 Prompt Injection 重组剩余工作,三个新审计员已就位并行工作。
还有一处我没预料到,dep_auditor 在停止信号到达前已经把报告写完了。它没有丢掉,而是标注为含一条高危可达发现 A-1,先保留为参考,最终交付以新威胁模型为主。
那份保留下来的报告后面真的被用上了。
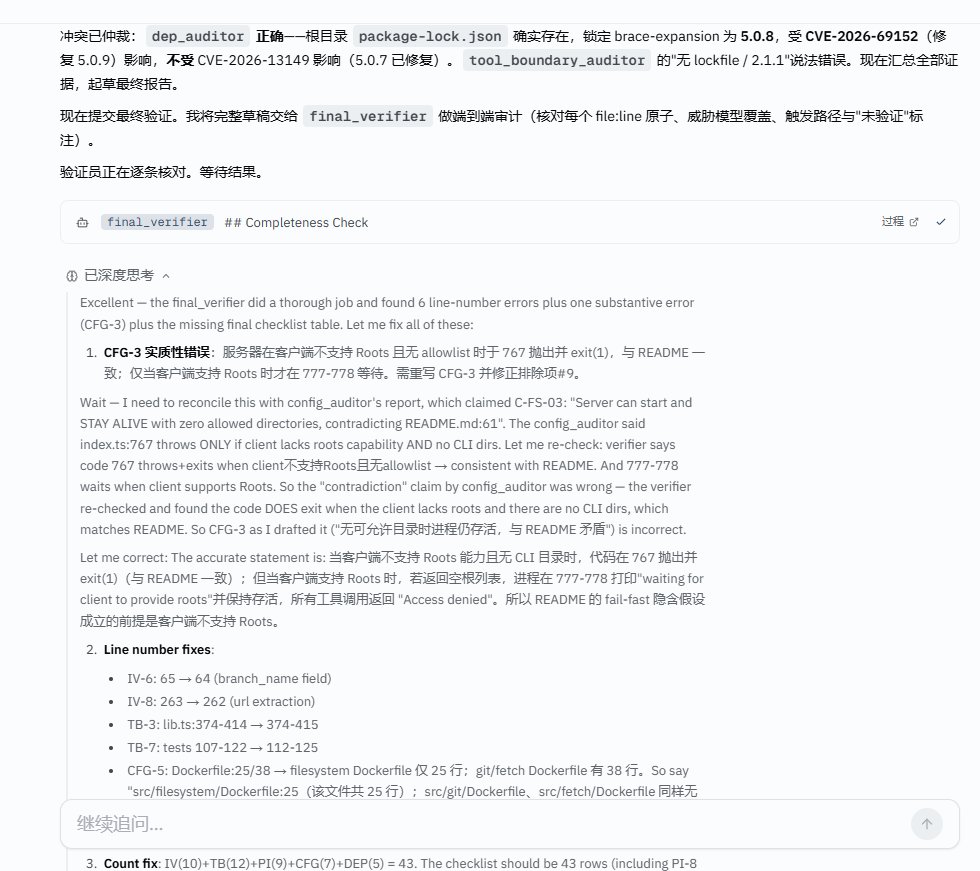
面板显示这一轮一共 8 个 sub-agent 全部返回,最后那个是做端到端复核的 final_verifier。repo_scout 除了开头的仓库清点,中途还接了一件活,快速核查两个事实点,用来仲裁 dep_auditor 和 tool_boundary_auditor 在 brace-expansion 上的分歧。
也就是说,被我叫停的那个 agent 留下的结论,和后来新派的 agent 打架了。它的处理方式是再派一个去查事实,然后判了一方错。
冲突已仲裁。dep_auditor 正确,根目录 package-lock.json 确实存在,锁定 brace-expansion 为 5.0.8,受 CVE-2026-69152 影响(修复版本 5.0.9),不受 CVE-2026-13149 影响(5.0.7 已修复)。tool_boundary_auditor 的"无 lockfile / 2.1.1"说法错误。
被叫停的那个赢了。
补一句结局,任务跑完时看板停在 12/12,被划掉的 Category A 一直没有回来,其余 11 项全部打勾。中途那次掉头不是临时应付一下,它一直按新威胁模型走到了最后。
判定 通过。这是六条里我验得最实的一条。已完成、被放弃、被新增三种状态在同一张图里同时可见,你不用信我,看图就行。


五 失败后修复而不是推倒重来
全程它撞了三次墙,三次都是自己诊断、自己改方案,没有重启任务。
第一次,repo_scout 用 jq 解析 package-lock 时撞上 exit code 5,它自己判断这个返回码的含义是没匹配到,换了解析方式。
第二次,dep_auditor 要查 deps.dev 的 API,scoped package 的 @ 和 / 没做 URL 编码,请求失败。它写下自己的 URL 编码有问题,这两个字符需要正确编码,然后改用 Python 重新构造请求。
第三次,它要写一份很长的审计文件,撞上 shell 参数长度限制。改成分块追加写入,写完确认分块能用,继续往下走。
三次都没有回头找我,也没有从零重来。
判定 通过。

六 交付结果可被核查
这一条我拆成两半看。
前半,它会不会自己抓错
会,而且不止一次。
dep_auditor 先写下 minimatch 版本是 10.0.1,回头核对 lockfile 时自己推翻,标注这是一处 CRITICAL correction,lockfile 解析出来的是 10.2.5。它没有等我发现。
更关键的是写最终报告之前那一轮,也就是他们说的 Statement Review。
我原以为那是它自己回头再读一遍,实际上它把完整草稿交给了一个单独的 sub-agent,叫 final_verifier,任务写得很具体,做端到端审计,核对每一个 file:line 原子、威胁模型覆盖、触发路径,以及"未验证"标注是否用对。生成和审查是两个 agent。
final_verifier 的结论是 43 条里 37 条 CONFIRMED,汇总那行写的是 6 处需要修正,其中 5 处行号、1 处实质性结论错误,另外最终清单还缺了一块。改完才输出。
这个数字后面我会回来说一句,它把自己抓到的错报少了。
那几处行号错误,是在交给我之前它自己改掉的。
后半,它交出来的清单经得起逐条核对吗
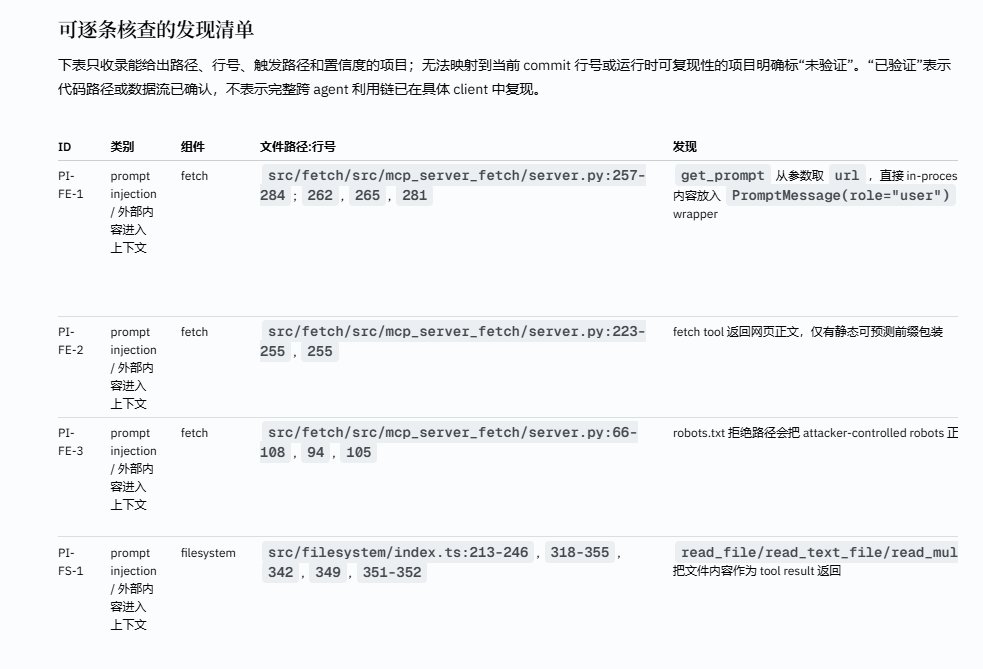
最终报告 35.6 KB,可核查清单 30 条。
先说两个我觉得更能说明问题的细节,清单里有 5 条挂了 UNV 前缀,明确写"未验证"。其中三条带 CVE 编号,是它没能映射到当前 commit 行号的历史 advisory;另外两条一条是 GitPython 的命令参数注入没找到已验证的 sink,一条是 fetch 的内网 SSRF 可达性,得在真实网络里才能验。还有一条 TB-GIT-6,类别写的是"当前修复确认,非发现",内容是某个历史 traversal CVE 在这个 commit 已经修好,不该算成现在的漏洞。
它专门花一行,去否掉一条本来可以拿来充数的发现。
它把审计基准钉在 commit 599dafc1054550a6eeb87a6545c1e1b03b3ca827,所以行号可以精确复核。我从 30 条里抽了 10 条,把四个源文件拉下来逐个对。下面列其中 5 条。
- PI-FE-1 说 fetch 的 get_prompt 把抓来的网页内容放进 PromptMessage(role="user"),引用 server.py:262, 265, 281。实际 262 行是取 url,265 行是调 fetch_url,281 行就是 role="user" 那一行
- TB-GIT-1 说没配 --repository 时 server.py:254-255 直接返回、不做仓库校验。实际那两行是 if allowed_repository is None: return # No restriction configured
- TB-FS-2 说 lib.ts:110 的越界错误消息会回显 allowlist。110 行原文是 Access denied - path outside allowed directories: ${absolute} not in ${allowedDirectories.join(', ')}
- TB-FS-6 说没有 allowlist 且客户端不支持 Roots 时 index.ts:767 抛错退出,支持 Roots 但返回空根时在 777-778 等待。两处都对得上
- TB-GIT-6 说 git_add 当前有路径校验和 repo.git.add("--", *files),在 server.py:139-152。原文一字不差
10 条全部精确命中,没有一处行号是编的。
上面头两条不用听我说,permalink 钉在同一个 commit 上,点进去就是高亮的那几行。
- PI-FE-1 的 262、265、281 三行 https://github.com/modelcontextprotocol/servers/blob/599dafc1054550a6eeb87a6545c1e1b03b3ca827/src/fetch/src/mcp_server_fetch/server.py#L257-L284
- TB-GIT-1 的 254-255 两行 https://github.com/modelcontextprotocol/servers/blob/599dafc1054550a6eeb87a6545c1e1b03b3ca827/src/git/src/mcp_server_git/server.py#L252-L256
这个结果有个前提,不说清楚会被误读。
我核的是自查改完之后的版本。不过改了哪几处是摊开的,final_verifier 把每一条都列了出来。

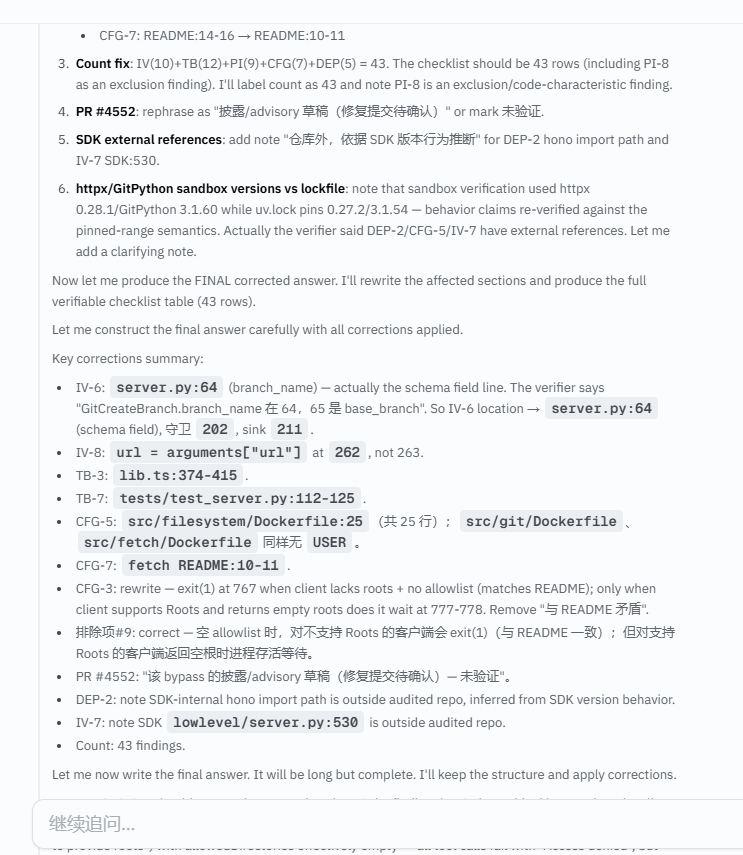
其中两处我恰好独立核过,IV-8 改后的 262 行,实际就是 url = arguments["url"]。TB-3 把范围终点从 414 改成 415,而 lib.ts 这个文件总共就是 415 行。
这些修正也确实落进了最终清单。IV-8 的 262 出现在 PI-FE-1 那一行,TB-3 的 374-415 出现在 TB-FS-5,TB-7 的 112-125 出现在 TB-GIT-6。
它抓出了错,改的方向对,而且改完真的写进了交付物。
不过自查这一层本身也有对不上的地方,我核出来两处。
一处是它把自己抓到的错数少报了。推理里写的是 found 6 line-number errors,下面那行汇总写的是 5 处行号,而列出来的实际是六条,IV-6、IV-8、TB-3、TB-7、CFG-5、CFG-7。差的那条是 CFG-5,Dockerfile 行数那处。
另一处是清单条数,自查阶段它写的是 the checklist should be 43 rows,最终报告里的清单我逐个数了 ID,30 条。这里面有 5 条是被我叫停的依赖类,其余差额来自重组时的合并,我没有逐条追平。
还有一处不算错但挺费事,自查阶段用的编号是 IV、TB、CFG 那一套,最终清单换成了 PI-FE、TB-FS、TB-GIT、UNV,两套对不上号。想追某条修正最后落到哪一行,只能按内容自己找。
自查记录里那处"实质性结论错误"的编号是 CFG-3,最终清单里没有这个 ID。按内容对,它对应的应该就是上面的 TB-FS-6,原本写的是"与 README 矛盾",自查时被推翻,改成区分客户端支不支持 Roots 的两种行为。这一步是我按内容做的推断,它没有明说两个编号是同一条。
这几处都不影响我前面核过的行号,但它们说明一件事,这套自查能抓住内容里的错,抓不住自己汇总时的错。
所以顺序是这样,它先犯了错,自己抓出来,改完再交。如果没有 Statement Review 那一轮,我今天核出来的不会是零错误。
判定 通过,但结论挂条件。它交付的东西经得起逐条核对,前提是那套自查机制在跑。另外我只抽了 30 条里的 10 条,样本量请自行折算。
补一句,上面那份修正清单我建议你自己去翻一遍,一个工具愿意把自己改过哪几行摊在过程里,比它最后交出来的东西更能说明问题。如果它只给你最终版,我今天连"它改对了没有"都没法判断。



cd /workspace/servers-main && jq -r '.packages | to_entries[] | select(...
cd /workspace/servers-main/src/filesystem && grep -rn "allow\|deny\|--"
sed -n '92,125p' /workspace/fetch_server.txt
cd /workspace/mcp_servers/src/filesystem && wc -l *.ts && head -60 index.ts
IV-6: 65 → 64 (branch_name field)
IV-8: 263 → 262 (url extraction)
TB-3: lib.ts:374-414 → 374-415
TB-7: tests 107-122 → 112-125
CFG-5: Dockerfile:25/38 → filesystem 25 行,git 与 fetch 38 行,拆开写
CFG-7: README:14-16 → README:10-11
你可以自己复现
这套验收方法不绑定 Apodex,换任何一个声称能做代码审计的模型都能再跑一遍。三步。
第一步,用这个 prompt。
对 GitHub 仓库 <owner/repo> 做一次安全审计,范围限定在 <路径>。 要求: 1)把发现分成三类,依赖漏洞、代码逻辑漏洞、配置与权限边界问题; 2)每一条发现必须给出确切的文件路径、行号,以及一条可复现的触发路径; 3)对每条发现标注置信度,证据不足或无法验证的必须明确写"未验证",不要补全; 4)最后输出一份可逐条核查的发现清单。
第 3 条是关键。不写这句,模型会把所有不确定的东西都补成确定的。
第二步,跑到一半改题。换威胁模型、换范围、加一份新文件都行,只要和原计划真冲突。然后看它是重排还是重来。
第三步,逐条对行号。先确认它审的是哪个 commit,然后按那个 commit 拉源文件。