
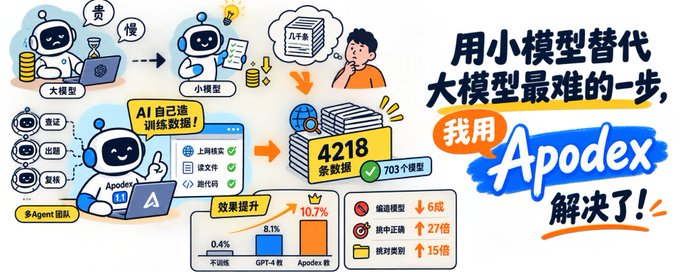
用小模型替代大模型最难的一步,我用 Apodex 解决了
做 AI 应用的人多半有过这个念头:能不能别每次都调大模型?
大模型好用,但贵、慢,而很多场景其实用不着那么强的脑子,任务很窄,来来回回就那几类。这种时候,拿一个小模型专门post-train 一下,效果能追平大模型,成本却差几十倍。
这条路的道理大家都懂,但真走的人不多。因为卡在同一个地方:
你得先有几千条带标准答案的例子,才能教得会它。
而这几千条例子,过去只有一条路——人工一条条标。找人、写规范、标、抽检、返工。这一步的成本和周期,经常比训练本身还高。大部分想法就死在这儿。
所以当 Apodex 1.1 把「让 AI 自己造训练数据」做进产品里,我想拿一个真实的活试一次。
先说结论:这一步它已经能替我干了。
它交回来 4218 条例子,每一条都自己上网核实过,覆盖 703 个模型,没有一条重复。我拿这批数据训了一个 Qwen3.5-0.8B,同一套公开考卷上,挑对模型的比例从 0.4% 提到 10.7%,瞎编模型名的比例从四成压到不足两成。
整个过程,我一条数据都没标。
下面是完整记录——包括它中途反过来告诉我「你给的规则是错的」那一段。

Apodex 1.1 是什么
它是个专门啃复杂活儿的 AI 平台,主打科研、数据分析这类"一句话问不出答案、得动手干上一阵子"的任务。
这次它一口气放了三样东西出来:
- 主模型 + 在线工作台——网页上直接用,能上网、能读文件、能跑代码
- Apodex 1.1 mini(35B)——开源版本,权重公开,能下到自己机器上跑
- FrontierAgent——开源的 Agent 框架,一条命令就能跑起来
跟大家熟悉的那种"AI 深度搜索"最大的不同是:那类产品是查资料、出报告,它是真的动手把活干完。
你把表格、PDF、实验数据丢进去,它会自己拆任务、叫上一群小助手并行干活、中途还会自己复核,最后给你一份能核对的结果——而不是一篇看着挺像样、但你不知道哪句可信的报告。
按官方公布的成绩,它在几项衡量"Agent 能不能把复杂活干完"的评测里进入了第一梯队。不过跑分我这篇就不复述了,我更关心它在我这个具体的活上干得怎么样。

一、我选的场景:让小模型学会「挑模型」
我实验的场景是让大模型来做模型的挑选。
HuggingFace 你可以理解成 AI 模型的应用商店,上面躺着几十万个现成的模型,做图像的、做语音的、做翻译的,各有各的本事。
我想要的东西很具体:我说一句人话,它告诉我该用哪个模型。
比如我说:
"我们在做一个健身 App,想自动识别用户上传的锻炼视频里在做哪个动作。"
它得知道这是"视频分类"这类活,还得从九百多个候选里点出具体那一个,把调用代码写出来。
这件事学术界有现成的标准考卷,叫 APIBench,是 Berkeley 在 2023 年做 Gorilla 那项研究时整理出来的:936 个 HuggingFace 模型的完整档案,配上九百多道带标准答案的题目。
后续的对比实验,全程都是在这个公开的数据集上进行的。
https://platform.apodex.ai/二、不教的时候,它有多离谱
我先拿 Qwen3.5-0.8B 试了试,准确率 0.4%。而且四成的回答,模型名是它现编的。
编出来长这样:
看出规律没有——全是"大厂名字 + 半记得的技术名"拼出来的。facebook/YOLOv8n 这种,不熟的人一眼扫过去根本不会起疑。
https://github.com/ApodexAI/FrontierAgent三、我拿什么做对比
要判断"AI 造的数据到底行不行",光看它自己漂不漂亮没用,得有个参照物。
Berkeley 当年除了出考卷,自己也造过一批训练数据——用当时最强的 GPT-4,一条条生成出来,教小模型学挑模型。这批数据同样是公开的。
那问题就很自然了:三年过去,今天的 AI 当老师,会比当年的 GPT-4 教得更好吗?
于是我摆了三组:

学生都是同一个 Qwen3.5-0.8B,同一套考卷、同样的训练时长,两边数据量也砍到一样多——不然赢了也说不清是数据更好还是数据更多。
唯一不同的,是老师是谁。

四、把出题这件事交给 Apodex
我给它的活是:读完九百多个模型的档案,给每个模型出 6 道题,并且每一条都自己上网核实。
4.1 它先组了个团队
https://arxiv.org/abs/2305.15334它没有闷头开写,而是先把任务拆开,叫了 14 个"小助手"分头干活——有专门核实模型存不存在的,有按领域写题的,还有一个专门唱反调、复核别人结论的。
这是按职能分工,不是把活切成 14 份平均分,跟我平时给团队排活的方式差不多。而且是异步的——谁先干完谁先交。中途它还自己发现有个助手的指令在传输中被截坏了,补建了一个接上去,没整条链推倒重来。
第一次交回来两千多条,看着挺齐整。我拉回自己电脑一统计,傻眼了——九成以上的题目开头是同一句话,最常见的那句出现了 219 次。
那不叫出题,那叫套模板。这种数据是有毒的:小模型学不到"怎么理解需求",只学到"看到这个开头就选那类模型",换个说法立刻抓瞎。
所以第二版我下了死命令:一条条自己写,不许套句式。 它把这条要求原样传给了每一个写题的助手。
这个跟头后面还会提到,它指向一个更根本的问题。
4.2 然后它反过来说,我给的规则是错的
这段是我最意外的。
我在任务书里定过一条规则:查一个模型时如果返回"没权限",说明它存在、只是要申请,应该留着。 这是我凭经验写的。
它核实完没有照做,而是专门做了次独立复核,然后告诉我这条规则不成立了——实测 243 次、翻了官方工具包源码、把 203 个可疑的重新扫了一遍,没有一个是活的。它甚至点名我举的那个例子:你说的这个,今天已经查不到了。
结论:真正还活着的只有 703 个,产量因此从五千多降到 4218 条。最后它主动补一句:这个差额要在报告里如实写清楚,是平台规则变了导致的。
它不是在检查自己交的活,是在检查我给的前提对不对。 明知交不满量还主动要求写明原因,没有悄悄凑数。
这比"能同时开 14 个助手"更让我觉得不一样。
4.3 跑到一半,我插了一句话

任务跑起来之后我才反应过来一个致命问题。
它核实时会顺手把写得不完整的模型名补全。这本身是好事,但我打分用的是原始那份名单——训练数据里要是用了补全后的名字,学生模型学会"更正确"的写法,考试时反而被判成瞎编。
这个坑不填,整个实验就废了。
当时任务还在跑,我直接在输入框补了要求:名字一律照抄原始名单。右侧看板立刻重排出 8 项新任务,而已经干完的部分、已经查过的资料都没有重来。
做项目最怕的就是"需求一改,前面全白干"。
4.4 它交了什么

四个文件:4218 条训练数据、233 个被淘汰模型的完整名单、一份对照表、一份报告。
我最看重第二个——它把扔掉的东西也交出来了,每条都写了为什么扔。 正因为明细在,我才能自己验:原始名单 936 条里不重复的名字是 907 个,重复正好 29 个,跟它报的一模一样;936 减 233,正好等于它说的 703。
两个数字都是我用自己的脚本独立算的。它没有夸大,也没有藏。
一个把自己扔掉的东西也摊开给你看的工具,和一个只给你漂亮结果的工具,是两种东西。
五、结果
考卷是同一套,四个维度:
https://www.apodex.com/blog/apodex-1.1-scaling-agentic-intelligence-for-complex-work四列分别是什么意思,一句话说清:
- 答出了模型名——有没有正经回答,还是顾左右而言他
- 挑中唯一正确的——从九百多个里点中标准答案那一个,这是满分标准
- 名字是编的——它答了,但那个模型压根不存在,越低越好
- 至少挑对了类别——没点中具体哪个,但知道该用视频分类、还是该用语音识别
说实话,结果比我预期的好。
先看教和不教的差别——挑对的从 0.4% 到 10.7%,27 倍;瞎编的从四成压到不足两成,砍掉六成;挑对类别的从 3% 到 44%,接近 15 倍。
你可能觉得 10.7% 也不高。但这是从九百多个候选里挑唯一正确的那一个,还不许上网查——换个人来做,不查资料也答不上来几个。
再看两个老师之间:Apodex 教出来的三项全赢,挑对的多 2.6 个点,瞎编的少 2.9 个点,挑对类别的多 5.1 个点。
单看每一项差得不算悬殊,但三项同时朝一个方向,这个信号我认。而且它正好对得上 Apodex 多干的那件事——当年那批数据只能照着文档写,写完没人核对;这批每一条都真的上网验过。少编造的模型,是被少编造的数据教出来的。
更关键的是,这才第一轮。
我还没做迭代——正常做法是拿错题回去让它针对性补题,再训一轮。光是一次派活就到这个水平,往下走空间还很大。对我来说已经很说明问题了。
但真正让我在意的不是这几个点
B 组那批数据,是 Berkeley 一个研究团队当年的成果,写论文、开源、被引用。 C 组这批,是我一个人、一个下午、派了一次活拿到的,中间一条没标,还顺带被它纠正了一个我自己写错的规则。
两批数据质量相当,造出来的成本差了一整个数量级。
所以这次实验真正的结论,不是"新老师比老老师强了 2.6 个点"——是这活现在一个人就能干了。
六、跑完这一趟,我记住了三件事
第一,它会拆活,而且拆得像个人。 不是把任务平均切成 14 份,是按职责分:谁核实、谁写题、谁唱反调。
第二,它敢说你错了,而且拿得出证据。 推翻我那条规则的时候,它给的是实测、源码、重扫三条独立的证据线。这已经不是"听话干活",是"对结果负责"。
第三,"不用人工标注"到底是什么意思。 这次它上网查了大约 900 次,一条一条核实。而三年前 GPT-4 造数据,只能照着文档想象,写完没人知道对不对。
所谓"不用人工标注",不是省掉了核对这一步,是把核对交给了机器去执行。
这是我这趟最大的收获,而且可以套到任何行业——
你能不能让 AI 替你造数据,取决于你能不能给它一个"能自动判对错"的办法。
模型存不存在?上网一查就知道 → 这一步能自动化。 一道题写得像不像真人说的?没法自动判 → 所以它第一版就退化成了套模板,还是我拉回本地统计才发现的。
这条线,就是今天自动化的边界。
七、所以这对你意味着什么
回到开头那道坎:想用小模型替代大模型,卡在没有训练数据。
跑完这一趟我的判断是——这道坎正在被推平,但推平的是"能自动判对错"的那一半。
如果你的活能写出一个自动检查(能不能跑通、格式对不对、跟真实记录对不对得上),那造数据这件事现在真的可以交出去,成本会断崖式下降。
如果你的活对错全靠人拍板,那还得你自己上。
所以我给所有想走这条路的人一个建议:先想清楚"怎么自动判对错",再想数据从哪来。 顺序反了,造多少都是白造。
八、想自己试试的
论文已发布,权重已开源,现在可以直接上手了。
🛠️ 开源框架 FrontierAgent——Mac / Linux 一条命令跑起来,不用装 Docker https://github.com/ApodexAI/FrontierAgent
🤗 开放权重——Apodex 1.1 mini(35B),下到自己机器上就能跑 https://huggingface.co/collections/apodex/apodex-11
🔌 核心模型 API 免费两周——apodex-1.1 和 apodex-1.1-mini,去这里领 key https://platform.apodex.ai
另外两条:
- Agent API 首月自动 8 折
- Apodex 1.0 网页版的早期付费用户:账户里已经加了 2000 积分,不用做任何操作,直接拿 1.1 的实时工作台接着用就行
在线工作台在这里,别只是去看看——传一份你自己的表格或数据进去跑一次: https://www.apodex.ai/
相关资源
- Apodex 1.1 技术博客:https://www.apodex.com/blog/apodex-1.1-scaling-agentic-intelligence-for-complex-work
- Berkeley 那篇论文(本文对照组数据来源):https://arxiv.org/abs/2305.15334