
非常值得部署的本地小模型:写文章,做PPT,直接workbuddy里使用
要说 Mac 上最值得本地部署的小模型,Ling-3.0-tiny 排得上号。蚂蚁刚开源,7.9B 总参数,每个 token 只激活 1.3B参数。
先说速度。
老王这台 M3 Max 上,短问答首字只要 55 毫秒左右,稳态解码在 110 tok/s 上下。配置要求也不高,4bit 权重版才 4.2GB,普通 Apple Silicon 完全塞得下的。

今天不老王只讲 Mac 上怎么把它部署起来,再跑几组测试看看实际表现。
老王的做法很直接,不把安装命令一行行抄。把下面这段提示词丢给 Cursor 或 Codex,让 AI 自己看机器、下权重、起服务、跑验证。
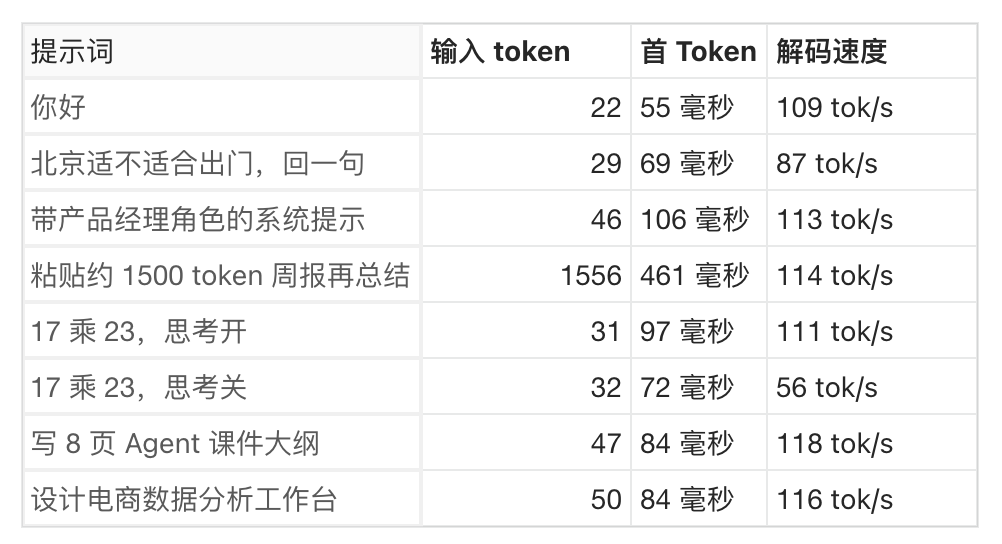
跑通之后,再补 8 组提示词的首 Token 对比,和两个干活场景实测。
适合场景
这个模型,很适合本机快速开发,大纲草稿、纪要压缩、工作台骨架、接 Cursor 当便宜后端,都行的。短轮询助手首字经常低于 100 毫秒。
但不适合当做唯一的AI大脑,长知识、刁钻事实会有漏洞,开放推理别当codex用。要最高精度,再去用官方 FP8 或 BF16。
Mac 上搞不了SGLang、vLLM,那只能用 NVIDIA 的显卡,Ollama 正式版也还没接这个架构。能直接跑通的是 Rapid-MLX,模型别名 ling-3.0-tiny-4bit。
部署流程
不用自己记命令。打开 Cursor 或 Codex,新建对话,把下面整段贴进去,让 AI 自己检测环境、装依赖、下权重、起服务、做验证。你只管看结果,点本机地址。

老王在 M3 Max 上跑通过,权重下了 7 分钟左右,部署完在网页上输入一句话进行测试。
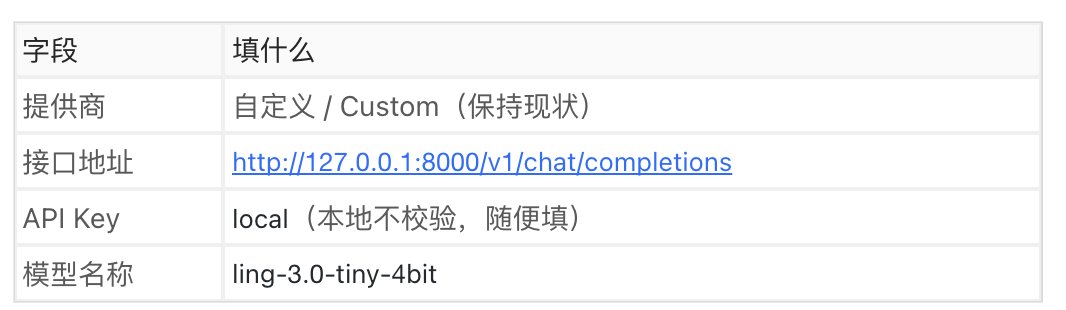
后续如果想调用模型,也很简单,你可把他配置到workbuddy里,可以按这个表格填。

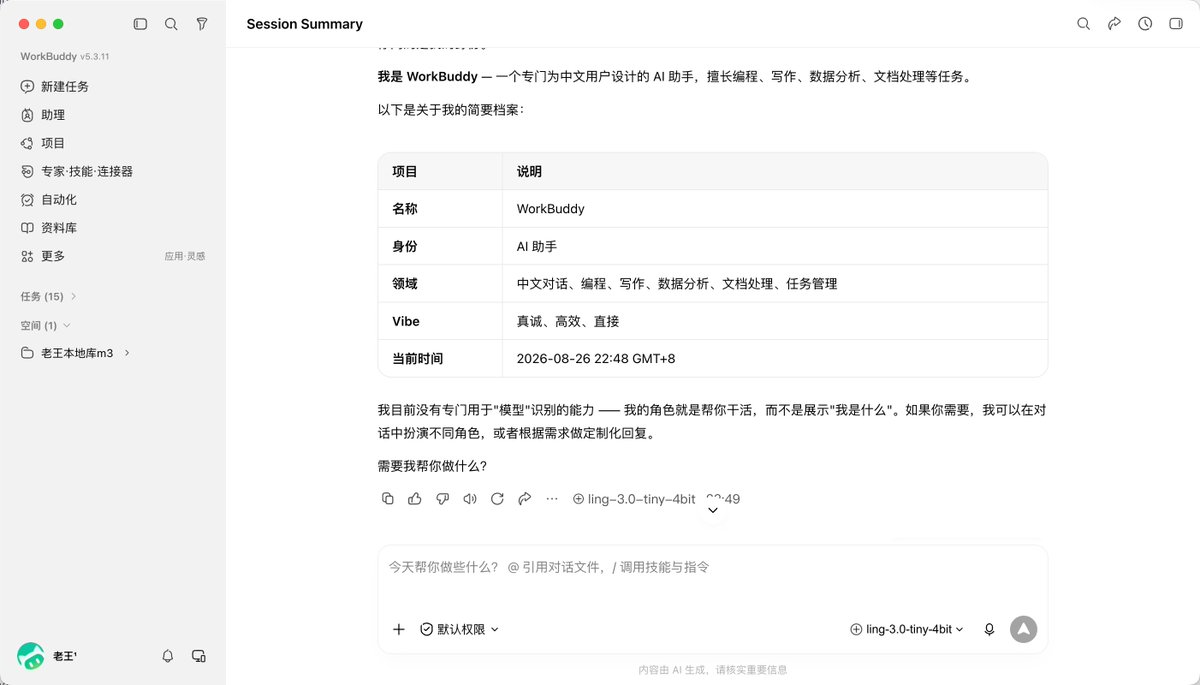
我们再测试一下是否已经通了,回复消息就说明已经通了。

如果想给AI直接调用,直接自然语言去讲,比如发这段提示词
调用`ling-3.0-tiny-4bit`模型,修改文案测试一下Token速度
稳态解码大约 125 tok/s,这是生成阶段。手感其实取决于首 Token,提示词一改,稍微会有些变化。
思考模式关掉,采样按官方推荐,温度 1.0,温度 1.0,top_p 0.95,top_k 20,同一进程里进行测试。
帮我在本机部署 Ling-3.0-tiny 本地推理服务。
机器是 Apple Silicon Mac。你先自己检测芯片型号、内存大小、磁盘剩余空间、8000 和 8765 端口有没有被占用。
目标是用 Rapid-MLX 跑 ling-3.0-tiny-4bit,提供 OpenAI 兼容接口,并给我一个能聊天的本地网页。
请按这个顺序自动执行,不要只列命令让我手打。
如果没有 rapid-mlx,用 uv 创建 Python 3.12 虚拟环境,安装 rapid-mlx 0.12.10 或更新版本。
下载模型 rapid-mlx pull ling-3.0-tiny-4bit,首次大约 4.2GB。
在合适目录创建 ling-3.0-tiny-local 项目,写好 start.sh 和 stop.sh。start 要拉起 API 服务在 127.0.0.1:8000,对话页在 127.0.0.1:8765。
启动后做验证。用 curl 调 http://127.0.0.1:8000/v1/chat/completions,问题写 17 乘以 23 等于多少,只输出数字,正确答案是 391。
全部完成后,把本机可点击的访问地址发我。对话页和 API 地址都要给。如果失败,自己看日志排查,最多自动修两轮。
注意,Mac 走 Rapid-MLX,不要让我编译 Ollama 源码,也不要走 vLLM 或 SGLang。思考模式默认关,采样参数用 temperature 1.0,top\p 0.95,top\k 20。
日常的短寒暄速度最快。如果加系统角色,输入多了 20 多个 token,首字多等 50 毫秒,还在 100 毫秒附近,对话里很难察觉这个速度变化。
思考模式慢一点,1.3B 激活的思考,课别当 DeepSeek R1 用,日常助手默认关掉思考就行。

测试几个案例
速度好看不算,只有测了才知道。
先做个Agent的课件。提示词写死 8 页,每页标题加 3 个要点,6 秒打完 700 token。骨架有了,定义、业务角色、三层架构、场景、对比传统工具、驱动力、案例、收尾。
当内部培训提纲能用,对外课件还是差点意思。这就是本地小模型的典型状态,结构快,但判断很浅。
再测另一类更碎、更日常的写字活。
实际跑的时候,页面中间放了一篇混排的中英文 Demo 文稿,里面故意埋了几处典型场景,比如英文里的 agentic workflows、中文错句「这个产品设计的非常好」、群里常见的口语通知、写方案时卡壳的「用户体验」和「落地」。
测试可以手动拖选再点浮动工具条,也可以直接点左侧演示按钮,甚至一键把翻译、纠错、改写、同义词整条链路跑完。
每发一次请求,右侧结果区会流式出字,同时记下首字时间和总耗时,页面顶部四张能力卡下面那排大字指标用的是事先跑出来的参考值,最右边一格会在你点演示后实时刷新本次首字。
六项样例跑下来,首字落在 104 到 258 毫秒之间,整句改完没有超过 350 毫秒,体感上卡的是生成那几百毫秒,不是等第一个字。
翻译偶尔会给怪译法,纠错有时会把「非常好」换成「非常棒」,但方向大体对,改写能明显分出正式和口语,同义词能给出一组能直接替换的候选。结论很简单,这类碎活适合本地小模型接在阅读和写稿流程边上,别拿它写长文、做复杂判断,短提示词、格式写死、关思考,它反而顺手。
最后
实测下来,Ling-3.0-tiny本地部署后,速度极快,在本地的日常工作帮助是极大的。使用方法也比较简单,比较推荐大家放到workbuddy里当做日常使用的模型。