
WorkBuddy Skill机制拆解|从How到Why,万字干货
最近我组了个小团队来帮我分担交付压力。作为一个AI native团队,我让团队的小伙伴都用上了 WorkBuddy(全员上Codex暂时还用不起),也教他们怎么在里面自己设计 Skill。
创建这件事本身不难。WorkBuddy 内置了一个叫 skill-creator 的技能——对,用 Skill 来创建 Skill。只要能把需求说清楚,就能创建出一个不错的 Skill。这一步,大家很快就都过了。
但创建完之后,问题才真正开始。
「我创建的 Skill 存在哪了?」
「为什么我新建了一个项目,之前的 Skill 就不见了?」
「Skill 管理里『我安装的』这一长串,都是哪来的?」
「这些 Skill 要怎么维护?会自动更新吗?我改过的会被覆盖吗?」
这些问题不是一个人问的。团队里几个小伙伴,前后撞的是同一批墙。
我后来想明白了:他们不是不会用。创建会用,安装会用,调用也会用——What 和 How 都有了,缺的是 Why。Skill 在这个软件里怎么存在、怎么被找到、怎么被加载、怎么被管理,这套机制没人讲过。
而把一件事从「会用」做到「做精」,差的从来就是 Why。
正好,前段时间我把 WorkBuddy 做了一次完整拆解。从系统提示词的拼装模板,到技能目录的加载机制,再到插件市场的分发链路,全部拆到了文件层。
这篇文章就把这些问题一次讲透——Skill 是什么、放在哪、从哪来、怎么维护。四个问题,四个机制层面的答案。
看完这篇,你再打开 WorkBuddy 的技能列表,看到的东西会不一样。

一、Skill 到底是什么:一个文件夹,一份 AI 自己会去读的文档
先校准概念。这一节不解决具体问题,但后面三个答案都建立在它上面。
打开你磁盘上的技能目录(用户级的在 ~/.workbuddy/skills/,怎么找到它下一节讲),随便挑一个技能进去看。你不会看到代码。
你会看到一个文件夹,里面躺着一到几个 Markdown 文档:

/Applications/WorkBuddy.app/Contents/Resources/app.asar.unpacked/resources/templates/workbuddy-prompt.tplSKILL.md 是技能的本体,分两段。
开头一段 YAML 元数据,只有两样东西是必需的:name(叫什么)和 description(什么时候用我)。正文是方法论,写清楚「这类任务怎么做」。
所以 Skill 主文件的准确定义是:一份写给 AI 读的方法论文档。它不运行,不编译,不需要你会任何编程。
工作过程是:模型在对话中判断当前任务匹配了某个技能的 description,就去读这份文档,然后按照文档里的方法做事。
两段结构里,description 值得单独停一下。
系统每次对话只会把所有技能的「名字+描述」放进上下文,正文要等真正用到时才读取。这是按需加载,第三节展开。这带来一个直接推论:模型是凭 description 决定要不要唤醒这个技能的。
写技能的功力,一半花在这段描述上。写清触发词,比如「当用户要求写周报时使用」;也划清边界,比如「不用于日记、月报」。

有的技能装了从来不触发,问题九成出在这段描述没写好,而不是技能正文不行。
还有一层背景值得知道:SKILL.md 不是 WorkBuddy 的私有格式,它是一个开放标准(agentskills.io 规范)。Claude、Codex、Cursor 这些工具的技能,用的都是同一套格式。
WorkBuddy 的技能格式和腾讯的开发者工具 CodeBuddy 完全同源。你会在文件层不断看到这个血脉痕迹——比如它的技能创建脚本里,默认路径还写着 .codebuddy/。
一个文件夹,一份文档,一个开放标准。这就是 Skill 的全部物质基础。
记住这个朴素的事实,接下来三个问题会好懂很多。
二、放在哪、为什么换项目就找不到:作用域,不是丢件
现在回答团队里被问得最多的问题:我创建的 Skill 存哪了?为什么换个项目就不见了?
WorkBuddy 给自建技能留了两个作用域,这是系统提示词模板里明文写的:

「为什么新建项目后技能不见了」的答案就在这张表里:那个技能当时被创建到了项目级目录。
它没有丢,就躺在旧项目的 .workbuddy/skills/ 文件夹里,只是作用域不覆盖新项目。你回到旧项目,它还在那儿。
反过来,建在用户级的技能跟着你的账号目录走,开任何项目都能用。团队小伙伴的技能「失踪案」,十有八九是这两种作用域的混淆。
别信我说的,信你自己的终端。两条只读命令,一分钟看穿你的技能都住在哪:
~/.workbuddy/plugins/cache/workbuddy-builtin/skill-expert-manager/0.1.0/第一行出来的,就是你所有项目共享的那批;第二行有输出的项目,说明团队在这里放了随仓库走的技能。这个动作建议每个用 WorkBuddy 的人都做一次——技能从界面上的名词,变成你磁盘上看得见的东西,很多困惑从这一刻就开始消解。

那创建的时候,技能会被放进哪一层?WorkBuddy 内置的 skill-creator 给了明确的判断原则:拿不准就放用户级。
理由写在它的规范里:个人工作流的大多数技能都应该跨项目可用;只有当你明确要和协作者共享——团队约定、项目专属的规范、共享的工作流——才放进项目级。
这个原则反过来读,就是团队分发的正确姿势:把需要全员一致的技能放进项目级目录,让它随代码仓库走。
新人 clone 项目、打开 WorkBuddy,老员工沉淀的方法论自动就在了。不需要培训文档说「你先去装这几个技能」,技能清单本身变成了项目基础设施的一部分。我们团队现在就是这么做的。
再往深一层。如果你不止用 WorkBuddy 一个 Agent,还会遇到第三层目录:.agents/skills/。
这是行业里正在形成的跨 Agent 互操作约定。Codex 把它作为原生主目录,Cursor、GitHub Copilot、VS Code 都官方支持读取它。意图很明显:技能装一次,所有 Agent 共享。
有个社区评论把现状说得很准:「The spec unified us. The paths divided us.」——规范统一了我们,路径分裂了我们。
SKILL.md 的格式标准已经统一,但每家工具默认读取的目录还不一样:Claude Code 读 .claude/skills/,WorkBuddy 读 .workbuddy/skills/。
所以重度用户的常见做法是:一份技能库放在一处,用软链接或同步脚本打通到各家目录。我自己就是这么干的——技能资产放一份,多个 Agent 各自可见。
这也解释了一个容易让人迷糊的现象:我这台机器上,~/.workbuddy/skills/ 里有 68 个条目是软链接,指向 Vault 里的 .claude/skills/。WorkBuddy 照样把它们当技能加载,界面也会展示它们。
所以别把「技能在哪个目录」理解成「文件一定复制到了哪个目录」。更准确地说:目录是入口,文件可以在别处,入口负责让当前 Agent 看得见它。

最后交代一个诚实标注:如果同名技能在多层目录同时存在,WorkBuddy 优先用哪个?这一点我拆解时没有拿到运行时证据,官方文档也没写。
要验证很简单:做一个同名探针技能,分别放进两层各试一次,答案就出来了。这里按拆解的规矩来——不知道的就说不知道。
三、「我安装的」那一长串从哪来:先分清入口、来源和落点
第三个问题最普遍也最隐蔽。打开 Skill 管理的「我安装的」列表,里面几十个技能,很多你压根没印象装过。它们哪来的?
我这台机器上显示 94 个。第一反应可能是:我怎么装过这么多?
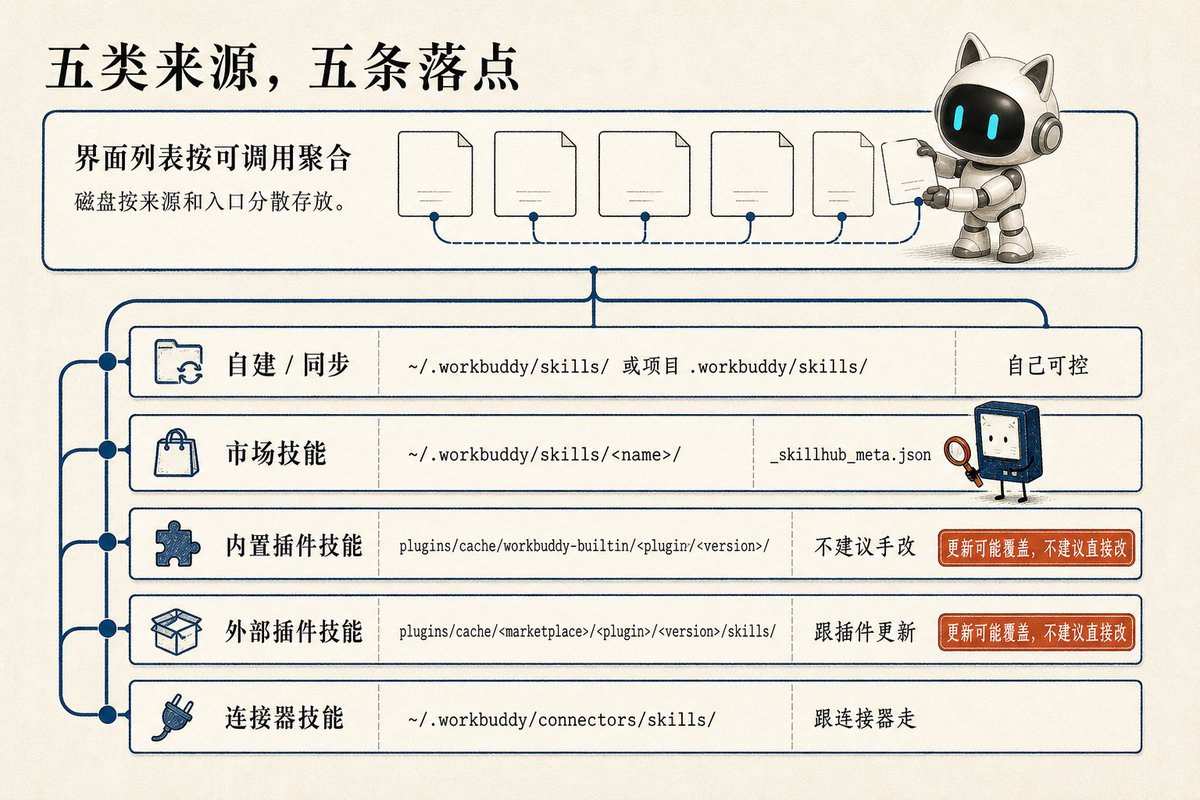
把文件层翻开后,这个数字就不神秘了。「我安装的」是一个聚合视图:只要当前能被 WorkBuddy 调用,界面就把它列进来。它的磁盘来源至少有五类。
来源一:自建和同步进来的技能。
落点是两层技能目录:
- 用户级:~/.workbuddy/skills/<skill-name>/
- 项目级:<项目目录>/.workbuddy/skills/<skill-name>/
这里面既有 AI 帮你创建的,也有你手工导入的,还有像我一样从别的 Agent 目录软链接或同步过来的。它们不一定都「安装」过,但都会进入列表。
来源二:内置插件携带的技能。
WorkBuddy 出厂自带一批内置插件,其中一部分插件的职责就是提供一个技能。它们的落点不在 ~/.workbuddy/skills/,而在用户配置目录的插件缓存里:
~/.workbuddy/skills/<skill-name>/我实测的 5.3.14 版本里有 18 个 skill-* 内置插件:skill-creator 负责创建技能,skill-marketplace-skill-installer 负责安装技能,skill-expert-manager 管理专家,再加上设计、办公、财务等能力。
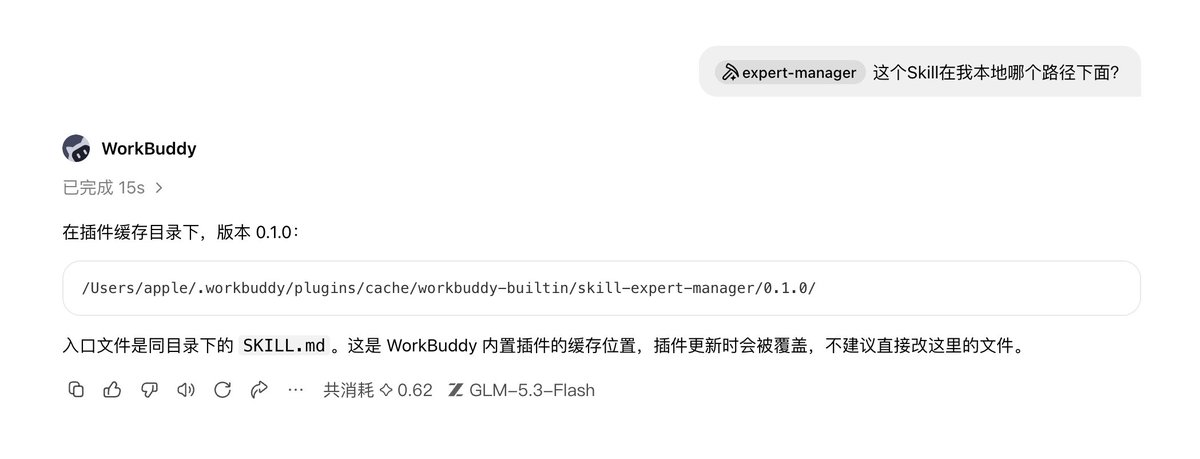
这里正好拿 expert-manager 举例子。你在商店的「我安装的」里搜索它,可能找不到;但在对话里用斜杠命令能调出来。问它本地路径,答案在这里:

~/.workbuddy/plugins/cache/<marketplace>/<plugin-name>/<version>/skills/<skill-name>/这不是列表出错,而是「可调用」和「可搜索到」不是同一个界面口径。内置插件技能由运行时装载进技能列表,不一定作为商店里的独立安装项展示。
来源三:技能市场安装的技能。
WorkBuddy 有推荐技能市场。你在界面上点「安装」,或者对话里说「帮我装个飞书套件」,通常落到用户级技能目录:
| 层级 | 路径 | 生效范围 |
| :--- | :--- | :--- |
| 用户级 | `~/.workbuddy/skills/` | 你这台电脑上的所有项目 |
| 项目级 | `<项目目录>/.workbuddy/skills/` | 只有当前项目,随项目文件夹走 |
但它的目录里会多一个来源标记文件:
~/.workbuddy/plugins/cache/workbuddy-builtin/<plugin-name>/<version>/我这台机器上,deep-research、browser-use、mx-finance-search、微信读书助手 都带 _skillhub_meta.json。第四节的更新保护就靠这个文件。
| 来源 | 常见落点 | 识别特征 | 维护含义 |
| :--- | :--- | :--- | :--- |
| 自建/手工导入 | `~/.workbuddy/skills/`、项目 `.workbuddy/skills/` | 本地目录,AI 创建可带 `agent_created: true` | 自己完全可控 |
| 跨 Agent 同步 | 上述目录里的软链接 | `readlink` 能看到真实路径 | 改源目录,多端生效 |
| 内置插件技能 | `~/.workbuddy/plugins/cache/workbuddy-builtin/.../<version>/` | `workbuddySeedManaged: true` | 随产品/内置插件更新覆盖,不建议手改 |
| 市场技能 | `~/.workbuddy/skills/<name>/` | `_skillhub_meta.json` / `_knot_meta.json` | 有更新与用户修改保护 |
| 外部插件技能 | `~/.workbuddy/plugins/cache/<marketplace>/<plugin>/<version>/skills/` | 跟随插件清单 | 跟插件更新走 |
| 连接器技能 | `~/.workbuddy/connectors/skills/` | 连接器安装目录 | 跟连接器走 |
后一种安装方式不是修辞。WorkBuddy 内置了一个专门管安装的技能 marketplace-skill-installer,它的规范我拆出来看过:你说「帮我装个飞书套件」,它先在市场里搜索,单一命中就直接装;多个候选就列出来让你挑;已经装过的会告诉你当前版本,有新版时问你要不要更新——连版本新旧都替你判断好了。
来源四:外部插件捎带的技能。
这是最容易被忽略的一块。插件安装时可以携带自己的技能,落点在对应插件市场缓存:
比如 find-skills 在:
ls ~/.workbuddy/skills/ | head -20        # 你的用户级技能库
ls <项目目录>/.workbuddy/skills/ 2>/dev/null   # 当前项目的专属技能
插件市场的索引和列表在:

~/.workbuddy/plugins/cache/codebuddy-plugins-official/find-skills/1.0.0/skills/find-skills/我数了下本机:44 个插件分布在 4 个市场,插件缓存里有 58 个 SKILL.md,其中 26 个是 skills/*/SKILL.md 这种嵌套形态。你装插件是为了一个功能,附带收到了几个技能。「我安装的」列表悄悄变长,大多是这个原因。
还有一类更容易漏掉:连接器也能携带技能。我这台机器上有一个 fbs-connector,落点在 ~/.workbuddy/connectors/skills/。

四类来源拼起来,就有一张排查表:
_skillhub_meta.json   # SkillHub / BuiltinMarket 来源
_knot_meta.json       # Knot 来源
这张表也解释了为什么「我安装的 94 个」和你在某个目录里数出的数字对不上:界面按可调用技能聚合,磁盘按来源和入口分散存放。
这台机器能数出的技能候选远不止 94:用户级入口 75 个、当前项目入口 73 个、插件缓存 58 个、连接器 1 个,中间还有同名、软链接、嵌套和禁用状态。94 是 UI 过滤后的数字;它具体怎么去重、怎么过滤,文件层没有直接证据。

这就是 Why 的价值:知道列表是聚合出来的,排查就有了物理路径。找不到某个技能,先问它来自哪个来源,再去对应的目录看它在不在。
这里必须讲那条我在拆解时觉得最意外的发现。
WorkBuddy 的系统提示词模板里,写着一条加粗的死命令,大意是:当你遇到做不了的事,第一个动作必须是调用 find-skills 去技能市场搜一圈;搜完确认没有合适的技能,才允许对用户说「我做不了」。
这个模板不是配置文件,它在应用安装包里:
你可以直接打开看原文。版本升级后,这个文件会随应用包更新。
把这句话翻译一下:产品把「先找技能」写进了 AI 的行为准则。
模板里连触发场景都列好了:用户想操作原生应用(邮件、日历、备忘录、通讯录),用户要做系统级的流程自动化,或者 AI 自己的第一反应是「我没有权限做这个」——这些时刻,都必须先触发市场搜索,而不是直接拒绝你。
你的技能列表会自己生长。一半是你主动装的,另一半是 AI 在干活途中发现能力缺口、自己去市场上找回来补上的。
这不是 bug,是产品意志——WorkBuddy 的能力边界被设计成可扩展的,技能市场就是它的补给线。
来源说完了,还有个大家关心的实际问题:装这么多技能,上下文装得下吗?
这就回到了第一节埋的伏笔——按需加载。系统每次对话只把所有技能的「名字+描述」放进上下文,一行一个;完整的方法论文档,等你真的做这类任务时才被读取。
用一份目录,换一整座图书馆的按需取用。装一百个技能的日常成本,就是一百行门牌。
这也是为什么 description 那么重要:它是门牌,门牌写不清,这本书就永远没人翻。

四、怎么维护:一套你可能从没见过的生命周期标记体系
第四个问题最见功力。
技能多了之后的维护——改了会不会被覆盖、AI 创建的和市场装的能不能混着管、团队怎么统一升级——答案藏在文件层的一套标记体系里。拆解之前,我也不知道 WorkBuddy 把这件事设计得这么细。
先看 AI 创建的技能。
skill-creator 的规范里有一条硬要求:凡是由 Agent 创建的技能,frontmatter 必须带上 agent_created: true 标记。
| 技能来源 | 有无标记 | 改动会被更新覆盖吗 | 正确的维护姿势 |
| :--- | :--- | :--- | :--- |
| 你自己创建/手工导入 | 无 | 不会(没人动它) | 随便改,改完即时生效 |
| AI 帮你创建 | `agent_created: true` | 不会 | 对话里让 AI 改,标记体系自动接管 |
| 市场安装、没改过 | meta 文件 | 会,自动更新 | 想定制就先改一次,触发保护 |
| 市场安装、你改过 | meta + `userModified` | 不会,更新前先问 | 放心改;要升级时同意覆盖即可 |
| 插件携带技能 | 插件清单/缓存标记 | 可能随插件更新替换 | 复制出来改,别直接改 cache |
这个标记是给谁看的?给管理系统看的。带这个标记的技能,后续可以被 Agent 安全地修改、迭代、甚至删除。
换句话说,AI 生成的资产自带「可被 AI 管理」的出生证明。你在对话里说「帮我改一下那个周报技能」,Agent 会先看标记,确认这个技能是创建体系里的一员,再动手。
再看市场安装的技能。
每个从市场装的技能,目录里都躺着一个来源标记文件。我实测见到两种:_skillhub_meta.json 和 _knot_meta.json,对应两条供给线。
这个文件解决的是维护中最让人担心的事:你手改过的技能,会不会被市场更新悄悄覆盖?
WorkBuddy 的机制是:当 Agent 帮你改完一个市场技能,它会同时往标记文件里写入 userModified: true。从此市场更新到这个技能时,不再静默覆盖,而是先问你。
这不是我猜的。设置页写得很直白:技能自动更新开启后,会把已安装技能更新到最新版本,但不会更新你在 WorkBuddy 中编辑过的技能。
skill-name/
├── SKILL.md          ← 必需,技能本体
├── scripts/          ← 可选,可执行脚本
├── references/       ← 可选,参考文档
└── assets/ ← 可选,模板等资产文件你自己创建的技能没有这些标记文件,也不需要。它们就是你磁盘上的普通文件夹,随便改,没有谁会来覆盖你。
插件缓存里的技能要单独提醒。expert-manager 这类内置插件技能位于版本化 cache 目录,插件或应用更新时可能整目录替换。想定制,建议复制成自己的技能放进用户级或项目级目录,不要直接改 cache。
几类落点拼起来,就是一套维护策略:
~/.workbuddy/plugins/installed_plugins.json
~/.workbuddy/plugins/marketplaces/
还有一个团队场景的刚需:分发。两条官方路径。
轻量做法是项目级目录随 git 仓库走,上一节讲过。正式做法是用 skill-creator 自带的打包脚本,把技能目录打成一个 zip 包,谁要就发给谁,导入即用。
维护的高级形态,是让技能在使用中被复盘、被优化。
我自己有个习惯:在 Agent 的系统提示词里常驻这样一段话——
端到端使用 Skill 后必须复盘,检查是否有可由 Skill 修正的问题;存在明确优化项时说明建议,并询问是否修改。
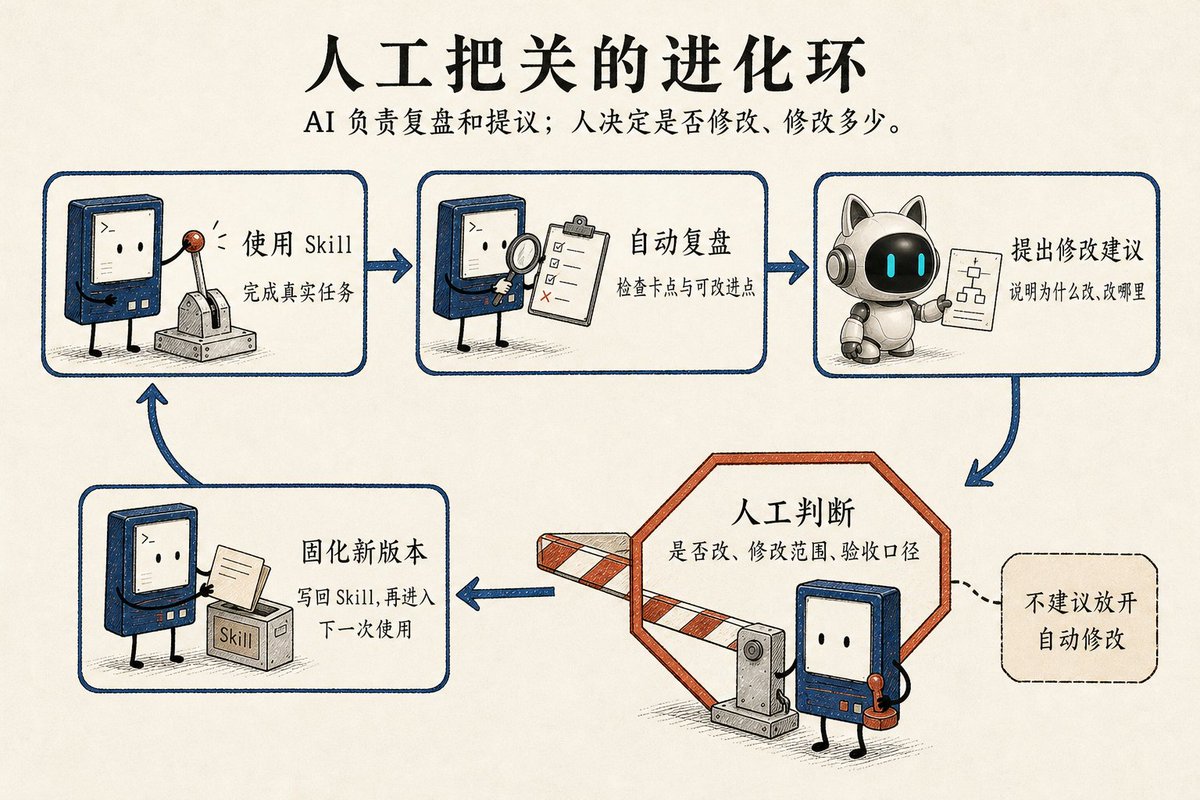
这段话把「复盘」从我该记得做的事,变成了 AI 每次用完技能必须执行的义务。
每次完整调用一个技能,AI 都会检查:这次有没有卡点?这个卡点能不能靠改技能解决?能解决就给出修改建议,问我要不要改。
每一次使用,都变成了一次免费的技能审计。
WorkBuddy 官方也认可这条方向。设置里有一个「本地技能与记忆沉淀」开关,说明写得直接:自动记录本地记忆、工作日志,自动沉淀和优化技能。

但我建议先别急着打开它。
自动沉淀和自动优化解决的是「有没有复盘」,不解决「该不该改、改到什么程度」。技能一旦承载团队规范,一个自动改动就可能影响所有人的输出口径。
我更愿意用上面那段系统提示词:让 AI 必须审查和提议,让人决定是否修改、修改多少。这样保留了复盘的强制性,也保住了变更的确定性。
顺便注意,这段话我放在系统提示词里,而不是做成一个技能。因为它「永远适用」,不是「有时适用」。
这是技能和规则的分工线:技能按需进场,规则常驻在场。管「怎么做某类任务」的写成技能,管「每次都要遵守什么」的写成规则。
判断不难:永远适用进规则,有时适用进技能。
技能不是设计出来就定型的。别指望第一版完美——没有人能做到,因为技能面对的任务场景是长尾的、变化的。
设计给你第一版,使用给你第一百版。让使用的过程自动产生迭代信号,技能就开始复利了。
顺便说明,官方教程《实践八:自我进化——创建自己的 Skills》讲的是把可复用经验创建成 Skill,不是说 Skill 会自动完成自我进化。真正的进化机制还是要靠使用、复盘、人工判断、再固化。
产品提供的是材料:使用记录、沉淀入口、优化能力。闭环要靠人来完成:你负责实践和判断,AI 负责固化、复盘和提议修改。

五、从 Why 回到 How:一条被机制校准过的工作流
机制讲完了,把它落回团队小伙伴最初的问题。创建技能的完整工作流,市面上教程不少,但懂机制之后的做法,有几个不一样的关键动作。
我的工作流是这样的:
第一步,先带着 AI 把任务从头到尾做一遍。
注意顺序——不是先写技能再干活,而是先真刀真枪把活干成。
你和一个真实任务缠斗的过程,就是在收集「怎么做才是对的」的一手证据:哪一步容易错、用户实际要什么、什么标准算合格。跳过这一步直接让 AI 生成技能,得到的是一份没经过检验的想象文档。
第二步,做成之后,让 AI 固化最短成功路径。
把整个成功过程交给它提炼:哪几步是必要的,哪些弯路可以砍掉,验收标准是什么。
「最短成功路径」是这里的关键词——不是把过程全录下来,而是去掉失败探索之后,那条被验证过能稳定走通的路径。技能固化的应该是它,不是想法。
第三步,认真回答 AI 的对齐提问。
生成技能前,AI 会反过来问你几轮:这个技能什么时候用?什么时候不用?输出标准是什么?装到哪一层?
这几轮问答看着琐碎,实际是在打磨 description。你回答「不用于什么」的质量,直接决定它写的门牌清不清楚。
这是整个流程里你唯一不能外包的环节:判断产出是否合格、划清边界,这两件事只有做成了这件事的人能回答。
第四步,生成,并选对作用域。
个人工作流进用户级,团队约定进项目级。这个决策第二节讲透了,不再展开。
生成之后,我建议每个人至少做一次这个动作:打开那个 SKILL.md,亲眼看一遍。
你会看到第一节讲的 frontmatter 和正文,看到第三步的问答变成了 description。
这个动作的价值是校准判断力。以后 AI 给你生成技能,你扫一眼门牌就知道边界划没划清、触发词全不全。
工具抹平了写技能的门槛,但判断技能好坏的眼光,得自己长。

这套工作流跑顺之后,团队的变化很具体:小伙伴不再问「技能去哪了」,而是会问「这个技能应该放项目级还是用户级」。
不再抱怨「列表里怎么多了个东西」,而是知道去查它带没带市场标记。
问题从情绪变成了判断。这就是 Why 的回报。
六、收个尾:工具会换,机制认知跟着你走
回到开头。团队小伙伴的四个问题,现在都有了机制层的答案。
Skill 是一份给 AI 读的方法论文档;放在两层作用域和多个插件缓存里,入口决定它在哪里出现;列表是多个来源的聚合,还会被 find-skills 悄悄喂大;维护靠一套标记体系,高级形态是在使用中复盘、由人决定怎么进化。
这些答案没有一个是「WorkBuddy 使用技巧」。它们是 Skill 这种资产的运行机制。
而机制认知的保值程度,远高于任何单一产品。SKILL.md 是开放标准,Codex、Cursor、Claude 用的同一套格式;WorkBuddy 的技能体系和 CodeBuddy 同源互通;.agents/ 互操作目录正在把「装一次、处处可用」变成行业现实。
工具你已经会换了,认知应该跑在工具前面。
这次拆解的完整版——系统提示词怎么拼装、记忆怎么分三层注入、专家怎么接管人格、插件能往你对话里注入什么——我整理成了一份蓝皮书,以后找机会单独讲。这篇文章只取了 Skill 这一个切面,因为它是普通人唯一能亲手生产、也最值得亲手生产的部分。
会创建一个 Skill,是 What;会走完创建的工作流,是 How;知道它存在哪、怎么被找到、怎么被加载、怎么被维护,是 Why。
What 和 How 会过时——工具每两个月换一版界面。Why 不会,它跟着标准走,跟着机制走。
把一件事做精的,从来是 Why。
对团队来说,这笔账更清楚:每个成员在工作中被固化的经验,都落在项目级目录里。随仓库沉淀、随版本演进、随新人自动就位。
人员的流动带不走它。因为它早就不是某个人的技巧,是团队的资产。
这也是我现在教团队的方式:不教「点哪里」,先讲「为什么是这样」。
点哪里,AI 会教;为什么,得有人拆过才知道。
(完)
