
用了 GPT 两年半,这次更新第一次让我有点后背发凉(6.0超详细解读)
你好,我是陈硕:从2024年就开始使用gpt,4o时代,claude时代,远没有这次跟新给我带来的幻觉重大,原本我是从来不写更新文章的,但是这次我不得不写
- 发布片链接:
- https://openai.com/index/gpt-6-astra/?video=1222553704

核心结论
https://openai.com/index/gpt-6-astra/GPT-6 Astra 最重要的变化,不是“回答更聪明”,而是能把推理、浏览、电脑操作、代码执行、质量检查和专业交付接在同一条连续任务里。
它正在把 AI 的竞争单位,从一条 Prompt,推向一条可验收的工作流。
对创业者来说,真正会被重新定价的,是执行力:谁能把输入、工具、权限、验收标准和人工确认做成系统,谁就能把更强模型变成持续产能。

这次更新最值得关注的 4 件事

OpenAI 将 Astra 定位为面向“最困难端到端工作”的模型,覆盖复杂推理、编码、电脑操作、研究与文档创建。
官方发布链接👉查看官方发布
https://openai.com/index/legora-financial-statement-review-with-astra/能力跃迁 1:电脑操作开始接近“完成任务”
过去的电脑使用模型,更多是“看见按钮、帮你点一下”。GPT-6 Astra 更重要的提升,是在任务很长、页面很多、需要不断判断的情况下继续往前走。
官方公布的 OSWorld 2.0 离线评测中,Astra 为 72.6%,GPT-5.6 Sol 为 65.7%;官方延迟模拟中,每个任务约 40 分钟,Sol 约 75 分钟。OpenAI 还称,更新后的 Codex 执行框架结合 Astra 后,在 Mind2Web 上达到现有 Sol 体验约 1.9 倍的完成速度👉官方数据
这意味着它更适合接这些活:
- 在多个网页之间搜集、核对和整理信息
- 在 CRM、表单、后台里完成重复性的标准操作
- 打开浏览器验证网站功能、发现明显问题
- 安装软件、跑测试、根据屏幕反馈继续排错
但别误会:这不是“电脑操作已经 100% 自动化”。真实业务里有登录、权限、网络波动、反爬、非标准页面和异常情况,依旧需要人工兜底。
能力跃迁 2:从内容生成,走向专业交付
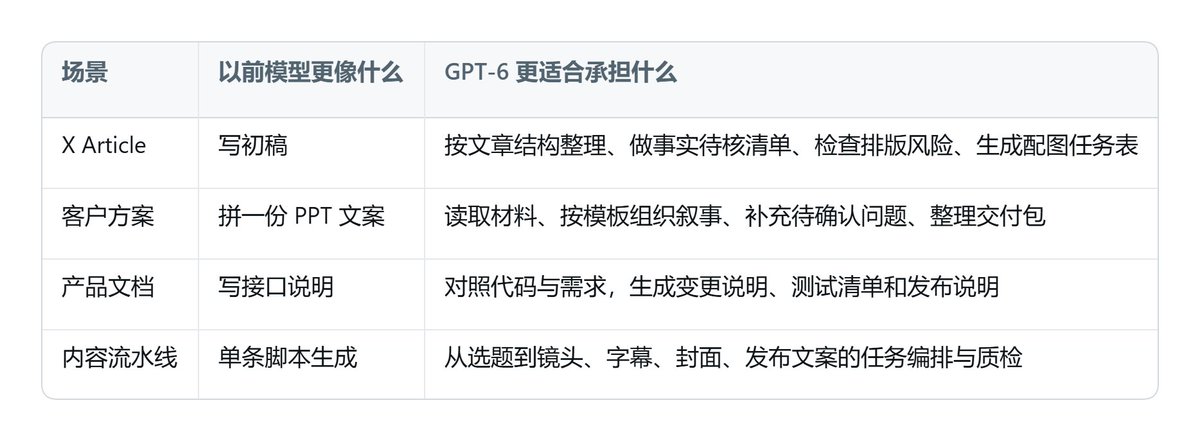
GPT-6 Astra 的一个关键方向,是更好地遵循既有模板,匹配写作与视觉风格,并只抽取任务真正需要的上下文。
这对内容团队非常关键。以前 AI 能写一篇像样的文章,但经常还要人再去:统一结构、补齐数据来源、改版式、对照品牌口吻、压缩废话、整理成可以发出去的成品。
现在更合理的预期是:让 Astra 产出“可审阅的半成品”。
OpenAI 的 Legora 客户案例称,Astra 一次 Agent 运行审核了 41 份文件,找到了 4 个植入错误;该金融报表流程较前一模型提升近 40%,但其所有任务的平均提升约 3%。这说明:结构清楚、结果可核验、跨文件对照的流程,收益可能很大;泛化到所有业务,提升不一定同样夸张。
案例原文
https://developers.openai.com/api/docs/models/gpt-6-astra https://developers.openai.com/api/docs/guides/latest-model能力跃迁 3:长任务不再只靠“压缩摘要”
长任务最怕的不是上下文不够,而是模型在第 50 步忘记前 10 步为什么这么做。
OpenAI 介绍,Astra 在 Codex 里可在上下文窗口满后保留笔记,并搜索较早的对话、工具输出和测试结果,而不是反复压缩成一段可能丢失细节的摘要。该能力目前仍是实验性功能,官方称会逐步成为 Astra 的默认能力。官方说明
对 Builder 最直观的价值:
- 大仓库重构时,模型更容易记住此前失败过的方案和约束
- 多份客户材料汇总时,模型更容易回查来源而不是重新猜
- 长内容生产时,模型更容易维持选题、脚本、风格与发布要求的一致性
能力跃迁 4:更像一个会调度的 Agent
API 侧的更新也很重要:
- ⏳ 异步工具调用:慢工具执行时,模型可以继续处理不依赖该结果的部分。
- ↪️ 中途转向:任务进行中可插入新要求,不用完全从头开始。
- 🎚️ 动态调整推理等级:可以在对话中提高或降低推理强度,同时尽量保留缓存。
这类能力会让“资料搜集 → 生成 → 渲染 → 校验 → 等待人工确认”的链路更自然。它不是一个简单对话,而是一条允许中间插队、并行执行、继续恢复的任务流。开发者迁移指南
数据怎么看:强,但别把评测当成交付保证
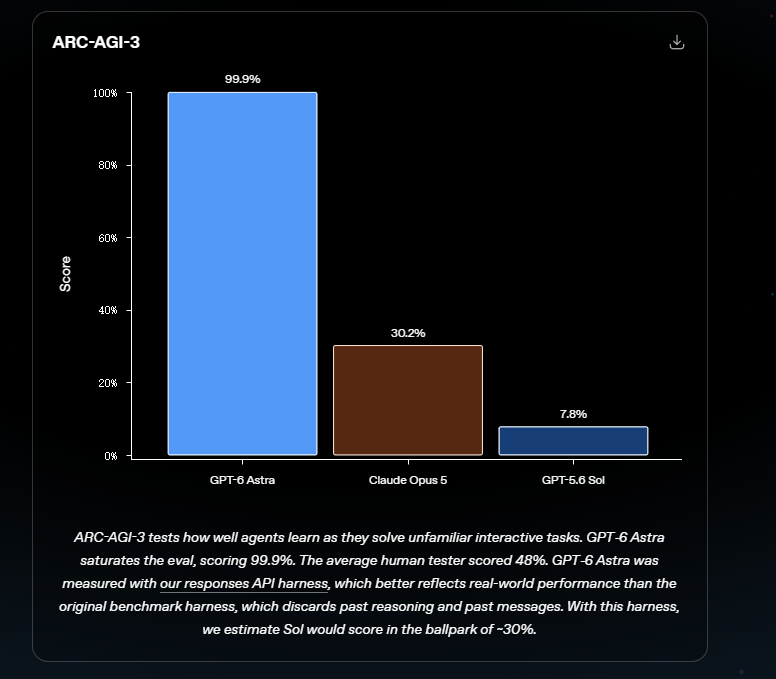
以上数据均来自 OpenAI GPT-6 Astra 发布页。官方也明确说明,评测是在特定工具、系统提示词和环境下取得的结果,生产 ChatGPT 体验可能存在差异。
对 AI 创业者最现实的机会
1.(我个人) 把 GPT-6 当“总导演 + 质检员”,不要当低成本流水线工人
https://developers.openai.com/api/docs/guides/latest-model对于 cs-board 这类内容生产系统,最合理的分工不是用 Astra 替代本地生图、TTS 或渲染,而是让它负责:
- 选题拆解、任务编排、异常判断
- 脚本与镜头一致性检查
- 跨素材、字幕、封面、发布文案的质量门
- 最终交付清单与待人工确认项
本地模型和固定工作流继续负责:
- 批量图片/视频生成
- TTS 与声音克隆
- 渲染、合成、归档
- 高频、成本敏感的批量执行
人继续负责:
- 选题判断与 IP 表达
- 最终风格定稿
- 事实、风险和商业决策
- 对外发布确认
一句话总结下来就是:Astra 做高价值环节的调度与质量门,确定性工作流做高频执行,人做关键判断。
2. 真正的护城河会变成“流程资产”
模型会持续升级,但下面这些会留在你自己的系统里:
- 输入标准:客户/素材进来时如何结构化
- 任务标准:什么叫完成,什么叫不合格
- 权限标准:哪些工具能读、哪些能写、哪里必须停下
- 质量标准:要检查哪些事实、格式、风格和业务指标
- 回滚标准:出错后如何恢复与复盘
会写提示词的人会越来越多;能让 AI 稳定完成一条业务链路的人会越来越少。
https://openai.com/index/gpt-6-astra/产品与 API:落地前必须知道的约束
资料来源👇
模型页与价格 · API 迁移指南
迁移常见坑:
- temperature、top_p、top_logprobs 等参数需要按官方指南移除。
- 需要工具调用时,优先使用 Responses API。
- EU 数据驻留不支持 Fast mode;Fast mode 不提供延迟 SLA。
- 更高的单 token 单价不一定代表任务总成本更高:如果返工和输出 token 下降,总成本可能更低,但必须用真实日志验证。
安全边界:权限设计已经是产品功能
OpenAI 表示,Astra 是其首个达到“关键级”网络安全能力阈值的广泛部署模型。公开版本可协助安全审查与修补,但会拒绝更高级的漏洞利用任务;生产中还加了对潜在失准行为的监控。安全概览
对普通团队最重要的提醒:模型能不能做,和模型有没有被授权做,是两回事。

最小权限、操作日志、回滚能力、人工确认,这四件事不会因为 GPT-6 更聪明而过时,反而更重要。
最终判断
GPT-6 Astra 的发布,不等于一夜之间出现了全自动公司。
它更真实的意义是:小团队第一次可以用更少的人,把原本需要跨多个工具、多个岗位才能推进的工作,做成一条可执行、可追踪、可复用的系统。
现在最值得做的,不是花很多时间测试“它到底有多神”,而是挑出你业务里最成熟的一条链路,明确:
输入是什么 → 谁能决定 → 哪些工具能调用 → 什么算完成 → 哪里必须人工确认。
模型会持续换代,流程资产会留在你的系统里。
陈硕在做的事情 👉https://everlightai.top/