
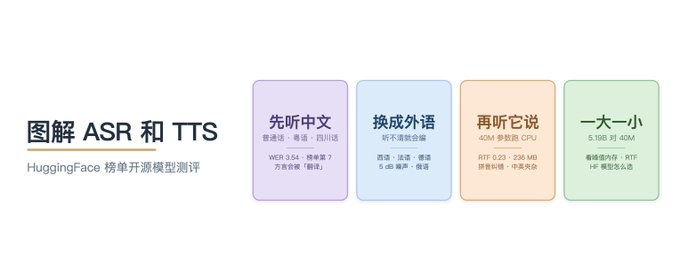
图解 ASR 和 TTS:HuggingFace 开源模型测评
核心问题:HuggingFace 上多语种榜单第一、本地可运行部署的开源模型表现如何?
姊妹篇:《图解大模型部署》
HuggingFace 被英伟达以 130 亿美元收购的消息,把这座开源模型宝库又推上了热搜。那我们不妨顺手挖一挖:这里面有没有真正实用、能在本地跑起来的宝藏?
今天我们不拆架构,直接看看在Open ASR Leaderboard 多语种榜上,WER超过 Azure、ElevenLabs 这样的闭源 API的Hojo-ASR-Multi-V1,直接听听它在各种语言表现如何,哪里表现好?哪里会踩坑?
主角只有两个:
- 负责听的 Hojo-ASR-Multi-V1
- 负责说的 Hojo-TTS-Light-40M
前者支持德、法、西、意、葡语,以及普通话、粤语等;后者则是一个可以在 CPU 上运行的 ONNX 小模型。均可以在内存16GB或以上的 MacBook 上跑。
文章最后,我们会附上 HuggingFace 上顶尖 ASR 和 TTS 模型推荐,都可以本地跑起来。
一、先听中文
普通话
第一句,一个字不差。
「这并不是告别,这是一个篇章的结束,也是新篇章的开始」,朗读腔,干净录音,非常完美。
第二句,一片红,但实际都对。
参考文本写「2011 年 8 月」,模型写「二零一一年八月」。「15 米」变成「十五米」,它其实没听错任何东西,只是换了一种写法。
粤语
粤语正字,全对
「又好似一直都等唔到咁噃」,这句里的「唔」「咁噃」都是粤语专用字,普通话里不会这么写。模型没有拿普通话去硬凑,而是正儿八经学过粤语怎么去听写。
专有名词翻车,但骨架基本正确
「俏郎君几时偷咗个西门剑法嘅剑谱啦喂」,模型写成「超狼军几时偷咗个西门剑法嘅剑谱啦喂」。「几时」「咗」「嘅」「啦喂」全对,只有开头那个名字变成了三个同音字拼出来的怪词。人名、剑名、地名,是这类模型最稳定的失手点:训练时没见过的名字,它只能靠音去猜。
四川话
五个字,整句变成英语。
| 场景 | 模型 | 参数 | 许可 | 链接 |
| --- | --- | --- | --- | --- |
| 中文,CPU 端侧,固定音色 | Hojo-TTS-Light-40M | 40M | Apache-2.0 | [https://huggingface.co/HojoAI/Hojo-TTS-Light-40M](https://huggingface.co/HojoAI/Hojo-TTS-Light-40M) |
| 中文,CPU 端侧,要克隆 | Hojo-TTS-Light(80M) | 80M | Apache-2.0 | [https://huggingface.co/HojoAI/Hojo-TTS-Light](https://huggingface.co/HojoAI/Hojo-TTS-Light) |
| 高质量克隆,可商用 | CosyVoice2-0.5B | 0.5B + 100M | Apache-2.0 | [https://huggingface.co/FunAudioLLM/CosyVoice2-0.5B](https://huggingface.co/FunAudioLLM/CosyVoice2-0.5B) |
| 树莓派级 CPU | Piper | 15–28M | 权重 MIT,但 G2P 依赖 espeak-ng,分发的二进制是 GPL | [https://huggingface.co/rhasspy/piper-voices](https://huggingface.co/rhasspy/piper-voices) |
| 英文小模型 | Kokoro-82M | 82M | Apache-2.0,G2P 同样依赖 espeak-ng | [https://huggingface.co/hexgrad/Kokoro-82M](https://huggingface.co/hexgrad/Kokoro-82M) |
「诶呀好巴适」模型写的是「hey how about that」。两秒多的短句,纯方言词,没有上下文可参考。解码器手里最强的先验是一个文本大模型,它一时拿不准,就按英语的音节把这几个音拼了
| 语料 | 语种 | CER(越低越好) | 主要错在哪 |
| --- | --- | --- | --- |
| FLEURS 普通话 | 普通话 | 6.64% | 几乎全是数字写法 |
| 同上,中文数字折回阿拉伯数字 | 普通话 | 2.33% | 真正的听错 |
| WenetSpeech-Yue | 粤语 | 4.03% | 专名 |
| WenetSpeech-Chuan | 四川话 | 25.83% | 方言虚词被改写,外加一句整句切英语 |
接下来这一段句子通顺,但是意思变了

原话是「不过想到嘞点儿,可能你会问,身体的疼痛用手楞个捂上一捂」,模型写成「不过想到那点儿,可能你会问,身体的疼痛用手能够捂上一捂」。
「楞个」是四川话的「这样、怎样」。「用手楞个捂上一捂」是「用手这样捂一捂」。模型改成了「用手能够捂上一捂」,读起来毫无破绽,意思却从「怎么捂」变成了「能不能捂」,「嘞点儿」变「那点儿」也是同样的问题。
三组中文的错误率
我们同一套评分方法,八句一组,评价一下普通话、粤语和四川话的表现:
二、换成外语
西班牙语,逐字全对

「Las escenas se proyectan en las pirámides y todas ellas son iluminadas」,连重音符号都在。
法语,专名也对
「Le groupe Aerosmith a annulé les derniers concerts de sa tournée」,乐队名 Aerosmith 并没有被拆成两个词,榜上的 3.54 可谓实打实。
德语,一句流畅的错话(噪音明显的case)
原句「Es kommt zum Showdown in Gstaad」,意思是「决战将在格施塔德上演」。Showdown 是英语借词,Gstaad 是瑞士小镇,两个都是低频词。模型写成「es kommt zu schwerwiegenden Schäden」,意思是「将造成严重损害」。前三个词一模一样,但后面整段换成了德语里最常见的一种说法,可惜是错误的。
5 dB 白噪声,英语变成西班牙语
白噪音对英语听写影响挺大的,这段英语是「Twentieth century research has shown that there are two pools of genetic variation: hidden and expressed」,加上 5 dB 白噪声之后,模型写出「james sanchez y luis chavez son la tercera posición en la televisión británica en esta pasada」。
有趣的是,更早先的V1(非Multi版本)能识别的更好:
| 场景 | 模型 | 参数 | 许可 | 链接 |
| --- | --- | --- | --- | --- |
| 中文、粤语、多语种,求准 | Hojo-ASR-Multi-V1 | 5.19B | Apache-2.0 | [https://huggingface.co/HojoAI/Hojo-ASR-Multi-V1](https://huggingface.co/HojoAI/Hojo-ASR-Multi-V1) |
| 只有英语,要快 | parakeet-tdt-0.6b-v2 | 0.6B | CC-BY-4.0 | [https://huggingface.co/nvidia/parakeet-tdt-0.6b-v2](https://huggingface.co/nvidia/parakeet-tdt-0.6b-v2) |
| 显存小,99 种语言 | whisper-large-v3-turbo | 809M | MIT | [https://huggingface.co/openai/whisper-large-v3-turbo](https://huggingface.co/openai/whisper-large-v3-turbo) |
| 显存小,只有英语 | distil-large-v3.5 | 756M | MIT | [https://huggingface.co/distil-whisper/distil-large-v3.5](https://huggingface.co/distil-whisper/distil-large-v3.5) |
| 中文轻量,CPU 可跑 | SenseVoiceSmall | 约 234M | 代码 MIT,权重是 FunASR 自有协议,不是 Apache | [https://huggingface.co/FunAudioLLM/SenseVoiceSmall](https://huggingface.co/FunAudioLLM/SenseVoiceSmall) |
三、再听它说
换成 TTS,Hojo-TTS-Light-40M 是一个 40M 参数的小模型,整包 236 MB,ONNX 格式,在 CPU 上跑。下面四段全部在 M2 Pro 的 CPU 上合成,音色是 hojo_zh_f_01,RTF 约 0.23(合成速度是播放速度的四倍多)。
中英夹杂
「这个 ASR 系统的 WER 是百分之三点五,用的是 beam search,beam size 等于四」,英文缩写和术语混在中文里,beam search读成了beam size。
专业术语
https://x.com/wquguru/status/2093634146082152683「我们把 KV cache 量化到 int8 之后,显存占用大概降了百分之四十」,还不错。
数字和日期
「二〇二五年十一月十八号下午三点半,账上还剩一万两千三百五十六块七毛」,很复杂的数字和日期,只有一处小问题。
纯中文口语
「这个事情我明天再跟你讲,今天实在是忙不过来了」
四、如何看 ASR 和 TTS 模型体量
同一个团队,两个模型,体量差了一百多倍。
ASR 这头,5.19B 参数,12 GB 权重。在 M2 Pro 上转 10 秒音频要 11 秒,峰值内存约 12 GB。
而 TTS 那头,40M 参数,只有 236 MB 的包,CPU 上生成速度超快。
https://huggingface.co/HojoAI/Hojo-ASR-Multi-V1236 MB 的包,加载进内存之后是 750 MB 到 1.2 GB;而 BF16 权重在 CPU 上会被提升成 FP32,体积翻倍不止。因此,选端侧模型时,磁盘上的文件大小只是参考值,真正还需要看两个数:峰值内存,和 RTF。
五、想自己部署?HuggingFace 上怎么选
先答三个问题:
- 第一,音频是什么语言?中文为主或多语种混着来,选 Hojo-ASR-Multi-V1,只有英语,纯声学小模型又快又够用
- 第二,机器是什么?GPU 显存 16 GB 以上,或 32 GB 内存的 Mac,Hojo-ASR 跑得起来;普通 PC,退到 Whisper 一族或 SenseVoice;手机和开发板,只剩几百 MB 的选项,TTS 里真能实时的只有 Piper 一类
- 第三,离线批量还是实时?批量转写可以慢,Hojo-ASR 在小机器上也无妨。要实时,用性能更强的机器,或者选 parakeet/turbo
ASR
TTS
最后,如果对本地部署大语言模型感兴趣,不妨看看这个姊妹篇:
https://huggingface.co/HojoAI/Hojo-ASR-Multi-V1