
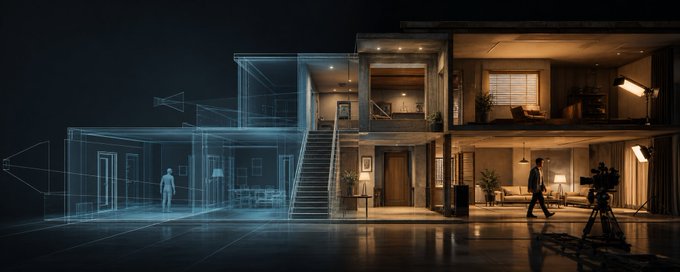
GPT‑6 Astra + Seedance 2.5:先把世界搭出来,再让 AI 拍电影
最近在研究 GPT‑6 Astra + Seedance 2.5 的组合时,我发现一个很有意思的变化:AI 视频的核心单位,可能正在从 Prompt 变成 World。
以前做 AI 视频,我们习惯从提示词开始:写故事、拆分镜、生图,再图生视频。
做单个镜头,这套流程已经很好用。但一旦进入连续剧情,问题很快出现:人物走着走着,门换位置了;镜头一切,楼梯跑到了另一边;上一镜角色从走廊左侧进入,下一镜却从右侧出来。
每个镜头单独看都很漂亮,连起来却不像发生在同一个地方。
问题可能不完全在视频模型。更根本的原因是:从一开始,我们就没有给故事建立一个真正存在的世界。
我的新思路是:先把故事发生的空间搭出来,再让 AI 在里面拍。

这篇文章讨论的是一条工作流判断,不是“已经稳定量产 100 个镜头”的实测结论。但 GPT‑6 Astra 与 Seedance 2.5 最近公开的能力,已经让这条路线从概念变成了值得认真尝试的生产方法。
真正破坏连续性的,往往不是画质
想象一个最简单的剧情:
角色从卧室起床,推门进入走廊,下楼,经过客厅,最后从玄关走到庭院。
如果逐镜生成,AI 必须在每一次生成中重新猜测:
卧室门通向哪里?
楼梯在走廊哪一侧?
客厅和玄关是什么位置关系?
人物接下来应该朝哪个方向走?
换机位以后,角色的朝向应该如何延续?
这些在传统影视制作里属于最基础的空间连续性。过去我们试图用 Prompt 把它们描述清楚,本质上是在拿语言约束三维空间。
语言当然可以描述空间,但它不是稳定的空间坐标系。
所以,与其要求模型每一镜都“猜对”,不如先减少它需要猜的东西。

3D 不是最终画面,而是空间真值层
这里的 3D 很容易被误解。
我们不是要用 Blender 把整部片子精细建模、贴材质,再完整渲染。前期场景甚至可以非常粗糙:白模、简单体块、基础人物代理都够用。
它更像一张 Spatial Blueprint——空间蓝图。
墙在哪里。
门通向哪里。
道路怎样连接。
人物从哪里走到哪里。
相机可以放在哪里。
镜头之间是什么关系。
这些信息先被锁定,3D 就成了整个工作流里的“空间真值层”。
这一点并不只是我的推演。Seedance 2.5 官方已经把 Clay Render,也就是白模参考,列为核心能力之一:模型可以参考空间结构、人物姿态、运动路径、机位和镜头尺度,再用正式的角色、材质、灯光与风格去完成画面。
换句话说,白模不负责好看,它负责不让世界在切镜时突然重置。
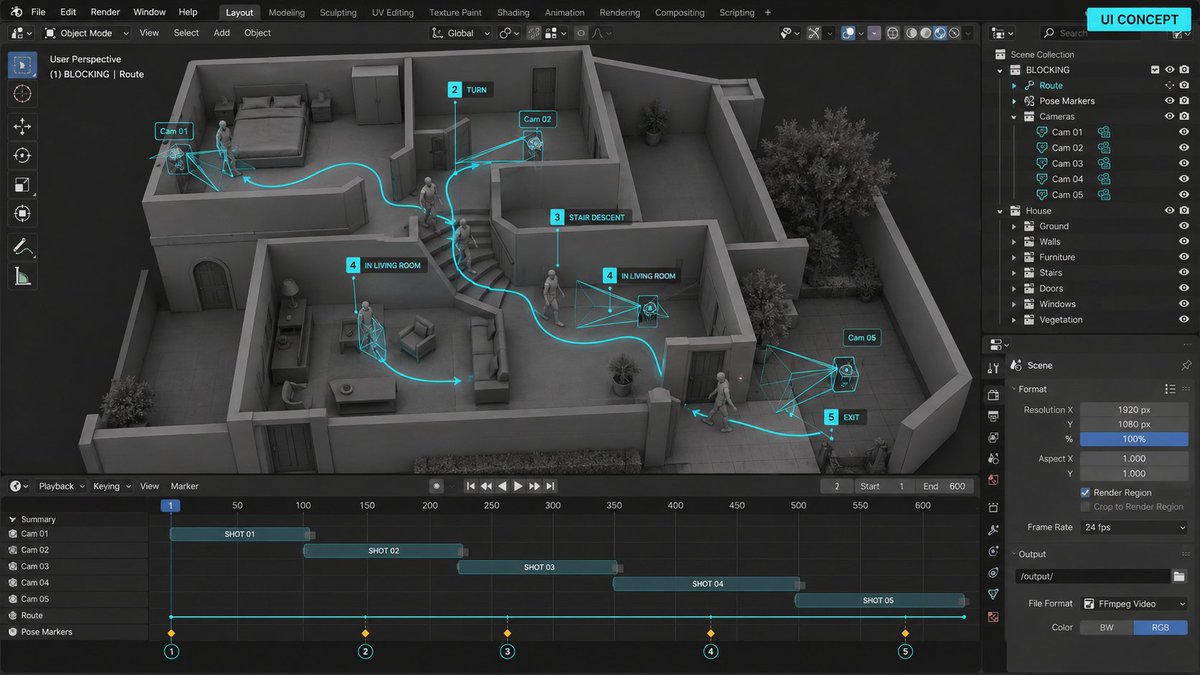
如果用 Blender 做一个最小可行版本,我会把场景拆成 3 个 Collection:WORLD 放墙体、门窗与楼梯;BLOCKING 放人物代理和运动路径;CAMERAS 放全部机位。
先用 Shift+A → Mesh → Cube 搭体块,在 N 面板用真实尺寸约束长、宽、高。卧室、走廊、楼梯、客厅和庭院分别命名,不做材质,不追求细节,只确认门能通、路能走、机位能放。
下面出现的软件界面图均为操作示意,不是官方界面的逐像素截图;菜单会随版本变化,重点是场景、路线、机位和素材的组织方式。

先走一遍,再开始生成
场景搭好后,我不会立刻去生视频。
我会先把一个简单人物模型放进去,让它按剧情路线完整走一遍:卧室 → 走廊 → 楼梯 → 客厅 → 庭院。
同时把所有相机摆出来:
Camera A:卧室全景。
Camera B:走廊跟拍。
Camera C:楼梯俯拍。
Camera D:客厅侧面。
Camera E:庭院反打。
这一步很像传统制作里的 Previs。价值不在画面精度,而在提前暴露问题。
你会立刻看到:人物运动方向是否突然反了;两个镜头能否自然衔接;某个机位会不会穿墙;角色走到下一区域究竟需要几秒;原来的剧情设计是否违反空间逻辑。
这些问题在文字分镜里很隐蔽,在 3D 场景里却一眼可见。
而且此时修改的成本很低。移动一扇门,调整一段路线,或者挪一下 Camera,远比生成十几段视频后再返工便宜。
具体操作时,可以用 Shift+A → Curve → Bezier 画一条路线,或者只在关键转折点给人物代理打位移关键帧。再用 Shift+A → Camera 建立机位;进入 Camera View 检查画面边缘、遮挡与穿墙;在时间线上用 Marker 标出每个镜头的起止点。
我还会把所有 Camera 的焦段先统一到一个小范围,例如 24mm、35mm、50mm,再根据叙事目的调整。这样不会因为每个镜头都随机换镜头语言,造成空间被再次拉扯。

Astra 负责把“空间”翻译成“镜头”
3D 解决的是“东西在哪里”,但不负责“最后长什么样”。
接下来,从已经确定的关键机位导出截图。截图不需要漂亮,它只提供构图、透视、人物位置、运动方向和镜头关系。
导出时保持同一画幅和分辨率,例如统一为 16:9、1920×1080。文件名不要只写 001、002,而是写成 SH010_BEDROOM_WIDE、SH020_CORRIDOR_TRACK、SH030_STAIRS_TOP。这样进入故事板和视频生成阶段后,镜头关系仍然可追溯。

再把这些截图与正式资产一起交给 GPT‑6 Astra:
场景设定。
角色设定。
服装和道具。
材质与灯光。
时代背景。
整体美术风格。
目标不是让模型重新设计镜头,而是告诉它:就在这个已经确定的空间和机位上,把白模变成我要的世界。
于是,原本很不稳定的“文生故事板”,就变成了“空间约束下的故事板生成”。
两者的差别非常大。
前者每一张图都在重新想象世界;后者是在同一个世界里不断换机位拍摄。Astra 在这里也不只是一个“写 Prompt 的模型”。OpenAI 官方展示过它从多视图重建 3D 对象,以及在 Blender 中搭建房屋并转成 Unreal Engine 可行走场景的案例。它更适合承担的是:理解故事、组织资产、生成或修改空间、检查约束,并把场景转译成可拍摄的镜头方案。我会按镜头提交素材,而不是把整个素材库一次性塞进去。每个镜头包只保留 6 类内容:白模机位、人物设定、服装道具、材质灯光、当前动作、前后镜关系。然后明确写出哪些不能改:机位高度不能改、门和楼梯不能移动、人物朝向不能反、构图比例不能重做。

Seedance 2.5 负责让世界动起来
到了最后,Seedance 2.5 拿到的就不应该只是“一张图 + 一段 Prompt”。
它拿到的应该是一套有组织的镜头上下文:
完整故事板。
当前镜头关键帧。
必要的白模或空间参考。
人物与道具参考。
动作和运镜描述。
前后镜头的衔接关系。

Seedance 2.5 官方目前支持单次最多 30 张图片、10 段视频和 10 段音频作为参考,也强调 30 秒叙事、多轮延长、时间戳级编辑以及机位参考。
这意味着,我们终于可以把更多确定性放在生成之前,而不是把所有希望都压在最后一句 Prompt 上。
模型需要猜的东西越少,真正可以用于运动、表演、摄影和氛围生成的能力就越多。
实际提交给 Seedance 时,我会把素材按优先级排列:先放当前故事板和关键帧,再放白模空间图,然后是人物、道具、动作参考,最后补上一镜的结束帧。提示词也只写 4 件事:人物做什么、镜头怎么动、这一段持续多久、哪些连续性不能改变。

一条更完整的制作链
整套流程可以浓缩成:
故事确定
↓
分镜初稿:确定动作、区域与行进顺序
↓
搭建本集涉及的统一三维空间
↓
摆人物、道具和相机,检查整条路线
↓
从关键机位导出同一视角体系的截图
↓
截图 + 正式场景与角色资产,生成完整故事板
↓
故事板 + 当前镜头关键帧 + 必要空间参考
↓
Seedance 2.5 生成与编辑视频
这里最关键的不是最后一步,而是中间那层 3D 空间。
它把故事、镜头和视频模型连接成同一个坐标系。
生成完成后还要做一次连续性验收:空间是否一致、人物运动方向是否一致、比例是否漂移、镜头轴线是否跳变、动作时间是否合理、角色身份是否稳定。任何一项失败,都只回到对应约束重做,不要把整条提示词全部推翻。
这套方法的边界
它不会自动消除所有问题。
白模正确,不代表人物身份一定稳定;空间连贯,也不代表复杂肢体动作一定符合物理规律;参考越多,也不等于模型就一定能正确理解每一种约束。
Seedance 官方自己也承认,复杂运动的物理合理性,以及多主体交互场景的稳定性,仍有提升空间。
而且,搭 3D 场景会增加前期成本。对于一次性、无连续剧情的氛围短片,这套方法可能得不偿失。
它更适合连续剧、动画、短剧、品牌故事、游戏 CG、建筑漫游,以及任何需要反复回到同一地点拍摄的内容。
从 Prompt 到 World
过去,AI 视频的核心单位是 Prompt。
后来变成参考图、首尾帧、多镜头和角色资产。
继续往下走,我认为核心单位会变成 World。
先有一个世界。世界里有建筑、道路、房间、人物、道具和明确的空间关系。
然后才有 Scene、Shot、Camera、Character 和 Action。
最终才是 Video。
今天 Camera A 拍这里,明天 Camera B 拍那里。角色从房间走到街道,下一集继续沿着同一条街往前走。镜头在变化,但世界本身没有重置。
这可能才是 GPT‑6 Astra + Seedance 2.5 最值得玩的地方。
不是让模型一次生成得更漂亮,而是让第 1 个、第 10 个、第 100 个镜头,都像发生在同一个真实存在的世界里。
以前,我们在不停地生成镜头。
现在,我们开始有机会:搭建世界,设计镜头,然后拍摄这个世界。
如果这条路线能跑通,AI 视频真正改变的就不只是生成,而是整个前期制作流程。
参考资料
OpenAI:GPT‑6 Astra: A new generation of intelligence
https://openai.com/index/gpt-6-astra/
ByteDance Seed:Introducing Seedance 2.5
https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5