
一个把发布权留给人的自动发推 Skill
我要分享的,是一个能把"原始素材 → X 推文"做到全自动的 Skill:素材丢进去,润色、翻译、选模型、配图、排期都交给它。但有个地方我刻意留了个人工步骤:最终那一下发布,必须先过我自己一眼。
它叫 tweet-buffer-workflow。不教你写 prompt,也不推销某个模型,而是把一个真实的项目经验沉淀下来:模型负责把素材写得像人话,人负责守住发布前最后那道闸门。
为什么会有这个 Skill
我原来要发一条 X 推文,流程是这样的:读素材 → 在脑子里改写 → 掐字数 → 纠结措辞 → 手动复制到 Buffer → 再确认账号和队列。素材经常已经在 Telegram、Markdown 或文本文件里,但"原始内容"到"可以发布的推文"之间,仍然压着一串重复劳动。
这套流程固定、判断量小,天然适合交给 agent。但直接让 AI 替我发推又太冒险:它不理解我的人设和安全边界,一旦写坏就是不可逆的对外动作。
所以我做的是一个折中:把流程拆成可检查的环节,模型负责处理文字,人保留最后的发布决定。
输入素材 → 选择模型 → 润色或翻译 → 预览审核 → 选择 Buffer 动作
怎么安装
解压交接包后,把 tweet-buffer-workflow 目录放进 Codex 的 Skills 目录:
mkdir -p ~/.codex/skills cp -R tweet-buffer-workflow ~/.codex/skills/
如果使用者设置了自定义 Skills 根目录,就把目标目录替换为该目录。重新打开 Codex 后,就可以显式调用 $tweet-buffer-workflow。如果当前环境支持自动 Skill 发现,也可以直接描述"把这段内容改成 X 推文并准备 Buffer Draft"。
怎么连接 Telegram 和 Buffer
这里要先把两件事分清,因为它们容易混淆:
- Skill 本身(tweet-buffer-workflow)只是一组规则和工作流,不携带任何 Token,也不保存任何账号。它跑在 Codex agent 里,负责读懂素材、生成审核稿、再根据你的动作决定调用哪个连接器。
- 底层的可运行服务(如果要用 Telegram Bot 接收素材、以及真实写入 Buffer)才需要真正的连接配置,Token、密钥和频道 ID。这些全部放在你自己的受保护配置文件里,绝不写进 Skill、不提交 Git。
连接 Telegram
Telegram Bot 是素材入口,也是发布前的最后一道控制面板。要接入,你需要:
- 拿 Bot Token:在 Telegram 里找到 @BotFather,发送 /newbot,给它起一个名字和 username。BotFather 会返回一串 TELEGRAM_BOT_TOKEN,形如 123456789:AAH...,形如 token 直接复制保存。格式是 bot_token 两个部分,冒号前后都要完整。
- 拿 Owner 数字 ID:Bot 只允许你一个人操作。进入你刚才创建的那个 Bot 的对话(或用 @userinfobot),把你自己的数字 ID 记录下来作为 TELEGRAM_OWNER_ID。程序在 reviewer.py 里用 user.id == owner_id 做白名单校验,只有你的账号能触发发布按钮,别人的消息会被忽略。
- 把它们放进配置:在你的私有 .env 里写入:TELEGRAM_BOT_TOKEN=<BotFather 给的那串> TELEGRAM_OWNER_ID=<你的数字 ID> 然后执行 chmod 600 .env。程序加载配置时会强制校验权限,若 .env 不是 600(仅本人可读写)会直接报错,不会带着宽权限启动。
连接 Buffer
Buffer 是 Buffer 官方认可的标准 API(不是抓包或逆向),走 OAuth 授权 + GraphQL。负责发布,不负责理解素材。要真实写入你的 X 账号,需要三步:
- 建应用、拿 API Key:在 Buffer 开发者后台创建一个应用,拿到 BUFFER_API_KEY。这个 Key 代表你的 Buffer 账号身份,程序用 Authorization: Bearer <key> 请求 https://api.buffer.com/ 的 GraphQL 接口。
- 把 X 账号绑定成 channel(关键一步,最容易被忽略):光有 API Key 还不够。你要在那个 Buffer 应用里,把你的 X 账号作为 channel 连接/授权进来:这一步是 Buffer 官方 OAuth 授权,允许 Buffer 以你的 X 身份去发推。只有绑定完成后,那个 X 账号才会出现在 Buffer 的 channel 列表里,GraphQL 的 createPost(channelId: ...) 才是真发到你这个 X 账号。这一步跳过,后面拿到的 Channel ID 一定是错的,或根本不存在。
- 拿目标 Channel ID:绑定成功后,在 Buffer 里找到你要发布的那个 X 频道,把它对应的 ID 记为 BUFFER_CHANNEL_ID。这一步也最容易错,ID 必须对应你要发推的那个 X 账号,不是随便抓一个。首次配置建议用 publisher.py --check-channel 跑一次连通性校验,它会返回频道的名称、显示名、平台(service,应为 X/Twitter)和是否暂停,确认配对正确后再继续。
- 把它们放进同一份 .env:BUFFER_API_KEY=<Buffer 应用的 Key> BUFFER_CHANNEL_ID=<目标 X 频道的 ID>
验证连接
把四项都填好后,可以用项目自带的两个命令各验证一次:
- Telegram:启动服务,用你自己(owner)的那个账号给 Bot 发一条消息。如果收到审核卡回复,说明 Bot Token 和 Owner ID 配对成功。
- Buffer:python publisher.py --check-channel,如果返回频道信息(不是报错),说明 API Key 和 Channel ID 配对成功。
如果暂时没有 Buffer 连接,Skill 依然可以完成改写和预览,它只返回可复制的最终文本和发布参数,不会假装已经发出。
模型怎么选
现在可选五个模型:Grok 4.6、Codex 5.6 Luna、DeepSeek V4 Flash、Gemini 3.8 Flash 和 Gemini 3.7 Flash。
我保留多个模型,是因为它们在同一份素材上的表达会不同。我的实际使用判断是,Gemini 的中文语感和 X 网感更贴近我想要的方向,所以经常优先使用 Gemini。3.7 是手动备用选项:如果 3.8 遇到服务端容量问题,就重新选择 3.7,不让系统偷偷替换模型。
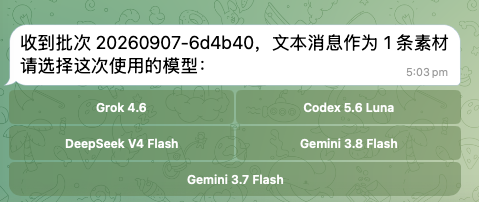
同一批素材进来后,第一步是先让你选「这次用哪个模型」五个按钮即上面提到的那五个。模型的选择权始终在你手里,不在系统手里。
两种处理方式
第一种是润色。它保留原文的核心观点和事实,只把表达改得更适合 X:首行更快进入主题,长段落变成手机端容易阅读的短段落,控制在 250 个字符以内,不强行添加互动 CTA,也不以问号收尾。
第二种是翻译。它会先判断语言:英文转自然的简体中文,繁体中文转简体中文,已经是简体中文时只做必要润色。重点不是逐字翻译,而是保留原文语境、语气、数字、专有名词和事实边界。
无论选哪个模型,输出都先停在审核稿,不会直接发出去。
审核后怎么进入 Buffer
审核稿确认后,你只需要选一个动作:
- Draft:存入 Buffer 草稿,不发布;
- 进入队列:放入下一个可用排期;
- 队列置顶:放到即将发布的第一条;
- 现在发送:立即发布到 X;
- 重出:不写入 Buffer,重新生成一个版本。
如果 Buffer 的普通队列已经达到容量上限,进入队列 会自动改存 Draft,并告诉你队列已满。队列置顶 不会被静默改成 Draft。这样容量问题不会导致内容丢失,也不会改变原本的发布意图。
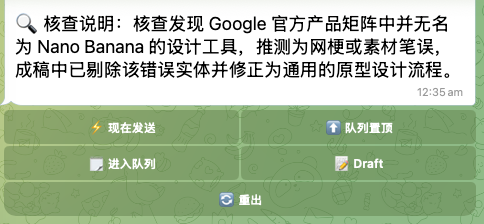
这段审核卡很能说明这套流程在做什么:上半部分是模型回传的核查说明,它发现素材里的「Nano Banana」并不存在于 Google 官方产品矩阵,判定是网梗或笔误,于是主动在成稿里剔除了这个虚构实体、改成通用的原型设计流程。事实边界在模型这一步就被守住了;下半部分才是五个发布按钮:现在发送 / 队列置顶 / 进入队列 / Draft / 重出,最终由你决定走哪一步。
图片怎么处理
图片和文字可以在同一次调用里处理。文字 Caption 走正常的润色或翻译流程,图片则单独做 OCR、转换和风格处理:
文案和图片分别通过审核后,才允许作为图文内容交给 Buffer。
需要准备什么
连接 Telegram 和 Buffer 用到的 Token、API Key 和 Channel ID,都放在你自己的受保护配置中,不粘贴进 Skill、不提交到 Git。这一步的具体操作见上面的「怎么连接 Telegram 和 Buffer」。
此外,模型侧按需配置:优先用 Grok 或 Codex(走本机订阅登录,无需额外 Key);如果选了 DeepSeek、Gemini 或图片流程,才需要填对应的 DeepSeek、Gemini、OpenAI 和 Cloudinary 凭证。图片要用 Cloudinary 提供公开 HTTPS 图址交给 Buffer。
这个 Skill 的价值
它把复杂性藏在一个稳定的使用入口后面:你不需要记住每个模型的 API 格式,也不需要手动拼 Buffer 请求。模型可以替换,版本可以升级,但流程始终保持一致:
输入素材 → 选择模型 → 润色或翻译 → 预览审核 → 选择 Buffer 动作
自动化能替你做很多事,唯独有一件它做不了:替你承担发布的责任。所以这个 Skill 把"自动"推到极致:润色、翻译、选模型、配图、排期全自动,唯独把"最后那一下拍板"留给了人。
我保留的核心原则只有三个:
- 原意和事实不能被改坏;
- 外部发布必须有明确动作;
- 任何不确定的发布结果都先停下来核对。
账号信誉是你的,发出去的不是 AI 的账,是你的账。所以这个 Skill 的真正价值,是把重复劳动全自动、把决策权留给人类:AI 负责写,你负责说"发"。
关于作者 Kimberly | @king1818888
AI-Native Builder,每天用 AI 建系统、做内容,也是 X 创作者。