
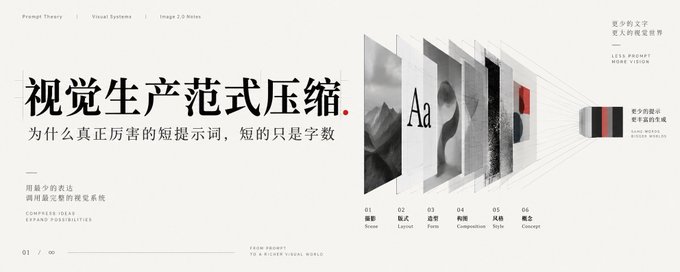
视觉生产范式压缩:看懂这篇,你才算开始会用 Image 2
Image 2.0 刚发布的时候,我做了很长一段时间的测试。
那时候,我逐渐发现一个很有意思的现象:有些提示词明明非常短,生成出来的画面却异常完整。
它不只是“画得好看”。
构图、人物造型、摄影、版式、材质、文字关系、视觉重心,甚至整张图的气质,都像已经被提前设计过一样。
后来,我围绕这个现象写过两篇文章,大部分内容也都发在 X 上。最近又看到越来越多人使用类似的方法,效果确实很好,所以想把这套思路重新整理一次。
我现在把它叫作:视觉生产范式压缩理论。
这是我根据一段时间的生成测试,整理出的一套提示词方法框架,用来解释和复用这种现象。
一、真正有效的短提示词,短的只是字数
我们很容易用“长度”判断一个提示词的信息量:几十字,好像信息比较少;几百字,好像信息更完整。
但实际测试以后,我越来越觉得:提示词的信息量,和字数并不是一回事。
有些提示词写得很长,大量内容却都在重复同一个维度。
比如:高级、精致、震撼、唯美、顶级、奢华、具有艺术感、极具设计感……
看起来写了很多,但大部分只是在反复告诉模型:“我要它好看。”
人物怎么拍?构图怎么组织?画面是什么媒介?最终是一张杂志封面、广告、设定稿,还是艺术海报?
这些问题依然没有被回答。所以这种提示词虽然长,信息结构却很薄。
相反,有些词只有几个字,却可以同时影响很多视觉决策。这就是我说的:高密度视觉概念。
二、什么叫“高密度视觉概念”
在这套方法里,一个有价值的概念,能够自然带出一整套视觉惯例。
比如,编辑式人像。
它不只是说“拍个人”,还往往会影响人物姿态、镜头距离、服装造型、表情控制、构图裁切、光线方式,以及人物与背景的关系。
再比如,极简时尚封面。
它也不只是“背景简单一点”,还会影响留白、信息密度、标题层级、人物与文字的关系、视觉重心、版式节奏和颜色数量。
而独立艺术企划主视觉,则把方向推向一套完整的视觉身份。画面可能因此出现符号、编号、辅助图形、角色专属色块、抽象元素或非对称结构。
这些概念的共同特点是:字数很短,但后面连着大量下位视觉决策。
“高级”“好看”“有氛围”,更多是在评价画面。建筑摄影、动画视觉开发、独立出版海报、角色设定板、博物馆视觉识别、史诗概念艺术,则更具体地指向了作品类型、制作方式或视觉惯例。
它们在告诉模型:你现在正在生产哪一种视觉作品。
当然,概念听起来专业,不代表它一定有效。“独立艺术企划主视觉”这样的表述,也比“建筑摄影”“角色设定板”更依赖上下文。
关键是:模型能否识别它对应的视觉惯例,它与其他概念是否相容,以及生成结果是否符合你的目标。这些最终都需要通过测试判断。
三、好的组合,让概念各有侧重
好的短提示词,往往不是所有词都在描述“风格”,而是让不同概念分别回答不同问题:
- 画谁?
- 怎么拍,或者怎么画?
- 怎么组织和设计?
- 最终是什么类型的视觉作品?
- 它服务于什么用途?
可以把它理解成一份非常短的创意简报。
比如这一组:
极简时尚封面 × 编辑式人像 × 独立艺术企划主视觉 × 角色
“角色”给出主体身份;“编辑式人像”侧重摄影与造型;“极简时尚封面”侧重版式与信息层级;“独立艺术企划主视觉”侧重概念与视觉识别。
它们可以有重叠,但最好各有侧重,并且指向相容的视觉方向。
这样,模型面对的就更像一套方向一致的生产结构,而不是一堆争抢控制权的形容词。
类似的组合还可以是:
- 建筑摄影 × 粗野主义展览海报 × 博物馆视觉识别 × 建筑
- 电影感人像 × 奢侈香水广告 × 忧郁概念主视觉 × 角色
- 角色设定板 × 动画视觉开发 × 数字水粉 × 角色
- 旅行手账速写 × 角色视觉开发 × 淡彩水洗 × 地点 / 角色
- 复古丝网印刷 × 独立出版海报 × 几何人物设计 × 角色
- 超尺度奇观 × 电影级写实 CG × 史诗概念艺术 × 巨物主体
这些只是组合思路,实际使用时,要把“角色”“建筑”“地点”替换成具体主体。
重点从来不是背住哪组词,也不是寻找“万能神词”,而是判断:每个概念带来了什么信息,它们放在一起是否成立。
四、为什么短提示词容易出现完整设计
我认为,一个重要原因是:它控制高层结构,同时为低层执行保留空间。
你已经告诉模型:这是一个什么类型的作品,主体是谁,应该进入什么样的视觉世界,以及它具有什么用途和气质。
但你没有强制规定:人物必须站左边还是右边,手一定放在哪里,标题一定多大,背景一定是什么颜色,辅助图形必须放哪个角落,灯一定从多少度打进来。
也就是说,宏观方向被限定了,微观执行仍然保留自由。
如果提示词什么都不规定,生成空间太大,结果容易普通。如果在探索阶段就把所有细节规定得过满,模型组织整体画面的空间可能反而变小,结果也更容易被局部要求牵制。
对寻找视觉方向这件事来说,我更倾向于:高层明确,低层自由。
五、压缩的,是一整套视觉生产决策
所以,我现在越来越少研究“怎么把提示词写长”,更关注怎样用更少的词,建立更清晰的视觉结构。
这里的“少”,不是删信息,而是压缩信息。
如果一个成熟的视觉概念已经携带了摄影、造型、构图、材质、版式或文化语境,就不必总把这些惯例拆成几十条要求,重新手写一遍。
这也是为什么有时候,一个高密度视觉概念加上一个角色,就能得到非常完整的结果:那个概念本身已经足够“厚”。
我把这种方法叫作“视觉生产范式压缩”,是因为它把一整套视觉生产决策,压缩进了少量概念里。
你没有逐条告诉模型,摄影师该怎么拍、造型师该怎么搭、平面设计师该怎么排、艺术总监该怎么建立概念,却用几个高密度概念,同时确定了这些工作的大方向。
最终看起来,就像摄影、造型、设计和艺术指导同时开始工作。
当然,这只是对输出规律的一种功能性解释。我并不是说模型内部真的存在几个“岗位”。真正重要的是:这些概念可以同时对多个视觉维度产生约束。
六、这不等于“提示词越短越好”
详细提示词当然有价值。
当你需要精准控制服装、动作、机位、镜头、材质、连续性或版式细节时,就需要把具体要求写清楚。
视觉生产范式压缩讨论的是:当目标是创造、探索、寻找视觉方向时,优先决定高层生产范式,不要过早锁死所有细节。
先决定它是什么,再逐步决定它具体长什么样。
实际使用时,可以先确定主体和作品类型,再选择能补充关键维度的概念。看完生成结果以后,只补充那些确实需要控制、却没有被概念自然带出的要求。
如果结果已经成立,就不必为了让提示词显得完整,继续往里面加词。
七、从描述画面,到选择视觉世界
我现在越来越觉得,Prompt 的核心能力,已经不只是“描述画面”,还包括选择视觉世界。
一个好的短提示词,会在很早的阶段,把模型引向一个足够清晰、足够成熟、内部又足够统一的视觉系统,让它在这个方向里完成剩下的设计。
所以,我现在越来越少问:
“这个提示词还能加什么?”
反而更常问:
“这个词,到底装了多少东西?”
这就是我目前理解的视觉生产范式压缩理论。
真正厉害的短提示词,短的只是字数。