
Harness 是组合泛化器
作者:Alex L. Zhang(与 Omar Khattab 合著;RLM 架构提出者,MIT CSAIL)
现代 post-training 已经变成蛮力范式:不断收集更多环境、训练更长的周期。这很大程度上是因为前沿 Transformer 仍然不擅长组合泛化——用熟悉的概念组合去解决没见过的问题的能力。除非模型能把学到的单个经验组合起来,否则 scaling 的回报会比应有的慢得多,因为每个新领域都要为它单独投资训练数据。
这几年我们靠脚手架(scaffolding)打更难的题:先 chain-of-thought,再工具调用。但泛化这件事一直留给了底层神经网络的 2017 年 token 级归纳偏置。这篇文章的论点:**更好的泛化在很大程度上是 harness 的工作。**
Harness 是什么
Harness 是坐在外部世界和神经网络之间的那个程序:它决定如何把环境的当前状态(可能任意长、任意复杂)编码成 LLM 的一次或多次输入,以及如何决定下一步动作。
传统上我们理解 Claude Code 或 Codex 这类 harness 的价值是"能在复杂环境里调用外部工具"。但那只是 agent 的一部分。**Harness 更根本的能力,是把任意复杂的状态 s 简化成多个更小的观察 o,让每一次单独的 LM 调用都能正确处理。**
具体地说:**好的 harness,让每次 Transformer 调用看到的观察都是"局部分布内"(locally in-distribution, LID)**——即每一次单独的 LM 调用,其 prompt 都处于它训练数据的分布内。即使整个任务轨迹对任何单次调用都是分布外(OOD)。
用一句话概括:**好 harness 把不熟悉的问题归约为熟悉的,把复杂问题归约为简单的。**
现有 harness 为什么失败
Claude Code、Codex 这类设计,本质上依赖"往 Transformer 的上下文窗口里不断灌入任务特定信息、工具输出和推理"——历史越滚越长。这确实提供了大量上下文,但这些膨胀的历史很快掉出训练分布,就表现为我们常见的"context rot"(上下文腐坏)。
RLM 的两个机制
递归语言模型(RLM)harness 的解法,是让结构相似的任务在根 LM 眼里看起来"逐 token 同构",从而落进同一个等价类:
**一、Context offloading(上下文卸载)**:把输入特定的上下文作为符号变量传递,根 LM 调用不直接看到它——不同问题在第一步就看起来相似。单独用这一条还不够:环境反馈和子 agent 信息仍会回到主上下文,长轨迹下还是 OOD。
**二、Programmatic sub-agent calling(程序化子 agent 调用)**:子 agent 和普通工具都被当作代码 REPL 里的函数——根 LM 可以选择性地传递信息,而不让自己看到它。工具输出和子调用结果可以直接存进内存变量,供后续子调用访问。
正如作者所说:**让相似任务被看作同构,就是让"如果系统能解任务 X,就应当能解任务 Y"成立。**
实验结果(Qwen3-30B-A3B-Instruct-2507,RL 训练)
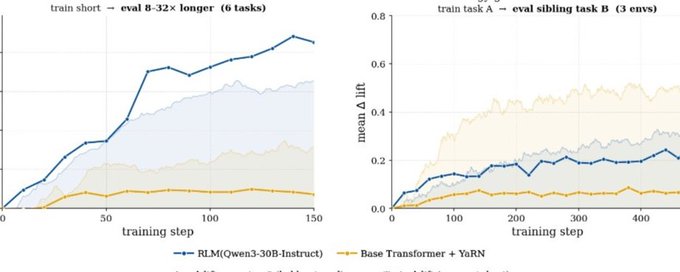
**长度泛化**:只在短任务上训练,泛化到 8-32 倍长的未见任务。六个基准(MRCRv2、GraphWalks、LongBenchPro、OOLONG、OOLONG-Pairs、Ada-LEval)上,RLM 的 eval 提升匹配甚至超过 train 提升;而 base Transformer 的 eval 曲线基本是平的——学到的不会外推到更长设定。
更狠的是:训练后的 30B RLM 在几个基准上逼近甚至超过 GPT-5.5 + RLM harness 的表现。
**策略泛化**:在一个域训练,泛化到完全不同的域——比如在 Jeopardy TREC 聚合题上训练,泛化到 SPAM/HAM 题;在"找同一作者文章"上训练,泛化到"找同一推理过程的数学题"。跨域的 token 分布完全不同,唯一相似的是潜在任务结构——base Transformer 依旧学不动。
**成本**:RLM 训练 runtime 比 base 多 1.5-3 倍(每样本多步 + 等子调用),但这个成本随任务复杂度 scaling 得很好——直接用 Transformer 训更长上下文/更长的 horizon 会贵得多。
一个重要的警告
不要读完就去手工设计 harness 结构(硬编码 MapReduce、动态规划那类)。作者的原话:那样做"会不可避免地撞上 Bitter Lesson,并在几个月内被淘汰"。
他们的论点不同:**数据 scaling 仍然是进步的最大驱动,但你喂数据的机器(及其归纳偏置)决定 scaling 的系数。** 今天看来,Transformer 及其同类架构的组合泛化能力就是不松动的瓶颈——因为全可微神经算子的狭窄设计空间,漏掉了某个根本性的东西。
而语言作为基底,让我们第一次可以编码"高阶、符号化的归纳偏置",并用 RL 端到端训练系统。RLM 通过 context offloading 和程序化子 agent,就是这个方向的一个证明:在跨长度、跨域的泛化上,它可以远胜裸 Transformer。
收尾一句值得记住:**更好的 scaling 回报需要组合泛化;而组合泛化的能力看起来必须主要住在今天我们称之为 harness 的地方**——未来它可能会和 frontier AI 的基础架构彻底融合。
原文:https://alexzhang13.github.io/blog/2026/harness/
#Harness #RLM #组合泛化 #AlexZhang