
新媒体分析器 New Media Analyzer 发布!内容创作与分析竞品利器!
欢迎大家加入“钱来有道”社群,爆文写作、小说、剧本Skill+Agent 分享,自开发实用工具免费使用!推特订阅会员享同等福利,广告结束!
做内容创业的兄弟们,特别是做短视频创作的选手,这个工具就是为你们做的!
错过你将失去一个强大的数据分析工具,免费分享,别拿去卖钱!今天内容有点长,一定要保持耐心看完,你会有巨大收获!
我们研究竞品账号,是不是这样:收藏了一堆爆款选题,真到自己拍的时候,还是不知道拍什么?
比如,同一个博主,两条视频讲的都是干货,点赞却差了一大截。
到底是选题不同,还是开头更抓人?光看表面数据,很难看明白深层原因。
如果你正在做账号,或者帮客户做内容,能不能体现专业度,用数据客观说话,才更显重要。
所以我做了这个新媒体分析器,把作品数据、口播文案整理到一起,再用 AI 辅助拆解:哪些内容表现更好,开头怎么写,有哪些思路值得你借鉴。站在优秀作者的肩膀上,用上帝视角看这些数据为什么优秀的底层逻辑。
好,接下来,我们一步步的介绍这个新媒体分析器的操作说明。
第一步,打开新媒体分析器!
mac 版用户,直接在解压缩包里点击“新媒体分析器内测.app”(首包目标为 Apple Silicon(M 系列)与 macOS 15 或更新系统使用)
Win 版用户,同样方式在解压缩包里点击“新媒体分析器内测.exe” 文件启动服务。
因为现在还处于内测版,可能稍有不稳定,如果大家在使用过程中发现什么问题,欢迎和我反馈。
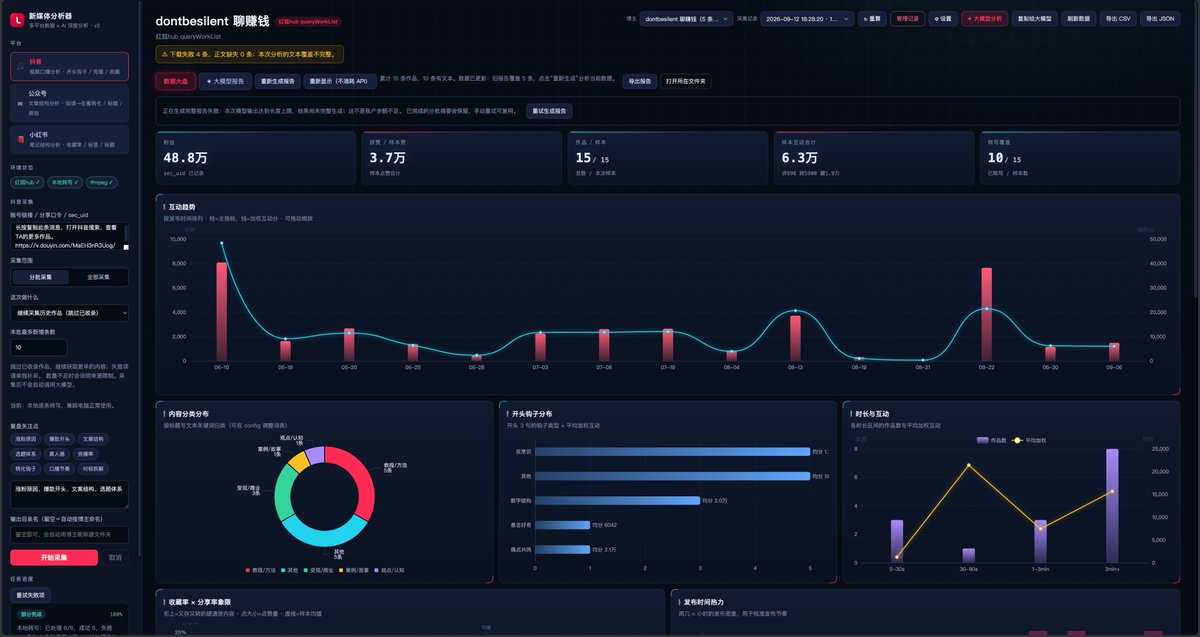
分析器的页面展示如下:

分为三个重要区域:
左侧为平台选择,现在只做了三个,后期上 B站的采集!(抖音、公众号、小红书)
顶部为设置区,主要是管理记录,与配置大模型 API 使用。
中间为数据大盘!是内容采集回来的集中性数据说明与二次分析区域!
第一次使用时,需要先在顶部点击“设置”
进行相关模型的配置。
红狐Hub 的 API 可以让我们不必在采集时有被封的风险,而且它的数据库里有非常多的优质内容库,只要是大博主,基本都可以用红狐的 API 来采集。
别担心,如果它库里没有的,我们也可以通过公开视频链接采到数据,进而对自身账号没有风险。
而红狐 Hub 新注册都送 150 的积分,每次查询是按积分来扣除,如果你经常用的话,我强烈建议你充值一些费用。其实够用很久,下图是我用免费积分进行查询的消耗,还没用完呢。
语音转写方式,我做了两种,一个是本地模型的转写,你下载回去的安装包,已经包含了这个本地模型,不需要再次安装。
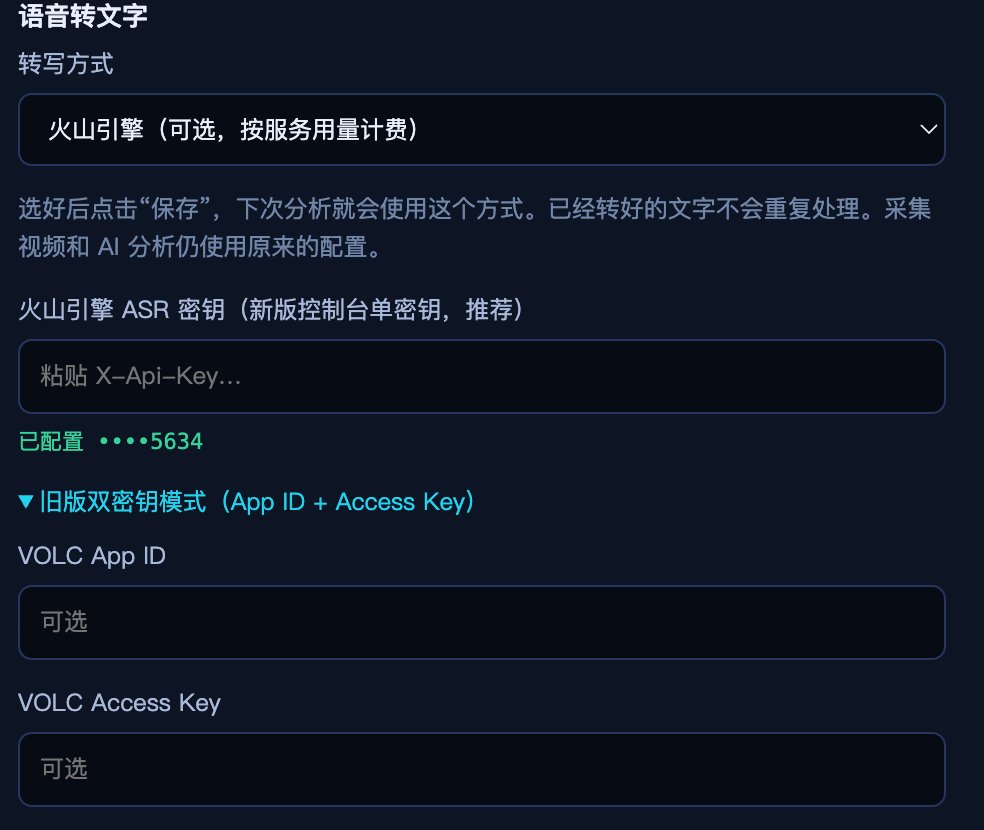
第二种方式是绑定“火山引擎 ASR 密钥” 用云端模型来做本地语音转文字的工作。
我这里使用的是:豆包流式语音识别模型2.0 ,你去火山可以自行申请 ,也用不了几个钱。
不想花钱就用本地转的模型就好!
最下面的就是对内容进行分析的大语言模型的配置了,这里我用的是 Deepseek V4.1 flash 的 API
以前比较贵,但这次的 V4.1 Flash 已经成本可控了。速度快,费用低足够用了!当然你也可以配置其它大模型。
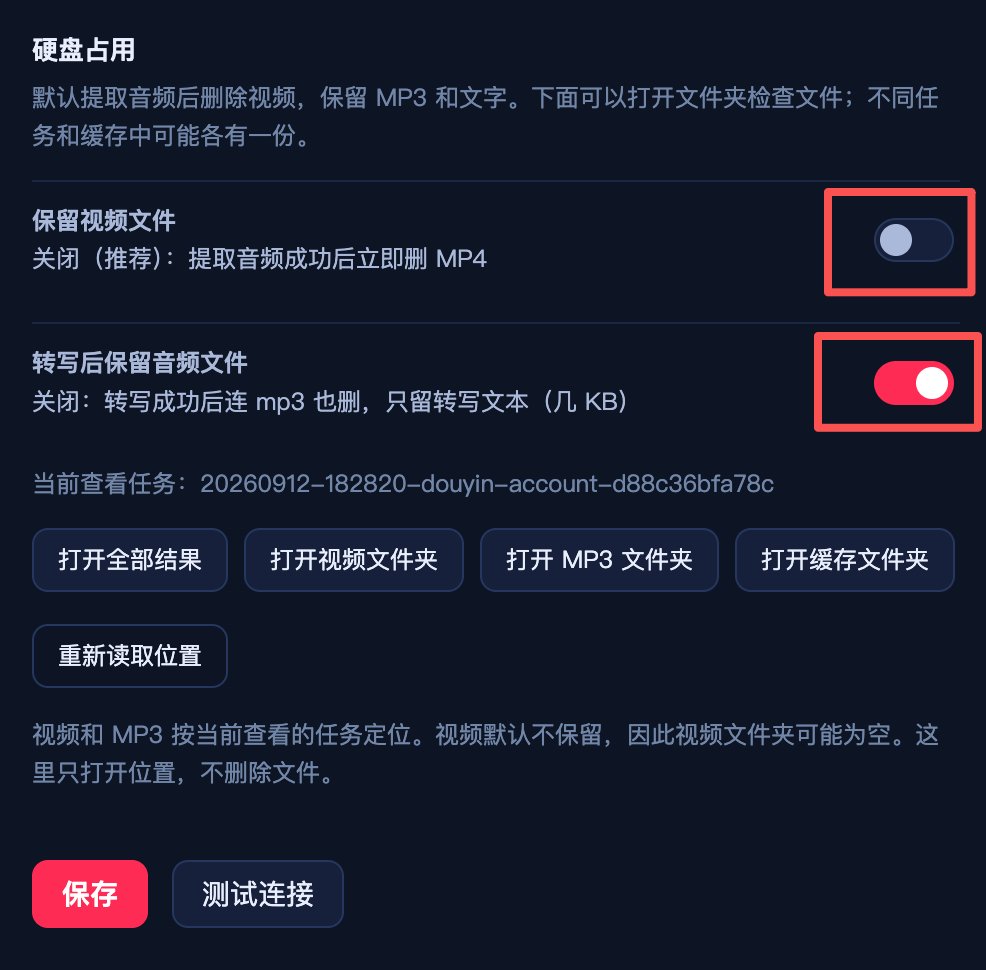
下面硬盘占用的位置:
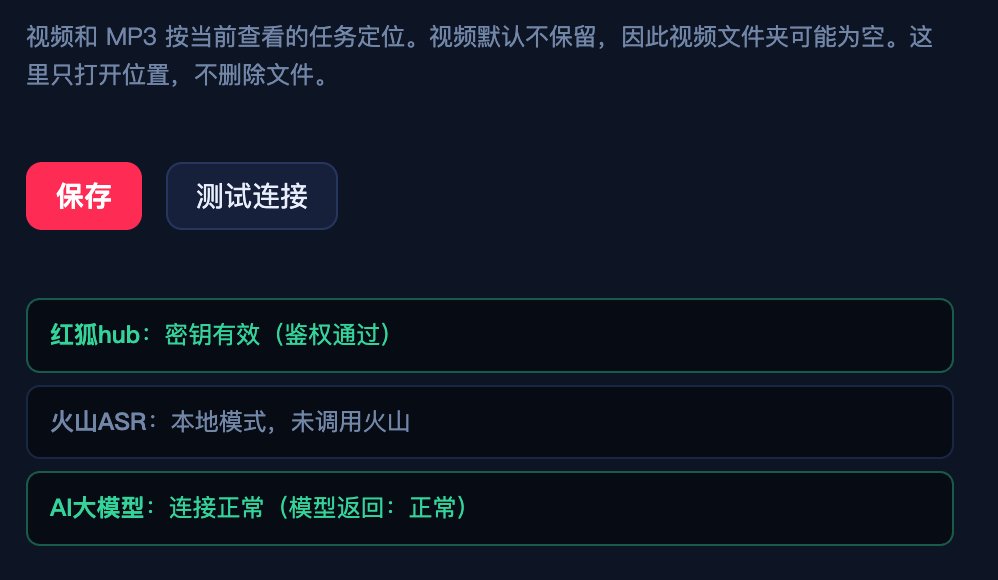
因为每次采集视频的文件比较大,我一般是下载完,识别语意,然后就直接删了视频,所以这里设置了开关。你硬盘容量足够这里可以打开!
转写后保留音频文件这里,我建议还是打开。因为你可能多次进行识别和分析,所以,默认是打开状态。
如果你担心视频没删,或想自己去动手删除,下面有文件所在位置的快捷打开方式,直接点就能打开所在文件夹位置。
最后非常重要的是,一定要点击“保存”,还有测试连接,只有模型都通的时候,才能识别和正常采集,这点要注意!
全部测试通过后,我们就可以开始采集内容了!
在侧边栏,可以先点击“抖音选项”
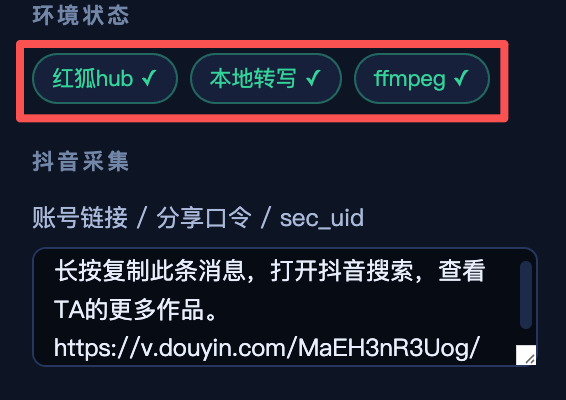
查看环境状态 是否全是勾选状态!
在“账号链接 / 分享口令 / sec_uid” 这个输入框内,输入你要查的竞品博主抖音主页链接。

方法是找到博主的主页,然后点分享,复制链接,然后回来再在上面输入。
这里就拿 Dontbesilent D兄的账号来做个演示,希望 D 兄不要怪我,我也帮着宣传一波,想要学习商业变现方法论,请关注“dontbesilent 聊赚钱” @dontbesilent
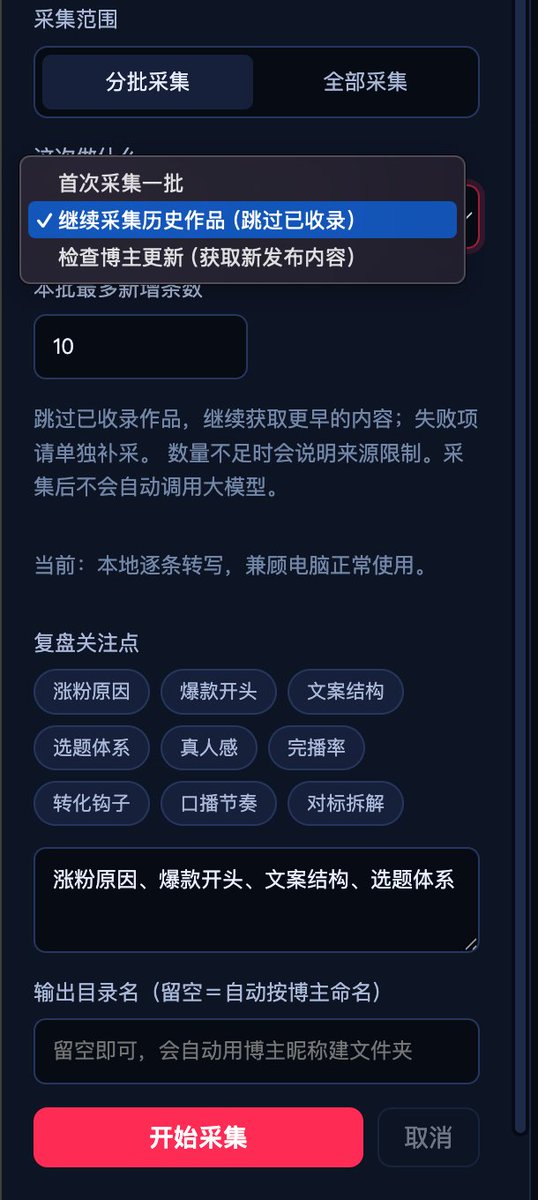
OK,下面就要选择要一次下载多少了。个人建议一次采集的最高数量不要超过 30,并不是不能选择全部采集,而是为了成功率,你可以多次采。
并且我在这里做了设置,下次采集可以续采,也可以检查最新的采集,如下图:
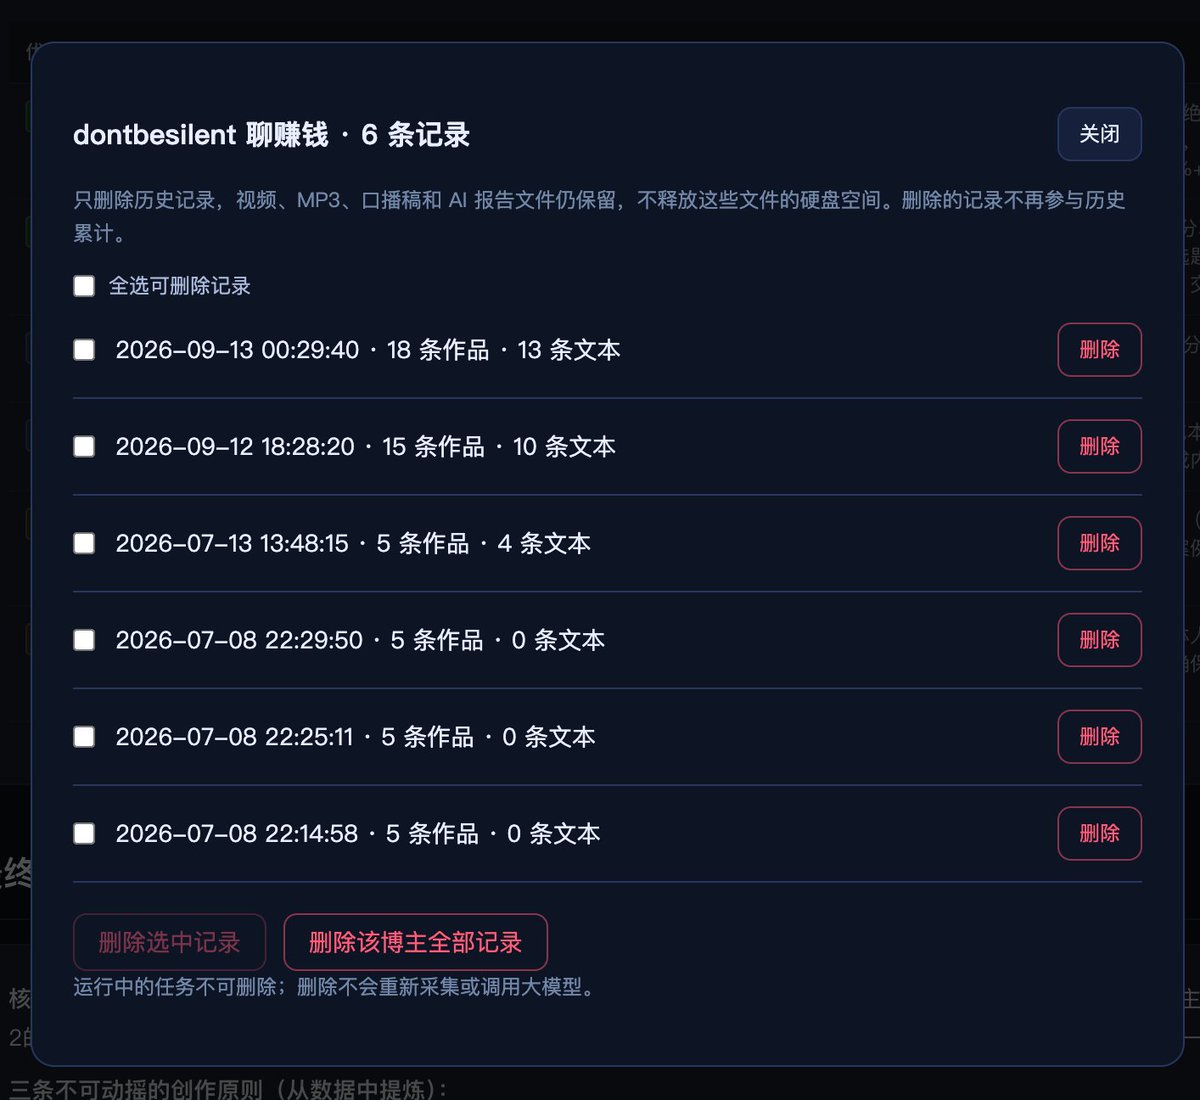
每次采集的内容,都可以单独生成一条记录,而且做了去重处理!
注意:并不是每次都能全部采集,有时候会失败,具体原因比较多,多数是因为网络或红狐的 API 不稳定导致的,没关系,下次重采就行了,它会知道什么采过,什么没采过。
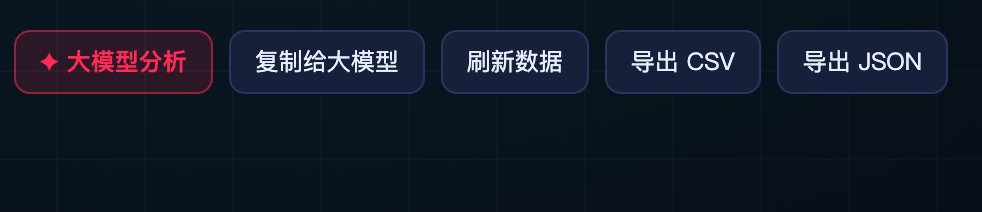
采集回来的内容,在数据大盘里可以看到分析的内容,但此时大模型报告区域还是空白的。所以需要在顶部,你手动点一下“大模型分析”
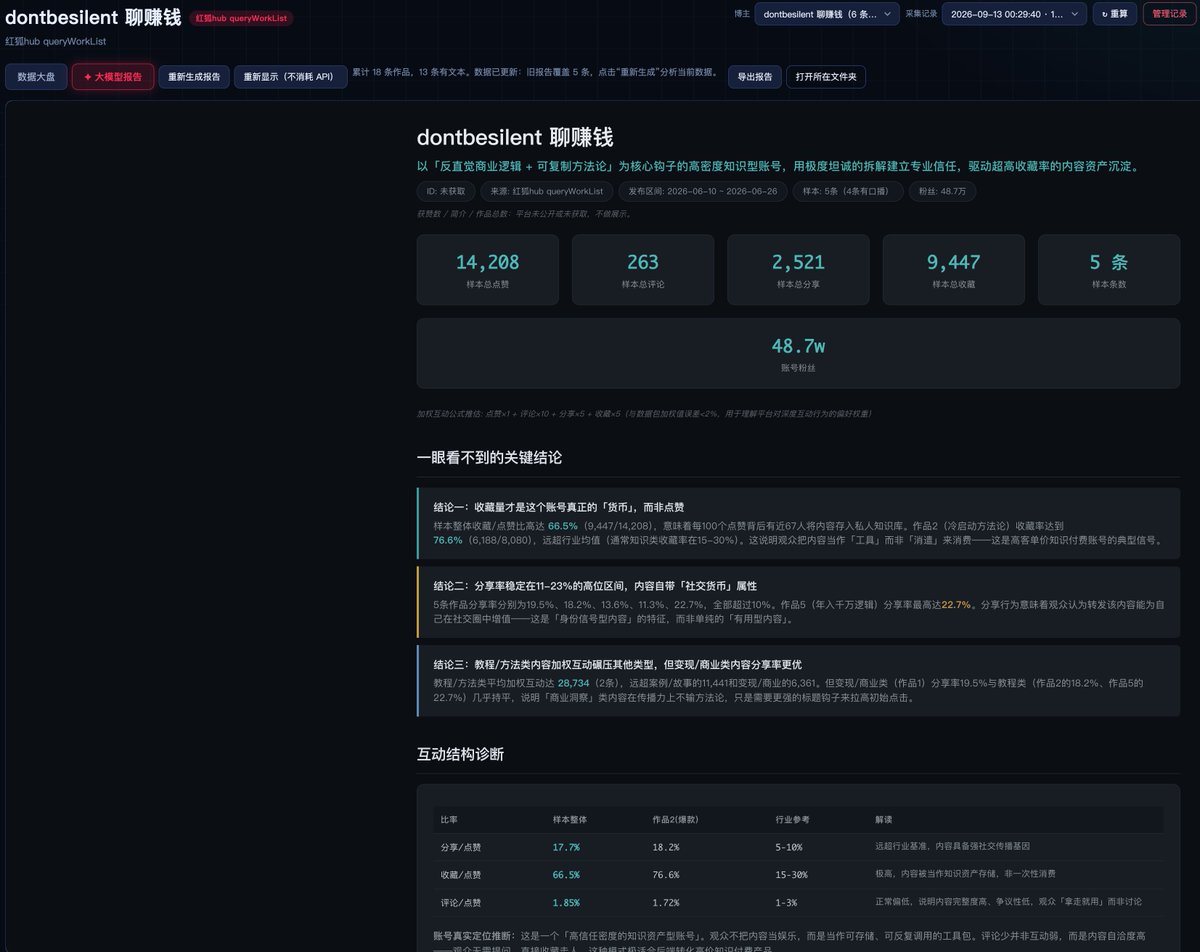
然后在大模型报告区域就可以看到详细内容了。
以后如果有再次下载的记录,你可以重新生成一次报告,让内容更为充分!
如果你认为自己绑的大模型不够聪明,在顶部我还设置了,复制给大模型,或导出 JSON 文档找个聪明的家伙(比如 GPT 和 CLaude)继续做分析,这是为了方便那些没有 API 的朋友。
内容比较多,我就不一一截图了!
这里我要重点说明一下,在顶部有个博主管理功能。
每次的采集都为一个记录,你可以切换不同博主,或不同记录看相关信息。
当然也可以删除某个博主的内容。
对当前数据不满意分析报告,可以点“重算”(有时候网络问题,或模型降智出来的内容确实有点傻)

中间的数据大盘信息,非常的明显,我就不做重点说明了。你可以对这位博主的所有内容都有个大概的判断,对与你分析对标竞品非常重要!

接下来,我们看一下内容明细这块区域:
这里就是采集回来的视频,进行了视频转文字的区域,我们可以按点赞数,评论,等各类数据进行排序,并且可以点击某篇内容打开详情。
比如下面我点击了某条点赞 8000 的视频,侧边栏会出现此条视频的相关数据。
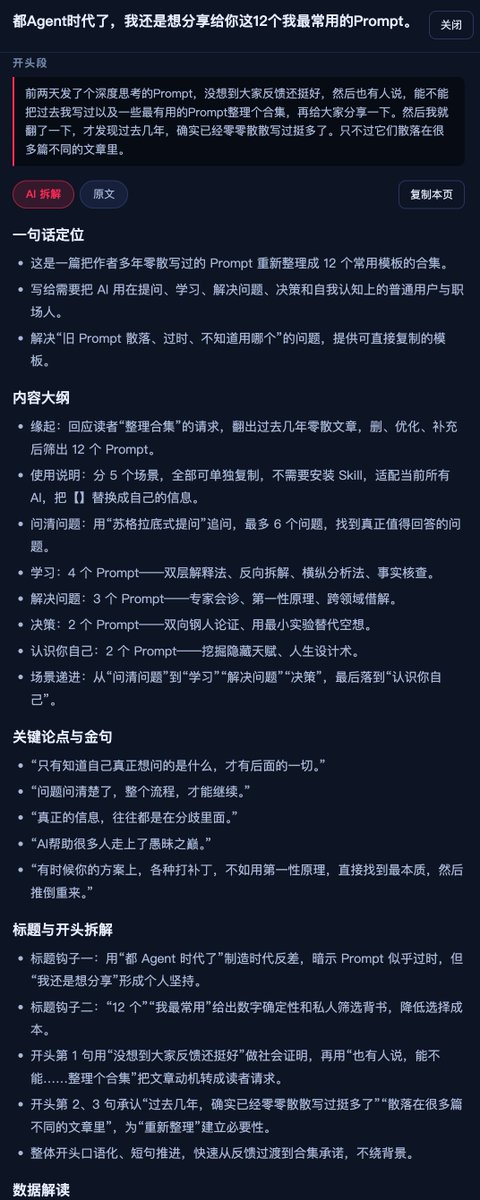
上面区域是详情,开头是钩子文案!
点击口播原文可以看到完整的口播文案。
第一次打开这个界面的时候是没有 AI 拆解内容的,需要你手动点击一下“『AI 拆解这篇』”功能,才可以让大模型来介入。
只要生成的内容,下次打开还是保存本地的。这对于你分析爆款视频的底层逻辑就相当的重要了。
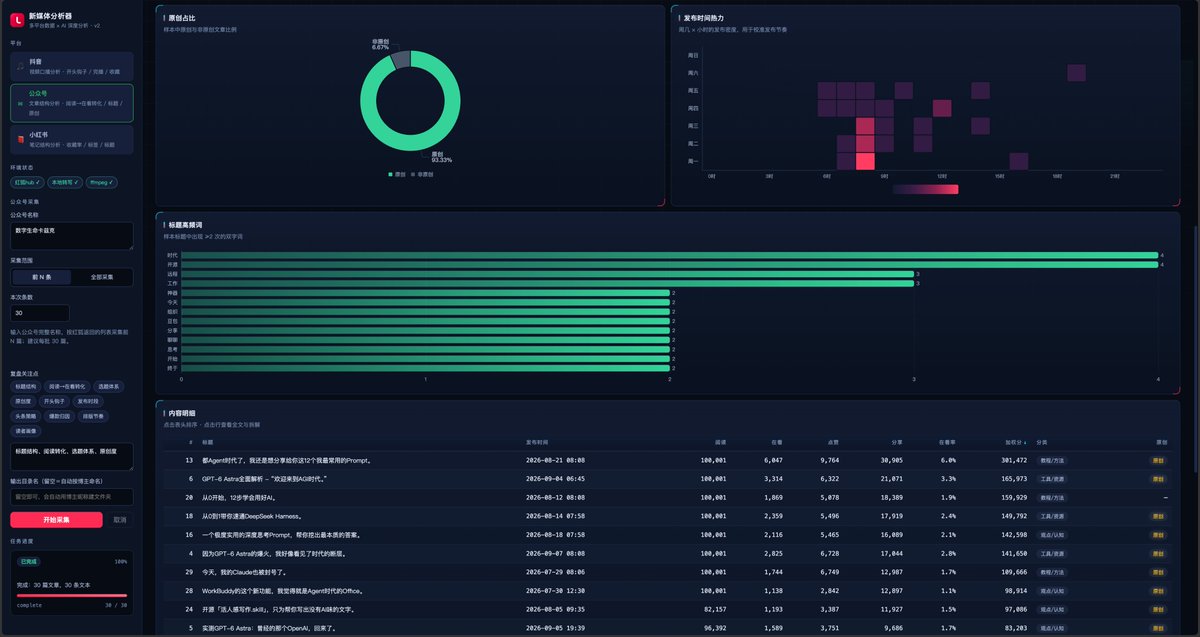
下面我来讲一下“公众号” 的采集方式,其它功能与抖音那里是一样的。
只是在采集时,这里面需要添加的是“公众号名称”,因为微信对链接的管控比较严,很多单篇文章链接来判断账号信息的方式,总是失败,所以我做成了按名字来查。
这里就不要输入一些小号的名字了,容易重复,尽量分析一下大号,不然也没有意义,对不?
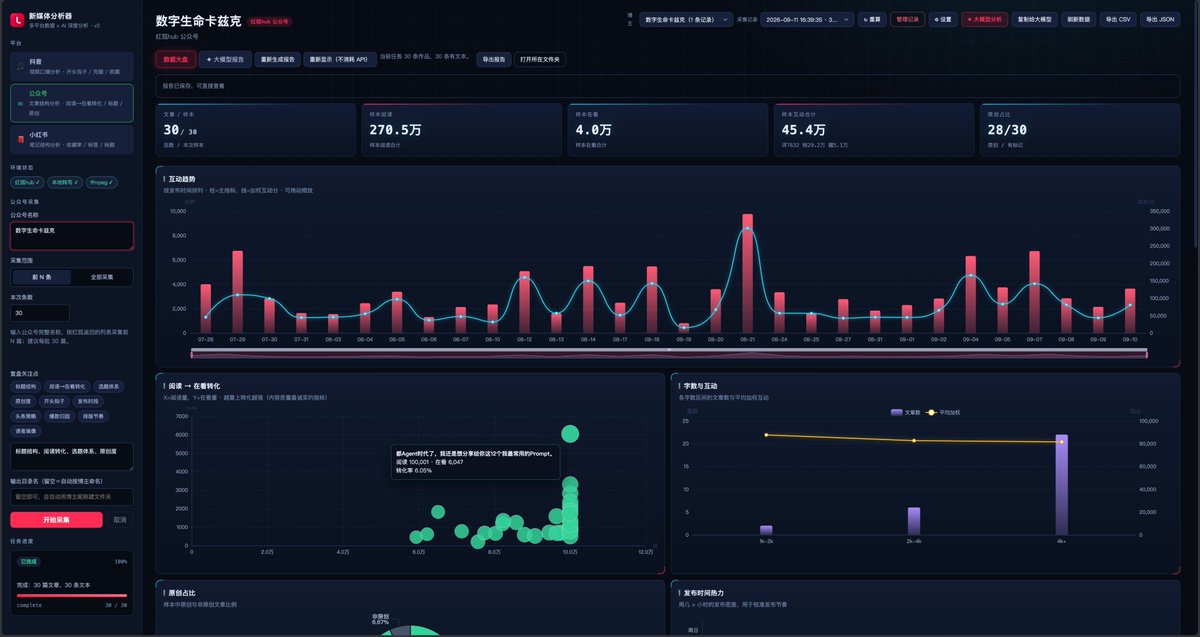
我这里拿“数字生命卡兹克” 的账号做一下演示。

可以看到他发布的时间多在早上七点到八点之间,原创占比 93%以上,“在看”转化率能最高达到 6%,真的是非常有意思的数据。
其它的详细内容,你们自行去看吧。公众号文章采到了本地,再让 AI 进行拆解分析,你就能知道这位博主的写作结构了。
这完全可以作为你以后写作的参考!
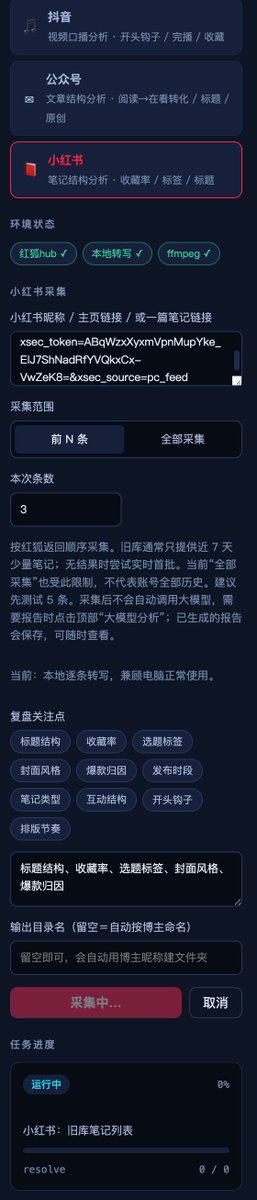
好,最后就是小红书了。我建议大家打开小红书的网页端,找到你要参考的博主主页,然后把他的主页地址复制上。
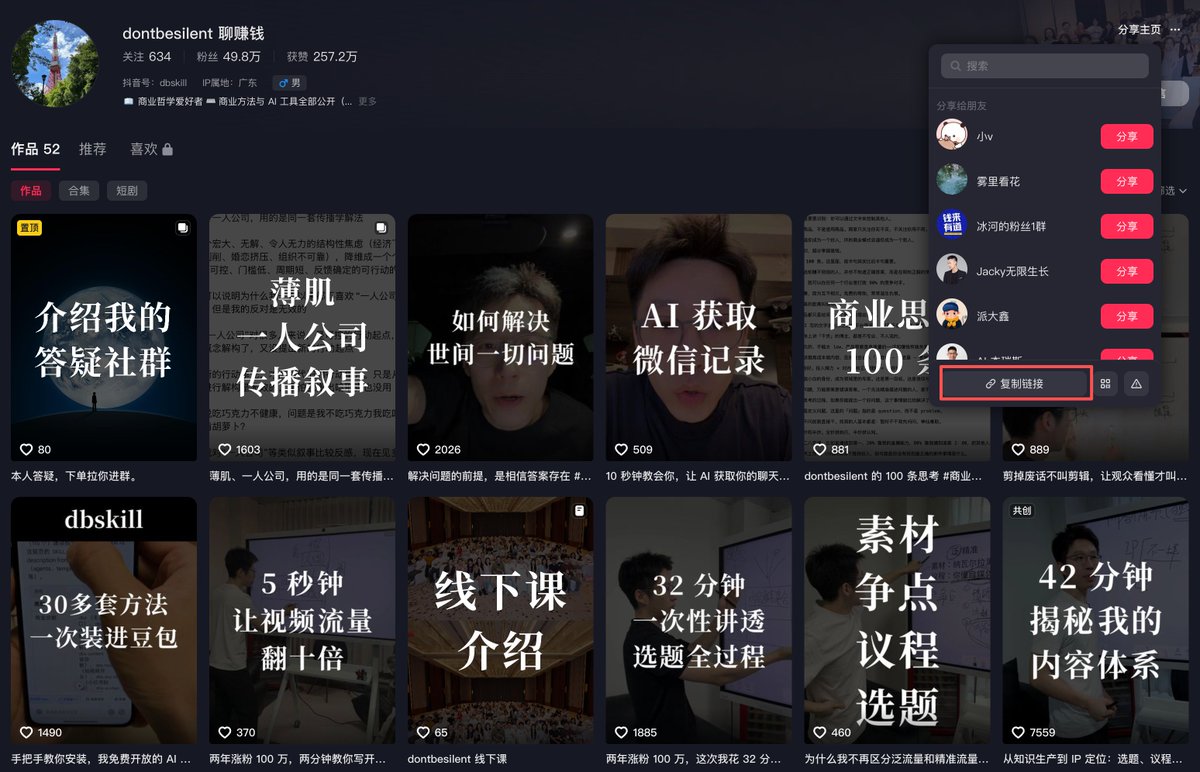
直接扔到我们采集输入框里,这样它会自行分析主页地址,开始下载视频,或图文。其实这里我个人建议,你还是找一些做视频的博主来采比较好。
全是图文的采回来,我也没做OCR 识图处理。只能对文案进行分析,意义不大。
其它的方法就一样啦。
我到时做个视频来讲解这个工具的实操注意细节,这里的图文只做简单的配置与事项说明。
这版本只做了三个平台,其实我还做了 B 站与油管的采集,只是还不完善没有放出来。记得到时去看有没有新版本更新。
“钱来有道”的会员们和推特上订阅用户,你们将得到第一时间的更新版本。到时记得和我要!
都看到结尾了,下载地址送上:https://github.com/binghe1980/new-media-analyzer
同时欢迎关注我的公众号:钱来有道 ,谢谢大家支持!
记的帮我点个小星星🌟,算是对我辛苦的鼓励啦!如果有使用问题,可以加我微信 psercn (加时注明:新媒体分析器)
今天就讲到这里,这是为你们做的!免费开源,请勿商用!对大家有帮助就不枉我的几个通宵了!
打完收工!下次再见!