知识库越建越乱?先让 AI 学会回答:这句话从哪来
收藏一篇教程只要一秒,等真要用的时候,可能半小时都找不到。更麻烦的是找到了,却不知道里面的步骤还适不适用。很多人的知识库,缺的就是这一层判断。
Karpathy 在“LLM Knowledge Bases”原帖里,分享了让大模型整理、维护个人知识的方向。这个思路很适合往日常资料管理上想。但轮到自己动手,第一件事最好小一点:先让十份资料变成有来源、能复查的笔记。原帖
下面这套是给普通使用者设计的起步方案,不要求你搭服务器,也不要求先学一堆数据库名词。只需要一个允许 AI 访问的项目文件夹,以及你准备整理的公开资料。
第一步,只选一个正在用的主题。
比如“我的短视频字幕流程”,或者“新手如何维护一个小网站”。先别把投资、育儿、英语、装修全部放进去。主题越具体,你越容易发现 AI 有没有把资料整理歪。
选十份材料就够了。每份写一句“为什么留它”:解决什么问题,可能在哪个环节用到。写不出来的先别放。这样做不是浪费时间,而是在帮自己确定知识库到底为谁服务。
第二步,把原始资料和整理结果分开。
建三个文件夹:sources 放原始材料及链接;notes 放整理后的主题笔记;inbox 放还没判断的内容。再建一个 index.md,写主题范围、入口和使用方法。这是本文建议的结构,名称可以按你的习惯调整。
Obsidian 的笔记本身保存在本地文件夹里,以 Markdown 文本为主,因此可以把这个文件夹作为资料入口,也能用其他文本编辑器查看。它只是可选的阅读界面。官方说明
先别追求漂亮的关系图。打开一条笔记,能知道它说了什么、什么时候核对过、证据在哪,就已经有价值。
第三步,统一每张知识卡的格式。
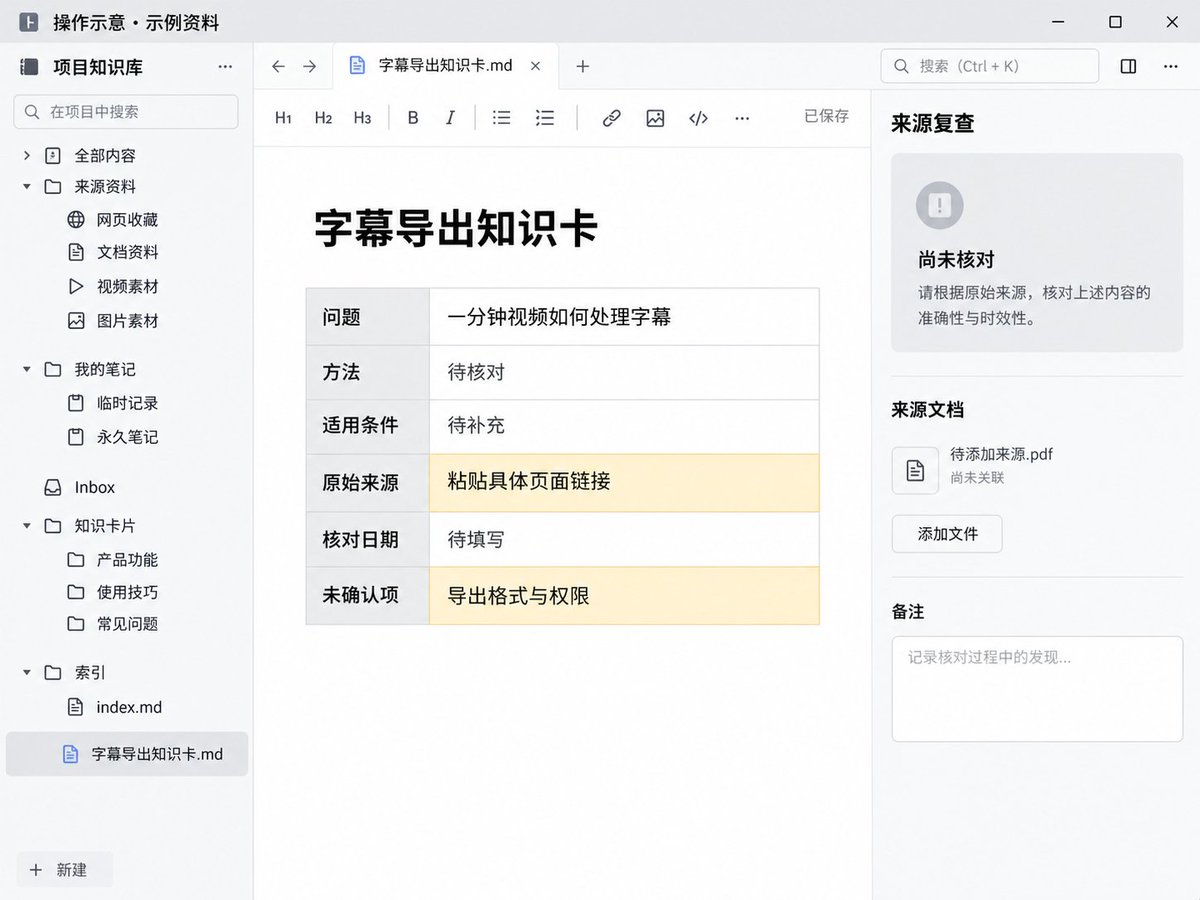
我建议只保留六项:要解决的问题;当前可用的方法;适用条件;原始来源;核对日期;仍不确定的地方。对工具教程,再多留一个版本或平台说明。
比如一条字幕笔记,不能只写“某工具支持导出”。要写清导出的是什么、在哪个平台看到、是否需要特定权限、有没有实际打开过文件。资料说支持,与自己操作验证过,是两种状态。
可复制模板见文末《知识卡整理模板》。
先处理两份,是为了检查格式和判断标准。一口气整理几百份,如果第一份就错了,后面只会生成更多需要返工的笔记。
第四步,用真正的问题验收。
别问“你读懂了吗”。问“我现在要做一分钟讲解视频,按现有资料应该先处理字幕还是先调整节奏?哪些资料支持,哪些条件还没确定?”
再追问:“这句话的证据在原文哪里?”如果只有一篇看似完整的回答,点不开来源,也分不清推断,先修笔记结构。知识库的意义要体现在这类具体问题上。
可以准备三道固定题:一个直接查询题,一个跨资料比较题,一个资料里没有答案的问题。最后那道尤其有用。好的结果应该明确缺信息,再告诉你补什么;不能为了显得聪明把空白填满。
第五步,设一道更新规则。
新资料和旧笔记冲突时,要求 AI 同时保留日期和条件,指出冲突点,等核对后再替换结论。不要让它默默把旧说法擦掉,不然你下次连哪里变了都不知道。
每周只检查一个小主题:链接是否还能打开,重复笔记是否可以合并,近期变化有没有影响原结论。临时聊天和未经证实的想法可以留在收件箱,确认以后再进入正式笔记。
还有一个容易忽略的边界:文件保存在本地,不代表使用云端模型整理时内容也一直留在本地。私人材料要按实际工具的数据处理方式决定能否交给它;密码、密钥、登录信息不放进知识库。
这个方案不承诺替代所有搜索系统。资料很多、多人共同维护或更新特别频繁时,会需要更完整的权限、检索和维护办法。先把自己的小范围问题回答准确,再决定是否加复杂度。
今天就可以拿十份收藏做一次练习。验收标准只有一句:下一次遇到同类问题,你能更快找到有出处、知道边界、看得懂的答案。
照着做:提示词与操作图
知识卡整理模板
请先读 index.md,按现有主题整理 sources 中的新资料。
每份资料先判断是否相关,
再提出新增或补充哪张笔记。
笔记必须保留可点击来源、发布日期或获取日期、
适用条件和未确认项。
把来源陈述与分析判断分开。
来源没说的内容不得补成事实。
先处理两份,展示结果后再继续。
zh'ge这个i操作示意:每张知识卡保留来源、核对日期和未确认项。示例界面用于说明整理结构。