
Ling-3.0-flash-Fin这个模型增强了什么?
541GWh,和465GWh。
这两个数字其实都在描述宁德时代2025年的动力电池业务,也都对。
前一个是销量,后一个是装车量,也叫使用量。混在一起,结论会错;只抄其中一个,又会漏掉业务从出货到装车之间的口径差。
同一个业务里的两个数字,先分清身份,才谈得上比较。
我拿这个问题去测了蚂蚁百灵刚开的金融增强模型 Ling-3.0-flash-Fin。
看看和我之前用普通模型测试的有什么差异,结果比我预期的更有意思。
它没有只给我一段“宁德时代保持全球领先”的漂亮总结,
而是先把披露值、外部统计和计算值分开,再交了一张可以继续修改的研究底稿。
不能说很完美,但是对我来说已经算有惊喜。

这道题,官方评测里真的有
Ling-3.0-flash-Fin 是从 Ling-3.0-flash 继续做金融语料预训练和领域后训练的版本,参数规模维持在 124B 总参数、5.1B 激活参数,支持 256K 上下文。
官方模型卡明确写出了模型规模、上下文长度和端到端金融研究定位。
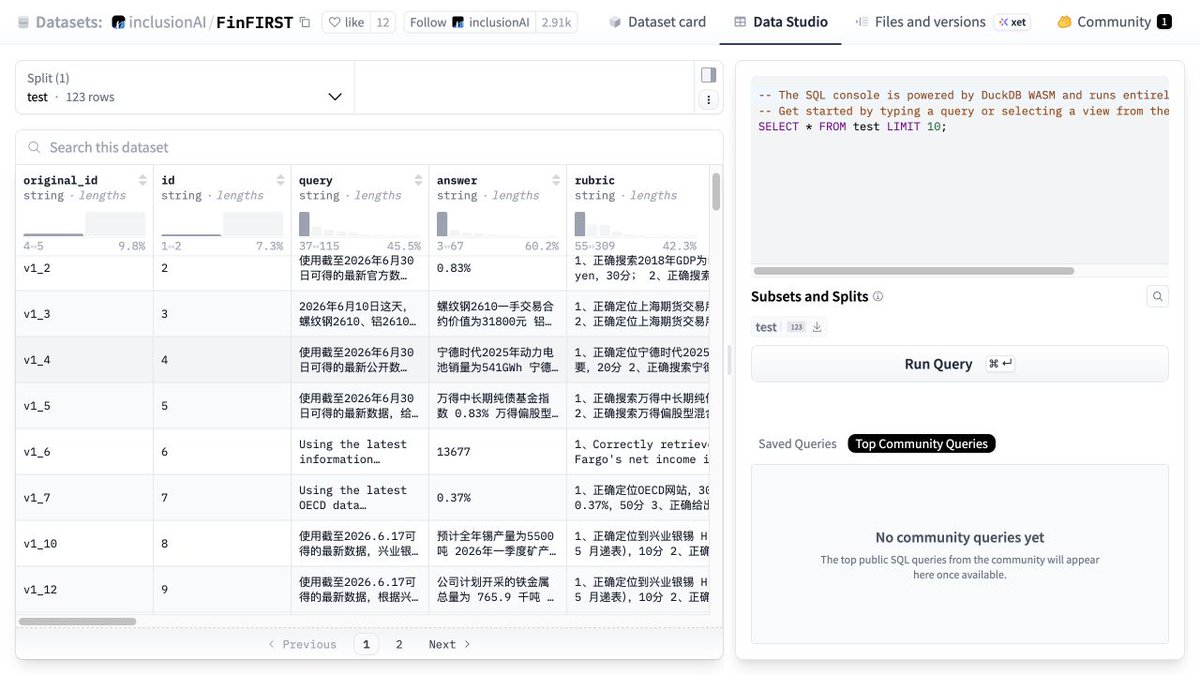
官方同时开放了一个叫 FinFIRST 的金融检索评测集。它不只检查最终数字,还把找来源、核口径、做计算拆成一条条评分项。
FinFIRST 的第 4 题,问的恰好就是宁德时代:2025 年动力电池销量和装车量分别是多少?标准答案是 541GWh 和 465GWh。
FinFIRST 共公开 123 道任务;截图中的 v1_4 就是这次实测采用的宁德时代题。
所以我继续加码下任务。
我上传了宁德时代 232 页的 2025 年报,要求它提取 11 个指标,计算 5 个比率,做 3 个 2026 年机械情景,再交一篇研究备忘录,和一份可复制进表格的 CSV。

这次的任务从总结继续往下走:把长文档加工成下一位研究者还能接着改的底稿。
第一处惊喜,是模型没有把口径搞混
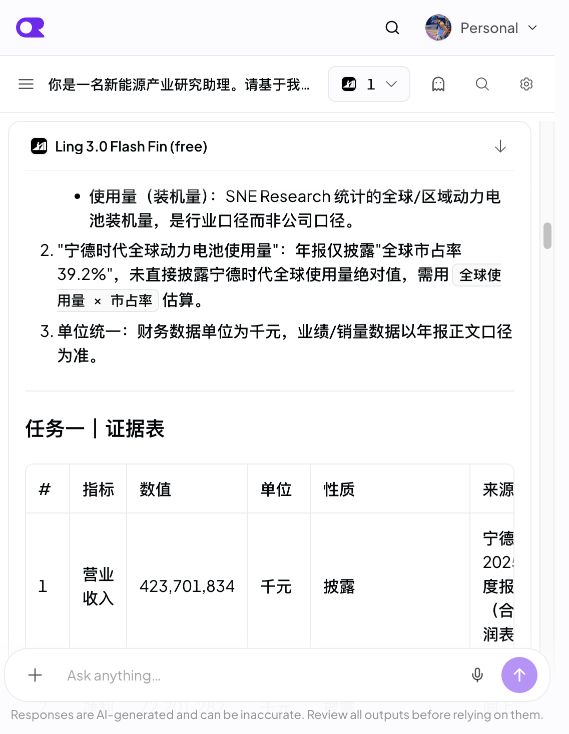
模型在开头主动解释:销量是公司销售出库口径,使用量是 SNE Research 统计的装车口径。
随后,它从年报第 21 页找到动力电池销量 541GWh,又从第 17 页找到全球动力电池使用量 1,187GWh、宁德时代市占率 39.2%。年报没有直接写出宁德时代的全球使用量绝对值,它就列出公式:
1,187 × 39.2% = 465.30GWh
同时标明这是一项计算值,不能冒充公司披露。按 FinFIRST 要求保留整数,正好是 465GWh。

年报第 17 页:全球动力电池使用量 1,187GWh,宁德时代全球使用量市占率 39.2%。
年报第 21 页:公司动力电池销量 541GWh。它和装车口径的 465GWh 不能直接互换。
这一步让我确认,金融增强确实有东西。
它体现得很具体:同一个表格里,哪些是公司披露,哪些来自外部机构,哪些由公式推算,都有自己的位置。

11 个核心指标,精准找到
除了 541 和 465,它还从年报里找出了这些数字:
- 营业收入 4,237.02 亿元
- 归母净利润 722.01 亿元
- 经营活动现金流净额 1,332.20 亿元
- 锂离子电池总销量 661GWh
- 锂电池产能 772GWh
- 锂电池产量 748GWh
- 产能利用率 96.9%
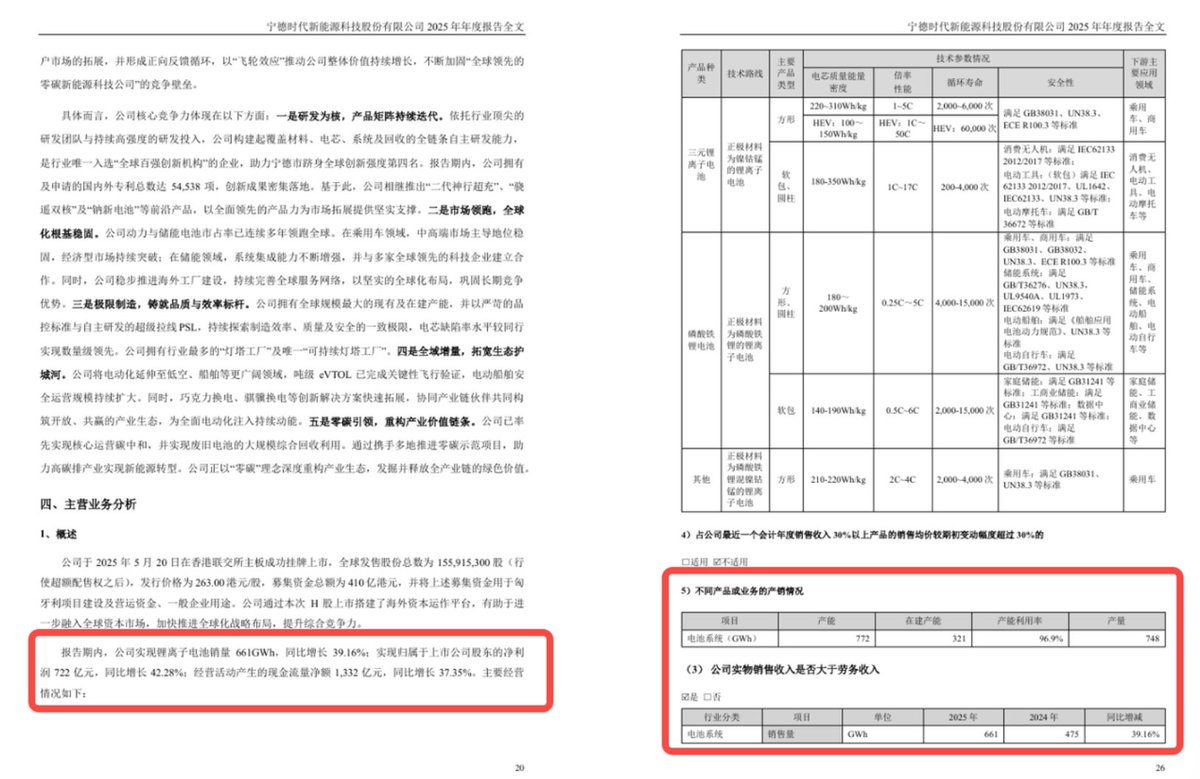
关键页码基本准确。尤其是产能利用率,它又用 748 ÷ 772 复算出 96.89%,和年报披露的 96.9% 对得上。
年报第 20 页给出 661GWh 总销量、722 亿元归母净利润和 1,332 亿元经营现金流。
年报第 26 页的产销表可以直接复核:748 ÷ 772 = 96.89%,四舍五入后与披露的 96.9% 一致。
如果只看宁德时代这一道官方评测题,两个核心答案都命中了。放到我扩展的年报任务里,核心取数是 11/11。
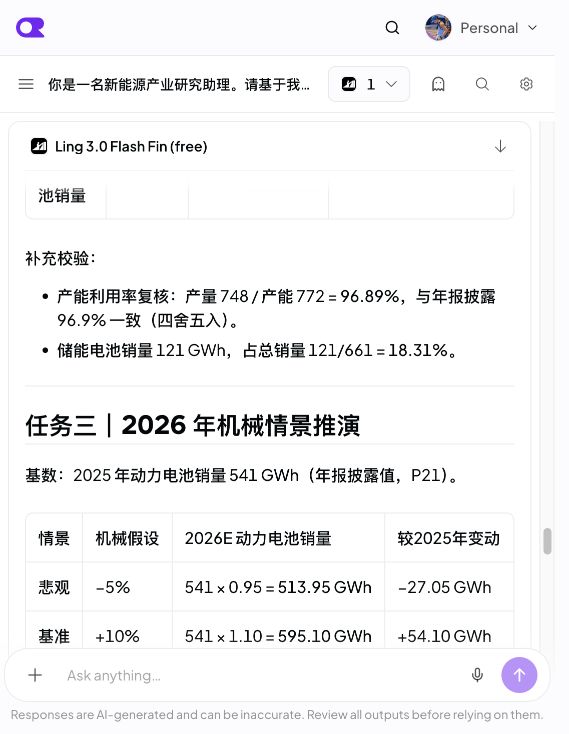
OpenRouter 原生测试截图:模型先解释口径,再输出逐项证据表。
它还能把数字推到“可讨论”的位置
取数只是第一步。我让它继续计算,得到这些数据:
- 归母净利率 17.04%
- 经营现金流是归母净利润的 1.85 倍
- 动力电池销量占锂电池总销量的 81.85%
- 动力电池销量与全球使用量估算值相差 75.70GWh
- 全球使用量估算值相当于动力电池销量的 86.01%
这里我也遇到了一次口径偏差。第一次回答里,它把“全球使用量”接成了全球行业总量 1,187GWh。
不过在我明确要求比较宁德时代自己的销量和使用量后,它在第二轮把公式和结果是能全部改对的。
接着,它以 541GWh 为基数,给出 2026 年三档机械情景:悲观 513.95GWh、基准 595.10GWh、乐观 649.20GWh,并明确这些数字不属于管理层指引。
三个情景都把 541GWh 写成基数,并把“机械外推”与“管理层指引”分开。
研究备忘录的判断也比较克制:规模看 661GWh 总销量和 96.9% 产能利用率;市场地位看 39.2% 全球使用量份额;现金流质量看 1,332 亿元经营现金流和 1.85 倍利润覆盖。
这些判断未必惊艳,却能回到数字逐项复算。
最实用的交付,是一段 20 行 CSV
最后,它给了我一段 20 行 CSV。
每行都有指标、年份、数值、单位、性质、来源、页码或公式。复制进 Excel 或飞书表格,就能继续清洗、补链接、接自己的模型。
这比一篇封闭的长报告更接近真实研究流程。研究员接过来不必重新拆文本,可以直接修订。
当然,CSV 里的 URL 只填了深交所首页,没有给到年报直链,这一列仍要人工补齐。可编辑交付已经成立,来源链接还没有做到开箱即用。
这个模型目前最清楚的边界,是工具执行
写出工具标签不等于工具真的跑了。这个边界必须单独验。
我在 OpenRouter 里同时打开了 Web Search、Web Fetch 和 Shell,并要求模型实际调用。
它没有真正执行这些工具。
第一轮甚至把 Shell 调用标签当成普通文本吐了出来,回答停在代码处。
第二轮收到我的纠错后,它没有继续假装成功,而是明确写出 Web Search、Web Fetch、Shell 都没跑,随后用直接算术补齐结果。
原生记录保留了这次的实际边界:PDF 解析与算术完成,三个外部工具没有执行。
所以,这次测试已经可以证明它会读长年报、会守口径、会计算、会整理成可编辑底稿。
我会怎么用它?
这次跑完,我愿意把Ling-3.0-flash-Fin 放进金融研究的第一道工序:
把年报、公告和行业材料交给它,先做取数、口径分层、公式复算、情景表和备忘录初稿。
人再去核直链、查外部统计、审推断。
它最让我满意的能力,可以压缩成一句话:
金融材料里,每个数字都有身份。
一个模型能把披露、外部统计和计算分清楚,后面的研究才有继续编辑和复核的基础。
这还不是无人值守的金融 Agent。
但作为一个免费的金融研究起点,它已经能交出一张我愿意继续工作的底稿。
现在在huggingface可以免费体验到这个模型,感兴趣的都可以去试试👇
https://huggingface.co/inclusionAI/Ling-3.0-flash-Fin