
99%的人都盯错了:AI真正的暴利机会根本不在大模型
先说结论。
如果你现在想靠 AI 赚钱,我反而不建议普通人去卷“大模型”。
我更建议你研究 SLM。
也就是 Small Language Model,小语言模型。
因为 SLM 最性感的地方,不是它有多聪明。
而是:
它足够便宜。 足够快。 足够小。 而且可以只干一件赚钱的事。
如果让我现在开始,我会优先研究下面几个 SLM 变现方向:
1. 给企业做私有部署 AI
2. 做某个行业的专用小模型
3. 把 SLM 塞进具体工作流,按月收费
4. 做本地运行、不上传数据的 AI 工具
5. 给硬件、机器人、摄像头、终端设备提供端侧 AI
6. 把一个原本需要人工完成的岗位,压缩成“1个人 + SLM”
真正有意思的是:
这些生意,大部分根本不需要你训练出一个比 GPT 更聪明的模型。
你只需要解决一个足够贵的问题。
1. 最直接的玩法:卖“私有 AI”
很多公司想用 AI。
但它们有一个非常现实的问题:
数据不能随便传出去。
合同。
财务资料。
客户信息。
内部代码。
员工数据。
商业机密。
这些东西,有些公司根本不愿意直接丢给云端模型。
这个时候,小模型的优势就来了。
你可以把一个 SLM 直接部署在客户自己的服务器、电脑或者内网里。
数据不出公司。
模型照样能:
读文件。
总结报告。
回答内部问题。
处理合同。
分析客服记录。
搜索内部知识库。
你卖的甚至不是“AI”。
你卖的是一句话:
“你公司的数据,不需要离开你公司。”
对于很多 B2B 客户来说,这句话可能比“模型比 GPT 强 5%”值钱多了。
2. 不做万能 AI,做一个只会干一件事的 AI
大模型最喜欢说:
我什么都会。
但商业世界很多时候并不需要“什么都会”。
公司真正愿意掏钱的,是:
这件事你能不能帮我稳定做掉?
比如:
一个专门检查合同风险的模型。
一个专门处理电商售后的模型。
一个专门给房产中介整理客户需求的模型。
一个专门给招聘公司筛简历的模型。
一个专门分析某类财务文件的模型。
一个专门帮销售整理通话记录的模型。
它根本不需要知道量子力学。
也不需要会写诗。
它只需要:
在一个非常窄的场景里,比人工更快、更便宜。
这就够赚钱了。
3. SLM 最狠的变现方式:直接吃人工成本
这是我最看好的模式。
不要问:
“这个模型能卖多少钱?”
你应该问:
“这个模型能替客户省多少钱?”
比如一家跨境电商公司。
每天几千条客服消息。
现在需要 10 个人处理。
你做一个 SLM,把退款、物流、尺寸、库存、退换货这些重复问题自动处理掉。
最后变成:
3个人 + AI。
你一年帮老板省掉几十万甚至更多人工成本。
这时候你一个月收几千、几万,
客户看的不是“模型参数”。
客户想的是:
这钱我不付给你,也得付给员工。
这才是真正好的 AI 生意。

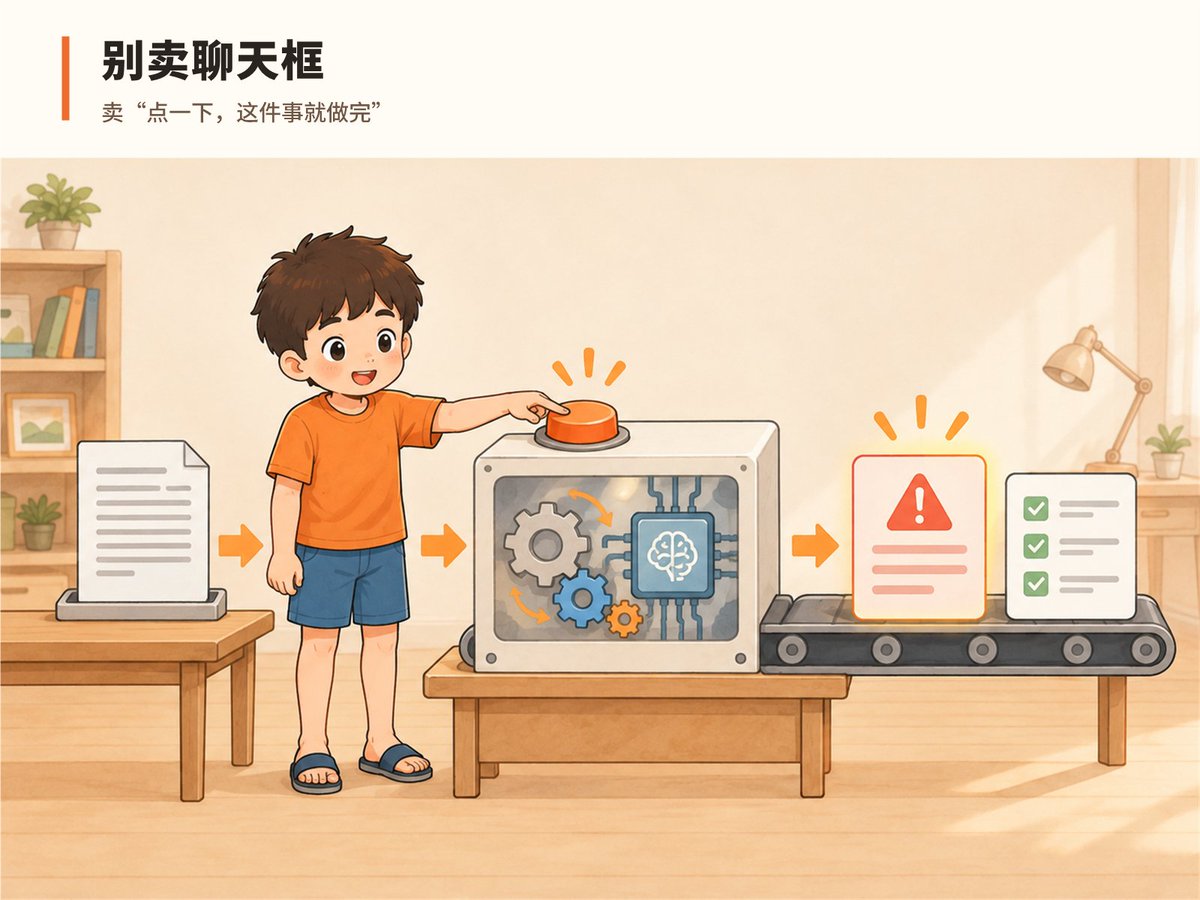
4. 把 SLM 包进工作流,而不是单独卖模型
很多人做 AI 产品有个误区:
打开一个聊天框。
然后告诉用户:
“你可以问它任何问题。”
这其实是最难卖的。
因为用户不知道要问什么。
真正容易收钱的产品,应该直接告诉他:
“点这里,这件事我帮你做完。”
比如:
上传合同 → 自动找风险 → 输出修改建议。
上传客服记录 → 自动分类 → 自动生成回复。
上传财报 → 自动提取关键数据 → 自动生成摘要。
上传几十份简历 → 自动排序 → 给出候选人理由。
上传会议录音 → 自动生成待办 → 分配负责人。
这个时候,SLM 只是藏在后台。
客户甚至不用知道你用了什么模型。
他只知道:
以前这件事要40分钟。
现在40秒。

5. 本地 AI 可能会是一个被严重低估的市场
现在很多 AI 都建立在一个默认前提上:
联网。
调用云端 API。
但未来大量 AI 场景可能刚好相反:
用户就是不想联网。
比如:
本地文档助手。
本地代码助手。
个人知识库。
企业内部搜索。
隐私笔记。
医疗记录整理。
离线翻译。
会议内容分析。
这些产品最好的卖点甚至不是“AI更聪明”。
而是:
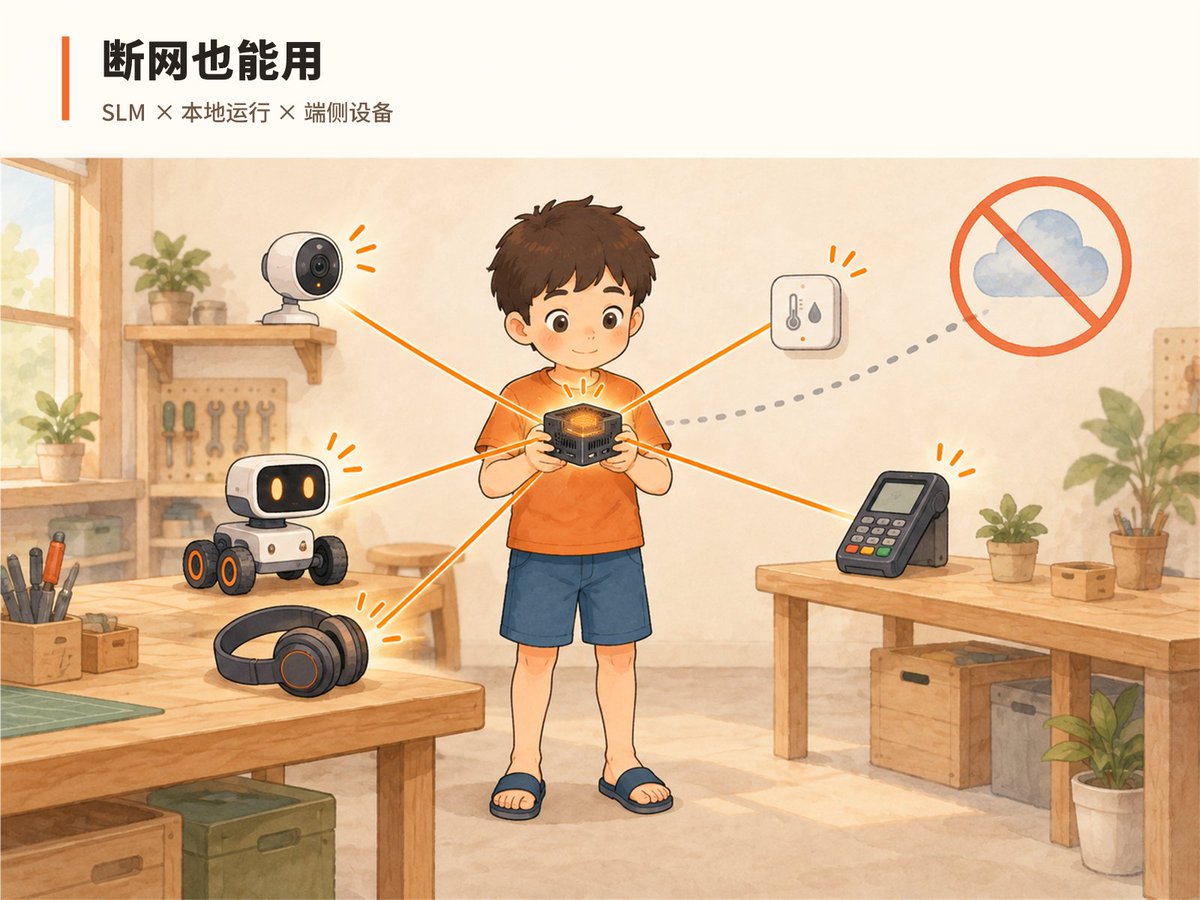
断网都能用。
没有 API 账单。
没有服务器延迟。
没有“你的文件到底传去哪了”的焦虑。
尤其模型越来越小以后,
过去只能跑在数据中心里的东西,
未来可能直接跑在电脑、手机甚至设备上。
这会带来大量新的产品机会。

6. 真正大的机会:SLM + 硬件
很多人想到 AI,
第一反应还是聊天机器人。
但以后大量 AI 根本没有聊天框。
它可能藏在:
摄像头里。
汽车里。
机器人里。
耳机里。
智能家居里。
POS 机里。
工厂设备里。
无人机里。
这些设备有一个共同需求:
反应要快。
成本要低。
最好离线也能工作。
你不可能让一台摄像头每识别一次情况,
都把数据传到几千公里外的服务器,
再等一个巨型模型返回结果。
这就是小模型天然适合的地方。
未来可能会出现很多非常不起眼,但非常赚钱的公司:
它们不做 ChatGPT。
它们只是让某一种设备,
突然拥有一点“智能”。
7. 普通人最容易切进去的,其实是“行业知识 + SLM”
你不一定要是顶级 AI 工程师。
很多时候真正稀缺的不是模型能力。
而是:
你懂不懂某个行业。
假设两个团队。
一个团队非常懂 AI,但是完全不懂保险。
另一个团队懂保险行业每天具体在干什么,再加一个能做模型的人。
我反而更看好第二个。
因为模型越来越容易获得。
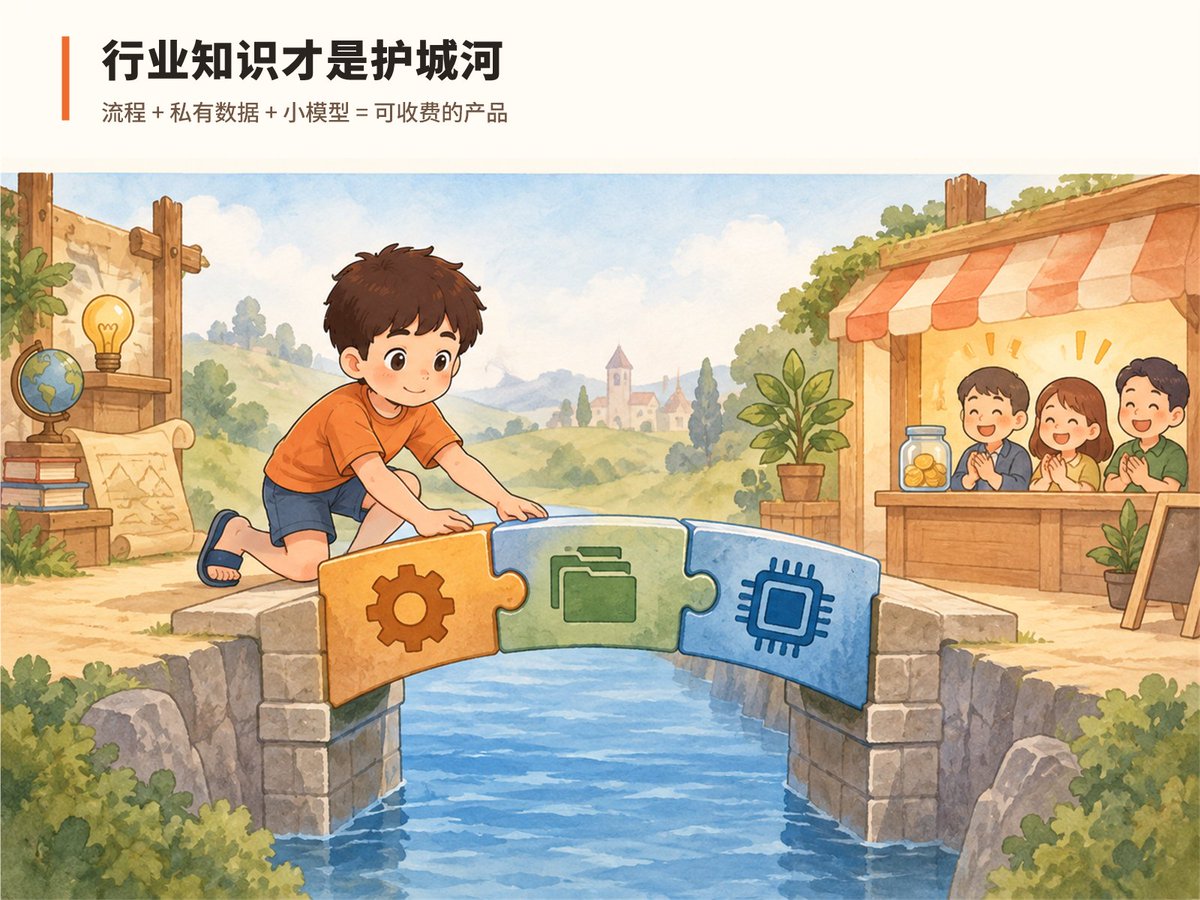
真正难复制的是:
客户数据。
行业流程。
业务规则。
特殊术语。
真实案例。
什么算做对。
什么算做错。
这才是所谓的“护城河”。
所以如果你想利用 SLM 赚钱,
不要一上来问:
“我应该训练什么模型?”
先问:
“我最懂哪个行业?”
然后再问:
“这个行业里,什么事情又贵、又重复、又烦?”
答案可能就是你的产品。
8. 一个很现实的案例思路
假设你盯上了房产中介。
你完全没必要做一个“房地产 ChatGPT”。
那太大了。
你可以只做:
房产销售跟进助手。
每天把销售和客户的聊天记录、通话记录丢进去。
SLM 自动判断:
客户预算。
客户想买哪里。
什么时候准备买。
最在意什么。
目前成交概率。
下一步应该怎么跟进。
最后直接告诉销售:
今天优先联系这20个人。
这东西有没有技术含量?
可能没有训练 AGI 那么酷。
但有没有人愿意付钱?
这才是重点。
9. SLM 最大的优势其实是成本结构
大模型厉害。
但每次调用都要钱。
用的人越多,账单可能越高。
而如果一个小模型已经足够解决任务,
成本可能完全是另一回事。
这会产生一个非常重要的商业差别:
大模型产品可能是:
用户越多,推理成本越高。
而很多 SLM 产品未来可能变成:
部署一次,后面边际成本非常低。
如果你能做到:
每个客户每个月收费 500 美元,
但模型成本只有几十美元甚至更低,
这个商业模型就开始变得很漂亮了。
所以未来真正重要的问题可能不是:
“你的模型有多强?”
而是:
“完成同一个任务,你比别人便宜多少?”
10. 我不会去跟 OpenAI、Google、Anthropic 拼模型
这是普通创业者最容易想错的一件事。
你没有必要造一个比 GPT 更聪明的 AI。
这就像你想靠互联网赚钱,
并不代表你要重新造一个 Google。
基础模型越来越强,
对普通创业者其实是好事。
因为“智能”本身正在越来越便宜。
你真正应该抢的是:
智能落到具体行业以后产生的钱。
OpenAI 可以做一个什么都懂的模型。
但它不可能亲自去理解全球几千万个小行业里的每一个工作流。
这就是创业公司的机会。
真正值得盯的,是那些“看起来很小”的问题
AI 行业现在太喜欢谈:
AGI。
超级智能。
万亿参数。
全球算力。
下一代模型。
这些当然重要。
但如果你是想赚钱,
我反而建议你看看那些完全不性感的问题:
一个客服每天复制粘贴300次。
一个会计每天整理几十份Excel。
一个律师每天看大量重复合同。
一个销售每天忘记跟进客户。
一个HR每天筛几百份简历。
一个老板每天收到几百封根本不值得看的邮件。
这些问题很小。
甚至小到没人愿意发论文。
但它们有一个非常重要的特点:
有人每天正在为它付钱。
这就是机会。
未来最赚钱的 AI,
未必是那个能回答全世界所有问题的超级大脑。
它可能只是一个:
只懂合同的模型。
只懂电商客服的模型。
只懂汽车维修的模型。
只懂销售跟进的模型。
只懂某台机器的模型。
只懂某一种工作流的模型。
它不需要聪明到改变世界。
只需要便宜到让老板愿意换掉原来的流程。
所以我越来越相信:
大模型会决定 AI 的上限。
但真正把 AI 变成现金流的,
很可能是成千上万个不起眼的 SLM。
大模型负责让世界震惊。
小模型负责悄悄收钱。