

彻底搞懂 Git Worktree:从底层原理、小白上手到 AI 时代的高阶实战指南
前几天我在 X 上发了一条讨论,问大家在现在的日常开发(尤其是借助 AI Coding / 多 Agent 并行)中,到底用不用 git worktree。
https://x.com/realchendahuang/status/2100285445825495169
https://worktrunk.dev/原本以为这是一个相对小众的 Git 进阶功能,没想到炸出了 140 多条深度回复和引用。
大家在评论区各抒己见:
有人视其为神器,有人搭出了全自动的 Agent 任务流水线;也有人直言“最佳实践是坚决不用”,或者一边用一边被磁盘暴涨和合并冲突搞得焦头烂额。
甚至有朋友顺手去翻了 DeepSeek Harness 的官方仓库提交记录,指出了多 Agent 并行开发在现实中留下的冲突痕迹。
大家争论的表象是一个命令行工具,但背后的本质其实是:
当 AI 把写代码的吞吐量放大数倍之后,我们该如何管理本地的开发环境、并发任务以及代码合并?
为了让所有开发者(哪怕是刚接触 Git 不久的新人)都能彻底搞懂这项技术,本文将从 Git Worktree 的底层原理、小白从零上手命令、实战痛点与避坑策略,一直讲到社区里沉淀出的神仙工作流与优秀开源工具,做一次完整的系统性梳理。
一、Git Worktree 的基本原理(小白也能看懂)
在学习任何工具之前,先搞清楚它的底层逻辑,用起来才不会心里发慌。
1. 传统的 Git 仓库是怎么工作的?
https://github.com/samzong/gmc平时我们用 Git,默认的结构是:一个仓库目录,对应一个工作区(Working Tree)。
- 你的项目根目录下有一个隐藏的 .git 文件夹,里面存着整个项目从第一天开始的所有分支、提交记录(Commit)、代码快照等核心数据。
- .git 外面的所有文件,就是你的“工作区”,也就是你肉眼看到、正在编辑器里敲代码的地方。
当你执行 git checkout feature 或者 git switch feature 切换分支时,Git 会做一件事:把工作区里的文件全部擦掉,替换成目标分支的文件。
这就带来了一个很经典的困境:
- 如果你当前的活干到一半,代码报错跑不通,突然来了一个紧急 Bug 要修;
- 或者你正在等一个耗时很长的测试跑完,但你想同时开个分支写点别的东西;
- 你就必须先执行 git stash 暂存当前未完成的代码,或者硬着头皮 git commit 一个乱七八糟的临时提交,然后再切分支。切回来的时候,又得重新恢复现场、重新安装依赖或重新编译。
2. Git Worktree 到底改变了什么?
Git 早在 2015 年的 2.5 版本就引入了 git worktree。它的核心思想极其纯粹:
同一个 .git 仓库数据,可以同时挂载多个独立的文件工作目录。
你可以把它理解为一个主仓库(Main Worktree)带了若干个“卫星分身”(Linked Worktree):
- 底层数据完全共享:项目的所有提交历史、分支指针、Blob 对象都在主目录的 .git 里,绝不会因为多开一个目录就多占一份几十上百兆的 Git 元数据。
- 文件目录完全独立:每个 Worktree 在磁盘上是一个完全平铺的独立文件夹。你在 A 目录切到 main 分支,在 B 目录切到 feature-1 分支,在 C 目录切到 hotfix 分支。
- 编辑器多开不打架:你可以用 VS Code / Cursor 同时打开这三个文件夹,它们互不干扰,完全不需要频繁 stash 和切换分支。
3. 底层实现:那个奇妙的 .git 文件
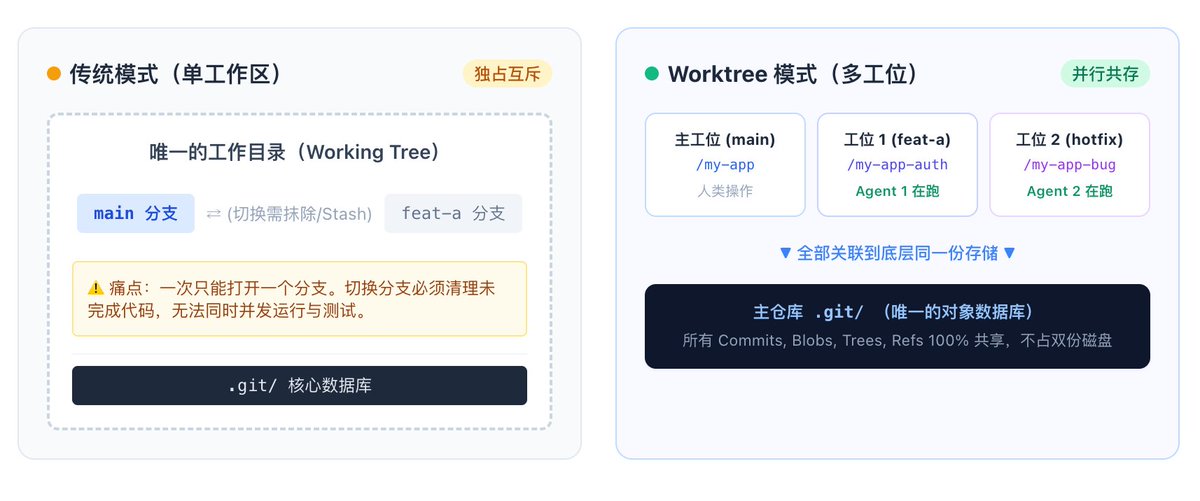
如果你好奇地钻进一个新建的 Worktree 目录看一眼,你会发现一个很精妙的设计:
- 在主项目目录里,.git 是一个装满了各种版本数据的文件夹。
- 但在新建的 Worktree 目录里,.git 居然只是一个小小的文本文件!
用文本编辑器打开这个 .git 文件,里面只有一行简短的内容:
gitdir: /path/to/main-project/.git/worktrees/feature-a
而在主仓库的 .git/worktrees/ 目录下,Git 为每个关联的 Worktree 建立了一个独立的子文件夹,用来单独记录该 Worktree 当前停在哪个 HEAD、索引缓存(Index)是什么。
这就是为什么它极其轻量——除了检出你在那个分支上的源码文件,几乎没有任何额外的版本库开销。
4. 一条铁律:禁止同一个分支被双开
Git Worktree 内部有一条不可逾越的规则:同一个本地分支,绝对不能同时在两个 Worktree 中检出(Checkout)。
这是为了防止逻辑灾难。如果两个目录都停在 main 分支上,A 目录提交了一个 Commit,B 目录也提交了一个 Commit,分支指针就会陷入分裂与死锁。因此,如果你尝试让新 Worktree 关联一个已经被占用的分支,Git 会直接报错拒绝。
二、小白从零上手:核心命令全生命周期指南
掌握 Git Worktree 不需要背复杂的参数,日常开发掌握下面这套生命周期就足够了。

1. 创建工作树(开工)
假设你的项目在 ~/code/my-app,你想基于主干切一个新功能分支 feat-auth:
推荐做法:在当前项目同级目录下创建新目录,并基于当前分支新建 feat-auth 分支 git worktree add ../my-app-auth -b feat-auth
执行后,你在 ~/code/ 目录下就会看到一个全新的 my-app-auth 文件夹。打开它,里面的代码已经停留在 feat-auth 分支上了。
如果分支已经在远端或者本地存在,直接指定分支名即可:
git worktree add ../my-app-hotfix hotfix-login
2. 查看当前有哪些工作树
开发久了,可能会忘记本地挂载了多少个 Worktree,用一行命令即可盘点:
git worktree list
输出会清晰地列出每个目录的绝对路径、当前指向的 Commit 哈希,以及关联的分支:
/Users/user/code/my-app 3f8a91b [main] /Users/user/code/my-app-auth 7b1c42e [feat-auth] /Users/user/code/my-app-hotfix 3f8a91b [hotfix-login]
3. 任务完成,删除工作树(收工)
分支合并完成后,不要直接在桌面右键扔进废纸篓。推荐使用 Git 自带的命令清理:
正常删除工作树目录,并注销主仓里的关联记录 git worktree remove ../my-app-auth
注意:如果该工作树内有未提交的修改,remove 会报错阻止,防止你手滑丢代码。如果确认不要了,可以追加 -f 强制删除。
4. 清理残留(修剪)
如果你或自动化脚本直接用 rm -rf 删掉了文件夹,主仓库的 .git/worktrees/ 里面还会残留无效的索引记录。此时只需在主仓执行:
git worktree prune
Git 会自动把那些目录已经不存在的无效记录一并扫除干净。
5. 进阶命令备忘
- 锁定防止被误删:如果某个 Worktree 放在移动硬盘或公共盘,为了防止被误 prune,可以加锁:git worktree lock ../my-app-auth --reason "长期测试分支" git worktree unlock ../my-app-auth
- 移动目录:如果你把某个 Worktree 目录重命名或移到了其他位置:git worktree move ../my-app-auth ../my-app-new-auth
三、为什么到了 AI 时代,大家突然都在聊它?
既然这个功能十年前就有了,为什么在 2026 年的 AI Coding 圈子突然成了热门话题?
核心原因就一句话:执行代码的主体,从一个人类,变成了多个并发的 Agent。
在过去,开发者写代码是单线程的。即使开着分支,也是人肉写完一个再切下一个。但现在大家的使用习惯变了:
- 模型需要思考时间:让 Claude 3.7 / Opus 或者推理模型跑一个较重的重构或 Feature,往往需要 5~15 分钟。如果只有一个工作区,人只能干坐着等。
- 多窗口 / 多会话并发:很多人在同一个项目里开了 3 个以上的终端窗口或会话,一个让 Claude Code 改前端,一个让 Codex 改后端 API,一个跑测试。
- 单目录灾难:如果所有 Agent 都在同一个目录下跑,很快就会发生灾难:Agent A 刚改了一半的组件,被 Agent B 当成未定义错误强行覆盖;环境里的锁文件被互相冲刷;最后两个 Agent 互相把对方的代码当成幻觉来修,产生巨大的冲突和 Token 浪费。
于是,Worktree 成为了大家在单机上为不同 Agent 划分“物理隔离工位”最自然的手段。
四、评论区集中踩坑:四大痛点与实战解法
很多开发者刚兴冲冲上手 Worktree,很快就会被各种实际问题浇一头冷水。这 140 多条评论里,最宝贵的就是大家用真金白银和时间踩出来的坑:
痛点 1:代码隔离了,但运行环境在裸奔
现象:
- 新开的 Worktree 进去一跑,报各种配置缺失。因为 .env 等敏感配置文件通常在 .gitignore 里,Git Worktree 根本不会把未追踪的文件拷贝过去(@star_cubez)。
- 两个 Worktree 同时启动本地开发服务器,默认端口(比如 3000、8080)当场撞车,服务起不来(@hx0000001)。
- 两个 Worktree 连了同一个本地 SQLite 数据库或同一个 Docker 实例,A 跑数据库 Migration,B 跑测试写脏数据,直接打架。
实操解法:
- 软链接核心配置:编写简单的启动脚本,新建 Worktree 时自动执行软链接:ln -s /path/to/main/.env .env
- 端口动态偏移:根据目录名或 Worktree 编号,在启动脚本里自动注入环境变量,分配不冲突的端口(如 PORT=3001)。
痛点 2:磁盘空间雪崩(尤其前端与 Rust)
现象:
- 很多朋友吐槽“让本不富裕的硬盘空间雪上加霜”(@murongg_)。
- 前端项目:每个 Worktree 都执行一次 npm install,几百 MB 的 node_modules 就复制了一份。开 5 个工位,几个 G 就没了。
- Rust / C++ 项目更惨:Rust 的编译产物目录 target 极其庞大,几个 Worktree 开下来,几百 G 空间直接被吃光(@jgbingzi, @lihang4work)。
实操解法:
- 前端使用 pnpm 或软链:使用 pnpm,所有依赖全局基于硬链接共享 Store,多个 Worktree 几乎不额外消耗物理空间; 或者直接通过脚本将主仓的 node_modules 软链接进新目录(@dlzhou2)。
- Rust 共享编译缓存: 在环境变量中指定统一的构建目录,避免每个 Worktree 各自生成全套编译产物:export CARGO_TARGET_DIR=~/.cargo-shared-target
- 及时销毁与定期修剪:养成收尾习惯,合并后立刻执行 git worktree remove,避免废弃目录堆积。
痛点 3:任务拆分不良导致的“合并地狱”
现象:
- 很多开发者发现:“多开了几个 Worktree 让 Agent 去写,结果合代码花的时间比写代码还长。”
- 评论区 @cxjwin 提到一个经典证据:去翻 DeepSeek Harness 的官方仓库,能看到大量 Commit 都在解冲突,这正是多 Agent 并行开发留下的典型痕迹。
- 评论区 @tootoocvc 总结得极为深刻:“谁提交快谁就不用合并,这会把合并键变成赛跑奖品。”
实操解法:
- 先拆任务,后开工位:并发的前提是高内聚、低耦合。如果两个任务要改同一张数据库表、同一个公共工具类,坚决不要并行,老老实实串行推进(@Jevik_AI, @dlzhou2)。
- 守住单一合并权:分支可以开多个由 Agent 狂飙,但合并主干必须由人类亲自审核,或者指定唯一的调度 Agent 排队合并、逐一 Rebase 跑集成测试(@tootoocvc, @ysj_aaron)。
痛点 4:瓶颈向后转移——机器跑死了,人脑看花了
现象:
- 写代码的速度变成了无限,但本地硬件跟不上了。同时起 3 个 Worktree 跑 Playwright 自动化测试或开模拟器,电脑直接卡死,风扇起飞(@yu_weikang86616, @geniusvczh)。
- 多个 Agent 几分钟内丢过来 3 个大 PR,人脑根本来不及 Review,最终只能盲目合入,埋下一堆隐患(@Mr_Sibei, @ElazerWang)。
实操解法:
- 控制并发数量(单兵作战建议同时并发不超过 2~3 个);
- 人类专注于架构设计、任务拆解与终审验收,不要盲目追求开工数量。
五、社区精选:优秀开源工具与神仙工作流
在这次讨论中,不少高阶玩家分享了他们自研或正在使用的利器与工作流,非常值得大家借鉴。
1. 专门为 AI/并发打造的开源 CLI 工具
工具一:worktrunk(Rust 编写的现代化 Worktree 管理器)
- 官网 / 仓库:worktrunk.dev(由 @roylee0x 推荐)
- 核心亮点:将复杂的目录操作抽象为极简的 wt 命令,直接通过分支名或 PR 编号切工作区(如 wt switch feature-a、wt switch pr:12); 自带自动化钩子(Automation Hooks):支持在创建 Worktree 时自动触发脚本,比如通过 .worktreeinclude 自动复制 .env、自动执行依赖安装; 一键集成合并:提供 wt merge 命令,在当前 Worktree 即可把代码合入目标分支并自动完成后续清理。
工具二:gmc(为 AI Coding 时代定制的 Git 工作流工具)
- GitHub 仓库:samzong/gmc(由作者 @samzong 分享)
- 核心亮点:多工位一键裂变:gmc wt dup 3,一行命令直接为主项目批量生成 3 个平行的 Agent 专属工作区; 资源共享管理:内置 gmc wt share add .env 和 gmc wt share add node_modules,自动在各个 Worktree 之间配置环境共享,直击最大痛点; AI Commit 集成:支持根据 Git Staged 差异自动生成规范的提交信息。
2. 评论区验证过的优质工作法
工作法 A:“固定 8 工位数”轮转法(@sjdhoome 强烈推荐)
这是针对个人开发者心智负担最小、最优雅的实践:
- 核心思路:不为临时需求频繁新建和删除目录。而是在本地长期常驻 8 个固定编号的分支与 Worktree(例如 worker-1 到 worker-8),全部跟踪主干。
- 运转流程:来新活时,挑一个空闲的 worker-N 目录,开 Claude Code 开始写; 写完测试通过,提 PR 合并回主干; 在该目录下执行一次 git rebase origin/main,这个工位瞬间恢复为最新、干净的状态,等待下一个任务。
- 巨大优势:彻底告别频繁增删目录的琐碎感,node_modules 等大依赖只需装一次,长期复用,省时省力。
工作法 B:Monorepo 子项目常驻工位(@yu5454)
- 对于 Monorepo,为仓库下的每一个核心业务子项目分配一个固定的长期 Worktree,主目录仅用来处理公共基础设施与依赖;
- 每个 Worktree 相当于对主干的长期本地 Fork,各自只专注于自己的业务域,做完后提 PR 回主干。
工作法 C:看板驱动的全自动任务工厂
- Issue 自动派工(@shukebeta / @zoomq / @buaaxhm): 通过 Linear 或 GitHub Issues 管理需求。定时任务扫到待办 Issue 后,调用脚本(例如 @zoomq 的 /mana run #IssueID),Agent 自动建分支、开 Worktree、读取上下文编写代码、跑测试、提 PR,最后自动合入并清理现场。
- 元仓库 Wiki 架构(@shenxianovo): 建立一个 Root 根目录,里面维护面向 LLM 的系统知识与任务 Wiki;所有代码仓放在 repos/,每次开发在 .worktree/<task> 下开辟空间,开发进度与上下文统一回写根目录 Wiki,做到条理极度清晰。
六、终局思考与选型建议
在讨论的后半段,有技术敏锐的朋友提出了一个发人深省的观点(@siyryu):
“Worktree 只解决了代码并行的文件隔离,并没有解决环境隔离。远程沙盒(Remote Sandbox / Orbs)终会替代 Worktree。”
仔细推敲确实如此: 本地 Git Worktree,本质上是我们在单机算力与本地文件系统约束下,做出的一种性价比折中方案。 随着云端沙盒(比如 GitHub Codespaces、Daytona、Amp Orbs)的成本逐渐降低、延迟做到底层无感,未来的终局大概率是:每一个任务由 Agent 在云端拉起一个干净、带完整网络与数据库的容器,跑完测试自动销毁,开发者本地甚至不需要承担任何编译与硬盘压力。
但在云端沙盒真正普及、成本打到白菜价之前,本地 Git Worktree 依然是现阶段防范多个 Agent 互相打架、提升单兵作战效率最实用的手段。
给开发者的最终建议:
- 项目小、逻辑简单、或者单人探索期:坚决不用 Worktree,单分支或常规分支依然是心智负担最低的选择。
- 多 Agent 协作、中大型项目多需求推进:强烈推荐使用 “固定工位轮转法”,或者搭配 gmc / worktrunk 做好 .env 和依赖共享。
- 永远记住:能拉开效率差距的不是你开了多少个工位,而是你有没有能力把复杂的大任务,拆解成互不干扰的原子化小任务。